La disponibilité de grands ensembles de données textuelles riches, créés principalement à partir de contenu web, a été un facteur important dans l'extraction de données avec des algorithmes ou des méthodes d'autoapprentissage à des prix sans précédent. Cela a suscité un grand intérêt pour la recherche d'apprentissage automatique pour l'analyse textuelle Aggarwal ( 2018 ). Aujourd'hui, l'extraction de texte Srivastava et Sahami ( 2009 ) et le traitement du langage naturel (PLN) Eisenstein 2019 ) constituent la base d'un grand nombre de ces études et mises en oeuvre.
5.1 Présentation
DATASET-TH-001 C et Krötzsch ( 2014 ) est un exemple d'une source de données structurée et libre d'accès qui s'appuie sur des informations extraites de DATASET-TH-001 en plusieurs langues. Les informations obtenues à partir des articles DATASET-TH-001 ont fait l'objet d'un processus de notation sémantique pour étendre la base de connaissances DATASET-TH-001 suivre un modèle graphique de données structurées pour intégrer de nouvelles applications.
L'un de ces domaines est l'identification des sexes dans le texte. L'objectif est d'attribuer une étiquette de genre (par exemple, « féminine et masculine ») à une zone de texte en utilisant des propriétés linguistiques ou d'autres caractéristiques descriptives. En général, les recherches antérieures ont porté sur l'identification du sexe et du profil d'une personne qui rédige son texte. Parmi les exemples, on peut citer l'identification par sexe des auteurs de blogs Yan et Y ( 2006 ) et microblogging
Mukherjee et Bala ( 2017 ) ou aux utilisateurs des systèmes de gestion des relations avec les clients (CRM) Amado et al. 2018 ).
La création de nouvelles contributions de DATASET-TH-001 et des données structurées dans les articles DATASET-TH-001 pour compléter tous les sujets. Par exemple, si nous devons récupérer des données structurées sur "Gabriel García Márquez et ont été DATASET-TH-001 l'entrée correspondante 2. Ensuite, nous pouvons explorer plusieurs domaines avec des caractéristiques descriptives sur cette personne, y compris "sexe ou sexe. 3. Dans cet exemple, la valeur de cette propriété est « masculine ». Au moment de la rédaction de cet article, comment des informations précises peuvent être 6 référence à différents articles DATASET-TH-001 qui soutiennent la dévolution des "hommes"a
Ce champ utilise des données structurées. Néanmoins, en tant que projet ouvert pour la création collaborative de connaissances DATASET-TH-001 ont souvent souffert de vandalisme et d'attaques avec Adler et coll. ( 2011 ); Geiger et Ribes ( 2010 ). Si des agents malveillants ont modifié les données structurées originales de DATASET-TH-001, détecter des erreurs sans inspection manuelle serait une tâche complexe et plus encore compte tenu de la grande taille de sa base de données DATASET-TH-001. En outre, s'il n'y a pas d'information structurée sur le genre dans un article de DATASET-TH-001, il serait impossible d'attribuer directement une valeur à la propriété "genre ou sexe" pour son entrée dans DATASET-TH-001 Ces informations sont communiquées à la Commission lors de sa première réunion. Au lieu de cela, pour qualifier l'information sur le genre comme une analyse automatique des données textuelles qui n'ont pas été structurées dans l'organisme DATASET-TH-001 Elle pourrait améliorer la résilience face à ces défis. Cet exemple peut facilement être extrapolé à tout autre système d'information qui devrait automatiquement inscrire le contenu d'un bloc de texte avec une étiquette de genre.
Nous nous sommes concentrés sur un cas précis, le problème de déterminer automatiquement son sexe tel que décrit dans le texte biographique. Pour le reste de ce travail, nous discuterons de ce problème en tant qu'identification de genre. En raison de l'absence d'études dans des langues autres que l'anglais, il est difficile d'élaborer de nouvelles procédures d'extraction de texte afin de mieux résoudre ce problème. Au lieu de se concentrer exclusivement sur l'anglais, avec moins d'éléments de genre, nous avons examiné l'utilisation du texte espagnol pour capturer les morphèmes qui portent des informations sur le genre et sont plus courants dans cette langue. Pour ce faire, nous éviterons des étapes régulières de normalisation dans l'extraction de textes traditionnels tels que les dérivés et la lématisation d'Eisenstein ( 2019 ), puisqu'ils excluent l'information sur le genre en termes linguistiques. C'est ainsi que nous avons montré qu'une valeur de genre peut être attribuée au contenu textuel avec plus de précision.
Lors du traitement du texte à l'aide de technologies d'apprentissage automatique, il est généralement utile.
2 [LINK-REDACTED] 3 [LINK-REDACTED]
Conduire des performances vectorielles avec une grande dimension et dispersion car elles contiennent de nombreux composants de valeur zéro. Dans un environnement de diffusion de représentations haute dimension, MOguerza et al. (SVM) 2006 ) sont des Jocachims appropriés au calcul ( 2002 ). Néanmoins, l'adaptation des technologies traditionnelles de résolution de problèmes d'optimisation pour SVM Joachims ( 1999 ) appliquée à l'identification de genre ne garantit pas une convergence rapide car l'itération approche une solution optimale de son problème d'optimisation sous-jacent.
5.2 Proposition
Dans cette section, dans le cadre du SVM, nous utilisons des propriétés géométriques d'une tâche d'identification par genre de texte pour modifier le critère d'arrêt d'un algorithme d'optimisation sous-jacent en remplaçant Karush- Kuhn-Tucker Feng et Li ( 2018 ) par une nouvelle proposition, qui intègre l'information (le taux d'erreur) Ce n'est pas directement lié mathématiquement à un critère que l'algorithme d'optimisation classique SVM tente de remplir car il peut potentiellement adapter sa nature et le problème géométrique résoudre. ci-après appelé ce SVM modifié comme Géométrie (GLVM). Pour évaluer la performance de cette nouvelle approche, ces propositions sont comparées avec d'autres méthodes de surveillance Wittan et al ( 2017 ) pour l'identification automatique du genre dans les textes biographiques des auteurs littéraires extraits de DATASET-TH-001. On évaluera s'il faut éviter le passage commun de la lématisation dans l'extraction de texte, ce qui supprime les supix selon le sexe avec des mots importants pour la rédaction d'analyses et améliore les performances en matière d'identification par sexe. L'efficacité de l'approche GSVM pour accélérer la phase de formation d'un algorithme est également démontrée et montre que cette méthode n'affecte pas significativement les performances de la procédure.
5.2.1 Critère d'arrêt géométrique
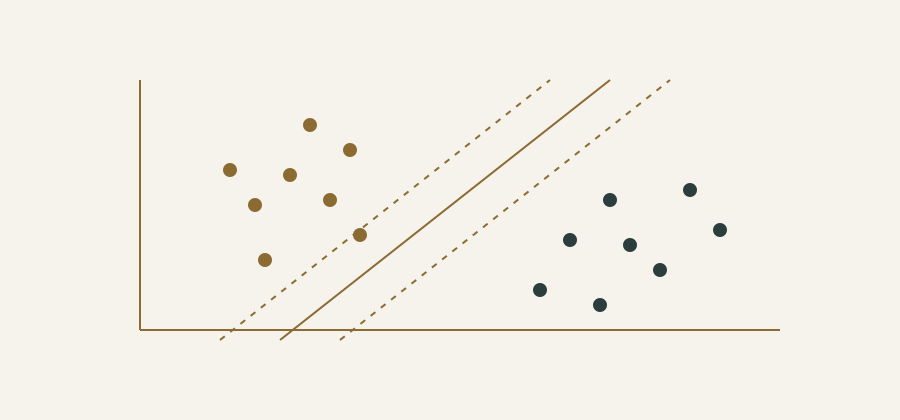
La géométrie de la fonction de décision SVM liée aux données de formation est quantifiable dans chaque itération en mesurant ou en estimant le taux d'erreur. Autrement dit, lorsque ce taux d'erreur stabilise la fonction de prise de décision, il répond aux critères de classification efficace des données. Le chiffre 5.1 montre un exemple avec deux nuages gaussiens multidimensionnels. L'exécution d'un SVM jusqu'à l'itération 2 production de la surface de séparation représentée par la figure 5.1 un temps Figure 5.1 b indique la zone de séparation calculée jusqu ' à l ' itération 18. La fonction de décision du chiffre 5.1 a fournit la même erreur empirique que la fonction de décision numérique 5.1 b) qui nécessitaient plus d ' itérations et
Ainsi, plus de temps de formation pour sa construction. Au lieu de cela, la construction de la fonction de prise de décision dans la figure 5.1 a Il avait besoin de moins d'itérations de formation.
a) Le SVM fonctionne jusqu ' à l ' itération 2 b) SVM fonctionner jusqu ' à l ' itération 18
Graphique 5.1 Deux surfaces de séparation avec SVM: a) surface de dégagement obtenue après 2 b) zone de séparation calculée après 18 des itérations.
Sur la base de ces bases, nous définissons εk comme le taux d'erreur pour la formation définie à l'itération K et φ > 0 comme une véritable valeur qui agit avec tolérance. Selon ( 2.3 ),
N X
εk = 1
g
i = 1 ( 1 − yi f (xi) et 5.1 )
La mer est de 1 kg = 1 kg 124 εks − httg ~ 5 |. La méthode doit être arrêtée après que les conditions suivantes ont été remplies:
(-) (-) (-) 5 [pose ()} 15 [pose g)] 100 ε), ( 5.2 )
où le symbole ") "dénote un opérateur logique et, c'est-à-dire avec les quatre inégalités dans son critère doit être satisfait simultanément. En mesurant la différence γk ≤ φ toutes les cinq itérations et en détendant un critère classique, nous pouvons éviter les pics indésirables d'erreur causés par le hasard. Le théorème suivant montre qu'il existe un lien direct entre les critères de détention ( 2.12 ) et 5.2 ).
Théorème 2. Dada > 0 et > 0 ), il y a un certain nombre d'itérations k. et β telles que:
Une preuve. Vers Corollarus 1.1, il est soutenu que:
L ′′ ım k →
m (βk) − M [β ks] = 0
Ainsi, il y a un certain nombre d'itérations de telle sorte que k > Kю sont satisfaits:
m (β k) − M et g.
Être vectorielle β * solution de problème ( 2.5 ), où xi tels que β ∗ I > 0 sont appelés vecteurs de support. Il est bien connu que la fonction f ∗, qui détermine la surface de décision g {(x) = 0 Prenez la forme:
N X
f* (x) =
i = 1 β * i yiK (xi, x) + b * 5.3 )
avec
b* = − pn i) 1 β * iK (xi, x +)
2 + pn i = 1 β * iK (xi, x −)
2,
où x + et x− sont deux vecteurs de support dans les classes plus 1 et 1 β + et ′′ − Le multiplicateur de ligrange a été 0 < β + {C} et 0 < β − C
Considérons la fonction de prise de décision déterminée par ce problème ( 2.5 ), à l'itération k:
N X
f k (x) =
i = 1 β k i yiK (xi, x) + bg.
Il est facile de prouver que, 0, il y a un numéro d'itération kloe tel que.k > qy:
g k (x) − f * 5.4 )
C'est à cause du théorème. 1 Cela signifie que:
L ′′ ım k → β g = ß ∗,
et donc que 0 il y a un certain nombre d'itération kν telle que, à savoir k > q.n. il est satisfait Que:
β k − α ′′ ≤/.
Si nous prenons et comment petit, ( 5.4 ) est satisfait pour kγ = k. Dada > 0, si nous avons et sommes assez petits pour ( 5.4 ) et k > kγ avec la définition ( 5.1 ), il est convaincu que:
{pos( 192,240 )} 5 | ≤τ,
et le théorème est valide pour k., β = m ′′ ax {g-q.a.).
□
Depuis le critère ( 5.2 ) s'appuie sur le taux d'erreur, il est intuitif de définir une valeur pour. On peut le dire, par exemple avec a) = 0,0005 comme taux d'erreur jusqu'à 0,05 % peut être considéré comme significativement faible. Cette intuition n'existe pas pour le critère ( 2.12 ) parce que la magnitude de g (β) ne peut pas être estimée à l'avance. Chapitre 5.3 nous avons montré que, dans le cas particulier de l'identification par sexe dans les textes, on peut trouver et rencontrer un domaine de décision généralisant approprié ( 5.2 ) dans des itérations nettement moins importantes que celles requises pour satisfaire au critère théorique largement utilisé ( 2.12 ). Le point clé est l'environnement à haute dimension dans lequel le texte a été représenté, ce qui permet une bonne généralisation empirique rapide. Ainsi, d'un point de vue empirique, GSVM devrait hériter des propriétés de généralisation pour LVM.
5.3 Expériences
Dans cette section, nous décrivons en détail le problème de l'identification des sexes et la façon dont les expériences sont mises en place.
5.3.1 Le problème
Le problème de l'identification des sexes dans les données textuelles comme un suivi des tâches de classification de la formation. En raison d'un bloc de texte qui peut être étiqueté avec l'étiquette de genre d'un individu, l'algorithme devrait automatiquement déduire cette balise. Dans ce cas, nous considérons deux étiquettes de sortie potentielles: L = {"féminine et mâle) comme notre ensemble de données expérimentales ne contient que des exemples de ces deux classes de genre. 5.3.3. Ainsi, nous restreignons notre choix d'algorithmes à ceux orientés à la classification binaire. La même approche pourrait être élargie pour tenir compte d'étiquettes de sortie supplémentaires, reformulant le problème comme une tâche de classement d'une par rapport à l'ensemble ou à plusieurs étiquettes.
Notre cadre de travail diffère des approches antérieures comportant deux défis.
3 ).
Bien que des travaux antérieurs aient été suivis par des procédures conventionnelles d'extraction de textes, telles que la dérivation, nous évitons délibérément cette étape pour préserver la supix du genre en termes et explorer son impact sur l'identification du genre pour des textes avec un fort basculement des mots comme l'espagnol.
Au lieu de marquer une séquence d'entités avec un nom dans le texte, nous abordons le problème de l'attribution d'une étiquette de genre à un bloc de texte ou à un document complet décrivant une autre personne. C'est un problème important pour de nombreuses applications, y compris la notation automatique d'entrée dans les bases de données sémantiques.
Il y a beaucoup de langues qui ont été flexibles, ce qui signifie que les mots peuvent changer leur forme pour refléter l'information de grammaire en tant que nombre et temps ou sexe Hedlund et al. ( 2001 ). En espagnol, les mots qui se terminent par.ou dans une consonne désignent les genres masculins tandis que ceux avec un "sont principalement féminins. La lémisation tente d'éliminer les différences entre les formes flexives d'un mot et de réduire chaque mot dans sa forme racine. Ce prétraitement a été l'approche standard pour l'extraction de texte et la récupération de l'information pour une meilleure précision dans l'identification des termes clés avec un message donné.
Néanmoins, comme mentionné plus haut en espagnol, l'hyperspsis de nombreux mots peut être un indicateur utile et direct pour le sexe. C'est pourquoi il semble raisonnable de supposer que si nous n'appliquons pas la lématisation et que nous conservons plutôt les supix du genre, ils peuvent améliorer l'exactitude de leur identification sexuelle. La stratégie suivante est proposée pour l'identification des textes relatifs à l'égalité entre les sexes:
1. Mettre en œuvre des procédures normalisées d'extraction de texte pour préparer une entrée non traitée, y compris la tokenisation et l'élimination des mots vides (des détails supplémentaires sur la mise en oeuvre sont fournis dans la section 5.3 ).
2. Avant la création de la représentation vectorielle pour chaque document, les méthodes classiques d'extraction de texte suggèrent que certains Sproat et al. ( 2001 ), comme la lématisation pour supprimer les défis de flexibilité et fournir une représentation typique de mots similaires tout en réduisant la taille du vocabulaire. Au lieu de cela, nous proposons de supprimer cette étape de normalisation du texte et de préserver les supix flexibles qui contiennent des informations supplémentaires sur le genre dans des langues spécifiques.
3. Ensuite, nous réélectionnons le processus de production standard du document, générant une représentation vectorielle de chaque papier et construisant un terme - matrice de lettres (encore plus de détails sont donnés dans la section). 5.3 ).
Cette stratégie s'applique à la production de données textuelles qui formeront un algorithme d'autoapprentissage pour l'identification des sexes. Pour prouver l'applicabilité de cette procédure dans un environnement réel, nous avons conçu un certain nombre d'expériences de validation qui sont décrites comme suit.
5.3.2 Configurer les expériences
L'objectif principal est d'évaluer la capacité de notre cadre proposé pour l'identification automatique des sexes associée aux documents textuels du monde réel. À cette fin, nous avons repris des articles biographiques décrivant les auteurs littéraires des versions espagnole et anglaise de DATASET-TH-001 et ses données alimentent d'autres systèmes basés sur la connaissance sémantique comme DATASET-TH-001. Ainsi, deux ensembles de données différents ont été créés et un pour chaque langue. Nous avons conçu notre ensemble de données afin d'assurer une représentation égale des deux étiquettes aux entrées biographiques choisies pour ses expériences espagnoles et espagnoles.
Lorsque nous appliquons notre procédure en tant que texte d'entrée en espagnol et en anglais, nous nous efforçons de confirmer si l'absence de renvoi a un impact positif sur la performance de votre identifiant de genre. Notre ensemble de données choisi était une biographie d'auteurs masculins et féminins. Ce choix nous permet de cadrer l'expérience comme un problème de classification binaire pour lequel il existe plusieurs algorithmes d'autolearning standard. Le chiffre 5.2 présente une description générale de la procédure expérimentale d'évaluation de chaque méthode d'apprentissage supervisé.
Chaque ensemble de données biographiques en anglais et en espagnol est divisé en sous-ensembles de formation ou d'essai. Plus précisément, 70 % des biographies dans chaque langue sont utilisées pour la formation 30 % reste un ensemble de tests permettant d'évaluer les performances des algorithmes d'apprentissage surveillés. La section suivante fournit des détails supplémentaires sur la récupération et la production des deux ensembles de données.
5.3.3 Ensembles de données utilisés
Nous avons commencé, récupérant des biographies d'auteurs littéraires de DATASET-TH-001 en surveillant leur web directement en utilisant le paquet DATASET-TH-001 Clés et Til-
Graphique 5.2: une description du cadre proposé pour l'essai de méthodes de surveillance alternatives.
SOFTWARE-TH-003 ( 2017 ) disponible pour l'environnement statistique R, ORG-TH-112 ( 2022 ). Le paquet peut obtenir une liste de pages, sous-catégories et le contenu de la page ainsi que d'autres informations sur une catégorie individuelle.
L'ensemble de données publiques disponible dans Gomez et al. ( 2021 a), 4 contient 1000 biographies d'écrivains extraites de DATASET-TH-001 dans la langue anglaise. Ces articles sont également divisés en un groupe de femmes et un tableau avec des hommes. Les biographies des femmes ont été extraites de la catégorie "écrivains femmes. 500 pages de la catégorie "écrivains hommes] de 19 Le siècle a été obtenu pour les biographies de l'homme.
L'ensemble de données publiques disponible en espagnol Gomez et al. ( 2021 b)
5 contient 832 Biographies de DATASET-TH-001 en espagnol. Les biographies des femmes ont été extraites de la catégorie "Écrivains espagnols. Au contraire, d'abord 416 pages de la catégorie "Écrivains espagnols de 20 Le siècle 'ont été récupérés pour les biographies des hommes. Ainsi, ces biographies sont également divisées en deux sous-ensembles: l'un des femmes et l'autre des hommes.
Le tableau 5.1 résume certaines statistiques générales tirées d'une analyse exploratoire préliminaire des ensembles de données en anglais et en espagnol, comme décrit ci-dessus.
Nous traitons auparavant chaque biographie à l'aide d'un paquet R d'extraction de texte tm Feinereer et al. ( 2008 ). Supprimer des biographies les mots vides (des termes communs qui ne fournissent normalement pas d'informations utiles pour l'analyse) Eisens-
4 [LINK-REDACTED] 5 [LINK-REDACTED]
Tableau 5.1: Le nombre total et moyen décrivant les ensembles de données en espagnol ou en anglais.
Ensemble de données Description statistiques Valeur
Nombre total de biographies et de génomique 500 Ag. nombre de termes distincts par femme écrire la biographie 50,86
Ag. nombre de termes distincts par femme écrire la biographie (staging) 38,11
changements climatiques
Nombre total de biographies sur les auteurs masculins 500 Ag. nombre de termes distincts par biographie 46,2
Ag. nombre de termes distincts par homme écrire la biographie (staging) 35,62
Nombre total de biographies et de génomique 416 Ag. nombre de termes distincts par femme écrire la biographie 50,03
Ag. nombre de termes distincts par femme écrire la biographie (staging) 31,44
Espagnol
Nombre total de biographies sur les auteurs masculins 416 Ag. nombre de termes distincts par homme écrire la biographie 51,39
Ag. nombre de termes distincts par homme écrire la biographie (staging) 32,68
Tein ( 2019 ), numéro et signe de la partition avec des espaces vides. Le texte de chaque biographie sera ensuite converti en mineur et la matrice relative de terminologie-biographie, comme le montre ce tableau. 5.2. Ainsi, chaque ensemble biographique peut être représenté comme une matrice m × n et avec un nombre N de biographies dans la trousse de formation. Chaque élément de la matrice "biographie" représente un nom important ou de poids pour i en g biographie. Pour obtenir la valeur de wi j, nous utilisons le TF-IDA Aizawa ( 2003 ), calculée comme suit ( 5.5 ):
!, ( 5.5 )
wi = t fi j × log N
d fi
où t fi j indique le nombre d'occurrences du terme i dans la biographie J; g est un chiffre total pour les biographies et finalement, d F3 indique combien de biographies ont été trouvées à ce moment-là.
Il convient de noter que seules les biographies de formation contribuent à la construction d'un dictionnaire des termes représentant toutes les biographies. C'est-à-dire, lorsque le classificateur vérifie de nouvelles biographies concernant un sous-ensemble d'essais qui
Tableau 5.2: Exemple d'une matrice de terminologie-biographie, où wi j représente l'importance et les termes i à l'entrée biographique J.
Biographie du dictionnaire 1 Biographie 2... Biographie
Université W11 w12... aw1n Mariage et M21, F9) Écrivain wm1 Wm2...
Le terme qui ne se trouve pas dans les biographies de l'ensemble d'entraînement est ignoré pour le calcul à distance. De plus, notre étude n'a pas examiné les synonymes et les abréviations ou les formulaires de rechange pour un terme donné.
5.3.4 Résultats
Les résultats d'expériences qui comparent différentes stratégies pour l'identification des sexes dans les textes sont présentés ici. Les expériences pour chaque algorithme de classification impliquent dix essais de divisions d'essais d'entraînement sélectionnés à l'azar.Pour être en mesure de sauvegarder les résultats, nous avons effectué des tests de Wilcoxon Hollander et al. ( 2013 ), après avoir considéré la signification statistique pour les valeurs p inférieures à 0, 05.
GSVM versus AVS standard
Les sections suivantes résument les résultats de l'évaluation d'expériences qui comparent GSVM avec le système standard VMS dans le texte problème d'identification par sexe.
Comparaison du nombre d'ithérations: GSVM versus AVS standard
Le tableau 5.3 Comparaison des itérations pour GSVM et un VMS typique en utilisant le critère d'arrêt classique. Il est clair qu'avec une moyenne d'environ GSVM pour l'ensemble de données espagnol 18 % (avec dérivés) et 25 % (sans dérivés) moins d'itérations que l'approche standard SVM. En même temps, GSVM peut réduire son nombre d'itérations d'environ 42 % (avec dérivés) et 44 % (sans dérivés). Les grandes valeurs de l'écart-type pour GSVM sont le résultat des deux approches atteignant un nombre d'itérations élevé défini à certaines expériences, comprendre combien d'itérations ont été établies avec ce modèle.
Le test de Wilcoxon de l'ensemble de données disponible en anglais montre que la GSVM s'est améliorée par rapport à la LVMN.
ca le résultat (p = valeur) 0,00195 ) comme s'il n'était pas appliqué (p = 0,00589 ). Si l'on examine le cas des biographies espagnoles, cette amélioration est statistiquement significative si elle n'est pas incluse (p = valeur 0,00195 ) mais n'est pas significatif lors de l'utilisation de bounding (valeur p = 0,1 ).
Tableau 5.3: Moyenne (prom.) et écart type du nombre d'itérations aux stades de formation
Méthode langagière Pas de mise en scène
valeur de p vg.a. valeurs de p
Espagnol 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
Anglais SVM 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
Les chiffres 5.3 a), 5.3 b), 5.4 a et 5.4 b ont été montrées graphiquement pour chaque expérience au nombre de GSVM et les itérations AVS standard arrêtent leurs performances d'entraînement, respectivement. Le critère d'arrêt GSVM détecte à quel moment l'indicateur de taux d'erreur sera stabilisé (tipline). Au lieu de cela, le critère classique de détention de la MVM exige un nombre accru d'itérations à arrêter sans fournir de taux d'erreur amélioré.
Il convient de souligner que la performance du critère d'arrêt de GSVM pour les biographies en anglais est similaire, peu importe si le prétraitement de la lématisation a été appliqué ou non (voir figures). 5.3 b et 5.4 b). Une autre constatation remarquable est que le taux d'erreur pour les biographies en espagnol (voir figures) 5.3 a et 5.4 a) Étendre un motif oscillant lors de l'application du prétraitement de dérivation (figure 5.4 a). Cette conduite peut être due à une perte importante d'information introduite par l'opération de renvoi dans cette langue.
Enfin, il convient de mentionner que les paramètres d'évaluation sont très similaires dans tous les cas pour les étiquettes de production "féminine" et (mâle) avec les deux langues.
Comparaison entre GSVM et précision Norme SVM
Pour évaluer les performances de la technique standard SVM avec GOVM. nous avons suivi la précision, le rappel et les mesures de score F1 Baeza-Yates & Ribeiro ( 2011 ); Sokolova et Lapalme ( 2009 ); Olson et Delen ( 2008 ). Le tableau 5.4 montre une comparaison de SVM et GLVM. pour des biographies en anglais avec ou sans dérivation. Pour chaque méthode et métrique, ce tableau montre la moyenne (vg.) avec écart type [s.d.] De plus, la valeur p du test de Wilcoxon pour chaque comparaison est indiquée. Les résultats du test Wilcoxon indiquent qu'il n'y a pas de différences statistiquement significatives pour l'une ou l'autre des mesures considérées, comme et de quelle façon elles sont indiquées dans une colonne de valeur p où toutes les valeurs ont été supérieures à celles de l'échantillon. 0,05.
a) Espagnol
b) Anglais
Graphique 5.3: Pas de dérivation. Comparaison des critères de détention si vous n'utilisez pas de prétraitement de renvoi.
Les résultats présentés dans les tableaux 5.4 et 5.5 ils ont été montrés empiriquement que pour les problèmes d'identification par genre de texte, les techniques de GSVM héritent des mêmes propriétés que celles des LVM et fournissent des résultats de précision similaires.
Le tableau 5.5 montre une comparaison entre SVM et GSSM. pour les biographies espagnoles avec ou sans dérivation. Encore une fois, pour chaque méthode et métrique, ce tableau montre la moyenne (vg.) avec écart-type [s.d.] ainsi qu'avec les valeurs correspondantes de p du test de Wilcoxon. 0.05 ). C'est ainsi qu'ils...
a) Espagnol
b) Anglais
Graphique 5.4 Comparaison des critères de détention par rapport à un traitement préalable au renvoi.
Tableau 5.4: anglais. SVM et GLVM. technologies de performance pour les biographies en anglais, avec ou sans dérivation.
Tige. Méthode genre Rappel de précision score F1
(s.d.) valeur p avg.
Pas de femmes SVM 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
MVS masculins 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Oui Femmes SVM 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
MVS masculins 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
Le nombre d'itérations obtenues par GSVM n'a pas d'incidence sur la précision et
la classification.
Tableau 5.5 Espagnol. SVM et GLVM. technologies de performance pour les biographies en espagnol, avec ou sans dérivation.
Tige. Méthode genre Rappel de précision score F1
(s.d.) valeur p avg.
Pas de femmes SVM 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
MVS masculins 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Oui Femmes SVM 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
MVS masculins 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Le tableau 5.6 échantillon pour GSVM une comparaison entre la dérivation et non dérivée, avec les valeurs correspondantes p. Pour les biographies espagnoles, les résultats montrent une dégradation significative lors de l'inclusion de la dérivation avec des valeurs p de 0, 0097, 0, 00586 et 0, 00195 pour la précision, le rappel et le score F1 respectivement dans les genres féminins. 0, 0137, 0, 00195 et 0, 00195 pour la précision, le rappel et le score F1 respectivement dans les genres masculins. En revanche, pour les biographies en anglais, les valeurs p de toutes les mesures dépassent leur niveau et 0,05 Cela indique l'absence d'un effet significatif.
Tableau 5.6: Comparaison des paramètres de performance de dérivation par rapport aux paramètres non dérivés lors de l'application de GSVM.
Langue Sexe Stem Précision Rappel F1 score
avg. p-valeur aw.p-valuation wings.ct
Espagnole Non 0,909 0,0097 0,907 0,00586 0,903 0,00195 Oui 0,770 0,781 0,747
Numéro masculin 0,889 0,0137 0,913 0,00195 0,891 0,00195 Oui 0,724 0,790 0,713
Anglais Femmes Non 0,908 0,343 0,859 0,124 0,879 1 Oui 0,880 0,898 0,888
Numéro masculin 0,823 0,108 0,909 0,286 0,843 0,636 Oui 0,899 0,884 0,891
GSVM vs. autres algorithmes
Cette sous-section compare le rendement et le temps de formation de GSVM à d'autres méthodes d'autoapprentissage, comme Random Forests (RF) Breiman. 2001 ) et de stimuler Schapire ( 1990 ), des librairies de logiciels communes. Dans ces tests, les hyperparamètres d'algorithme sont définis à leurs valeurs par défaut. Pour chaque algorithme et langage, nous comparons deux flux de travail alternatifs pour chaque métrique: (i) ils incluent une étape de déviation comme avec la plupart des applications de texte classiques. Nous utilisons le temps comme mesure
Comparaison car il n'y a pas de comparaison équitable des nombres d'itérations, avec la mise en oeuvre de chaque méthode suivant une approche d'itération différente.
Comparaison du temps de formation: GSVM par rapport à d'autres algorithmes
Le tableau 5.7 résumer le temps d'exécution (en secondes) pour toutes les versions des algorithmes utilisés avec cette recherche. En utilisant la dérivation pour l'espagnol, GSVM est en moyenne en hausse 10,05 temps plus rapide que le Boosting et 42,87 parfois plus rapide que RF, tandis que pour la langue anglaise GSVM est une hausse moyenne 15,79 fois plus rapide que Boosting et 59,15 fois plus rapide que RF. Lorsque la dérivation ne s'applique pas, GSVM est en moyenne en hausse 49,63 fois plus rapide que Boosting et 81,00 fois plus rapide que RF. GSVM en moyenne 22,91 fois plus rapide que Boosting et 77,70 fois plus rapide que RF. En résumé, le test Wilcoxon effectué et une différence statistiquement significative entre les méthodes indiquent que le temps de formation du GSVM est systématiquement plus court que dans d'autres technologies.
Tableau 5.7: moyenne (vg.) et écart type [s.d.] du temps de formation
Méthode langagière Pas de mise en scène
avg. (s.d.) valeur p apr.tit
GSVM espagnol 3,096 ( 0,460 ) 2,889 ( 0,150 ) Accélérer 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
GSVM espagnol 3,799 ( 0,074 ) 3,883 ( 0,525 ) Accélérer 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
Comparaison de précision: GSVM par rapport à d'autres algorithmes
Puisque la dérivation ne semble pas être significative avec le traitement des biographies en anglais, pour des raisons spatiales, nous concentrerons notre analyse sur son et son espagnol. Le tableau 5.8 montre une comparaison de dérivation par rapport aux valeurs non dérivées et les valeurs correspondantes de p pour GSVM, Boosting ou Random Forest. GSVM obtient des résultats très prometteurs, surtout lorsque la dérivation n'est pas utilisée avec précision et rappel. Note F1 ci-dessus 90 % Dans la plupart des cas, bien que Boosting et Random Forest améliorent principalement les performances du GSVM. Le fait que les deux technologies appartiennent à ceux connus comme des méthodes entières (Sagi et Rokach, 2018 ). En formant plusieurs modèles et en intégrant leurs prédictions, ces méthodes améliorent la performance prédictive d'un modèle unique. Il convient de noter que, dans la mesure où GSVM se comporte avec une MVS standard en termes de précision, ces résultats démontrent l'importance et la pertinence de la dérivation de la non-référence vers des langues telles que l'espagnol. Cette technique de prétraitement aussi bien
affecte les résultats à obtenir en utilisant d'autres types de classimateurs.
En outre, les valeurs p de ce tableau 5.8 montrer une dégradation significative de la performance de tous les algorithmes lors de l'application de la dérivation. Les résultats montrent systématiquement que pour l'espagnol, sans dérivation et précision du score F1 ont été supérieurs à 90 % dans la plupart des cas, lors de l'utilisation de la dérivation, un arrondi de la dégradation se produit. 15 %.
Tableau 5.8: Technologies de précision pour les méthodes de biographies en espagnol.
Méthode Sexe Stem Precision Rappel score F1
(s.d.) valeur p avg.
GSVM Femmes 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 Oui 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Numéro masculin 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 Oui 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Augmentation du nombre de femmes 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 Oui 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
Numéro masculin 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 Oui 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF Femmes Non 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 Oui 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
Numéro masculin 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 Oui 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 Conclusions
Dans la présente section, nous examinons quelques explications sur les différences observées dans le rendement en matière d'identification des sexes et celles-ci tiennent compte des limites potentielles de notre travail.
5.4.1 Comparaison des algorithmes de classification
Les résultats suggèrent que la surveillance de l'application de Stemming dans la production de données textuelles, les mesures de performance sont assez similaires indépendamment de l'algorithme autolearning choisi pour la classification. Néanmoins, il y a des différences selon la langue utilisée.
Par conséquent, nous pouvons conclure que les algorithmes de classification autolearning pour l'identification des sexes peuvent être directement affectés par les supix présents dans les ensembles de données utilisés pour former l'algorithme. Nos résultats confirment que le prétraitement de Stemming, une méthode qui simplifie apparemment le problème de classification, peut induire la confusion entre les sexes pour résoudre ce problème.
5.4.2 Impact de l'élimination des résidus
L'un des principaux objectifs du cadre proposé est d'expliquer si le maintien et le suivi de l'information sur le genre dans certaines langues, comme l'espagnol, peuvent fournir une meilleure classification pour l'identification du genre. Selon les résultats présentés dans ces tableaux 5.6 et 5.8, il y a une augmentation assez remarquable de la performance de notation espagnole pour les algorithmes que nous avons envisagé avec nos expériences quand le passage de dérivation est retiré de la production de données.
Au lieu de cela, les résultats pour la langue anglaise indiquent une variation minimale dans la mesure des scores F1 entre Stemming et non-Scentring en appliquant ou en préparant des données à tout algorithme de classification. Ce langage a des résultats similaires en ce qui concerne la précision du rappel et les mesures de rendement.
Dans l'ensemble, ces résultats appuient notre considération initiale selon laquelle éviter la mise en œuvre de Stemming peut affecter positivement l'identification des genres dans les textes Lorsque le contenu est disponible avec des langues fournissant des détails morphologiques supplémentaires apportant des informations sur les genres comme l'espagnol. Confirmer les connaissances acquises lors de recherches antérieures sur l'importance de la phase de production des données, en particulier si l'on travaille avec d'autres langues que Uysal et Gunto ( 2014 ).
5.4.3 Contraintes
La nouvelle méthode GSVM qui introduit un critère d'arrêt précoce pour la phase de formation fonctionne bien avec un problème spécifique de l'identification du genre par texte. Des expériences supplémentaires devraient donc être réalisées pour évaluer la performance du GSVM dans d'autres tâches de classification avant de recommander le MSSG comme innovation méthodologique globale du VMS avec apprentissage automatique.
En ce qui concerne le cadre proposé pour l'identification des textes de genre, une limite importante de notre environnement expérimental est que nous avons limité une cible de genre variable avec un choix binaire. Problème soulevé par d'autres Hamidi et al. ( 2018 ); Clés ( 2018 ). En fait, avez-vous trouvé que 55 des 58 des études pour l'identification automatique du genre avec autolearning supposaient une sortie de générateur binaire. En ce sens, une voie potentielle pour la recherche future pourrait être de remplacer nos algorithmes de classification binaire par une alternative, car ils peuvent avoir été des modèles d'apprentissage automatique qui admettent des cibles continues et / ou multitilariques. Dans de tels contextes, il serait intéressant d'évaluer si les supix du genre ont encore certains avantages pour l'identification des genres.
Une autre limite de notre approche est que le texte peut ne pas être disponible dans une langue fortement enflammée, différente de l'anglais. Néanmoins, dans ce cas, le texte pourrait être traduit automatiquement de l'espagnol au russe ou dans d'autres langues ayant des propriétés similaires par le biais de Services automatisés. La version traduite du texte peut fournir des informations supplémentaires sur le genre qui permettent d'optimiser les performances de classification. De même, d'autres recherches sont nécessaires pour confirmer que ces premiers résultats comparant l'espagnol et l'anglais peuvent être reproduits avec l'entrée des données dans d'autres langues.
5.4.4 Innovation
Dans cette recherche, nous avons un nouveau critère d'arrêt pour les algorithmes d'optimisation vectorielle de support basés sur les propriétés géométriques de la représentation vectorielle du contenu texte dans le but de résoudre le problème automatisé d'identification de genre. Pour ce problème particulier, nous montrons que l'algorithme proposé nécessite moins de temps pour la formation par rapport à l'application des algorithmes standard SVM. En ce qui concerne le cadre, au lieu de suivre les procédures conventionnelles de normalisation dans l'extraction de texte qui éliminent les défis de genre tels que l'aiguillage, nous conservons ces éléments morphologiques trouvés avec des langues fortement infligées et les faisons optimiser leurs performances. Nous évaluons l'efficacité de cette nouvelle approche en termes de temps de formation en comparant différents algorithmes d'autoapprentissage pour la classification, à l'aide d'un ensemble de données biographiques. DATASET-TH-001 et espagnol.
Nos résultats suggèrent que l'on évite d'orienter le texte vers le prétraitement pour les langues, y compris des éléments supplémentaires avec des informations sur le genre, comme l'espagnol et ainsi de suite. Ce changement de procédure n'a pas affecté d'autres langues neutres comme l'anglais.