Die Verfügbarkeit großer und reichhaltiger Textdatensätze, die hauptsächlich aus Webinhalten erstellt wurden, waren ein wichtiger Faktor beim Data Mining mit Algorithmen oder Autolearning-Methoden zu beispiellosen Preisen. Das hat ein großes Interesse an der Erforschung des automatischen Lernens für die Textanalyse erzeugt Aggarwal () 2018 ). Heute Text Bergbau Srivastava und Sahami () 2009 ) und die Verarbeitung natürlicher Sprache (PLN) Eisenstein 2019 ) bilden die Grundlage für viele dieser Studien und Umsetzungen.
5.1 Einleitung
DATASET-TH-001 Vrandeňci ́ c und Krötzsch () 2014 ) ist ein Beispiel für eine strukturierte und frei zugängliche Datenquelle, die sich auf Informationen stützt, die aus DATASET-TH-001 in mehreren Sprachen. Die Informationen aus den Artikeln der DATASET-TH-001 haben sich einem semantischen Notationsprozess unterzogen, um die Wissensbasis von DATASET-TH-001 Nach einem grafisch strukturierten Datenmodell zur Integration neuer Anwendungen.
Einer dieser Bereiche ist die Geschlechtsidentifikation im Text. Ziel ist es, ein Gender-Label (z. B. "weiblich und männlich") in einen Textbereich unter Verwendung sprachlicher Eigenschaften oder anderer beschreibender Merkmale zuzuweisen. Im Allgemeinen konzentrierte sich frühere Forschung auf die Identifizierung des Geschlechts und Profils einer Person, die seinen Text schreibt. Einige Beispiele sind die Geschlechtsidentifikation von Yan und Y Blog Autoren () 2006 ) und Microblogging
Mukherjee und Bala 2017 ) oder an Benutzer von Client Relations Management Systemen (CRM) Amado et al. 2018 ).
Die Schaffung neuer Inputs aus DATASET-TH-001 und strukturierte Daten in den Artikeln von DATASET-TH-001 Um jedes Thema zu vervollständigen. Zum Beispiel, wenn wir strukturierte Daten über "Gabriel García Márquez" zurückbekommen und wurden DATASET-TH-001 Der entsprechende Eintrag 2. Dann können wir mehrere Felder mit beschreibenden Merkmalen über diese Person erkunden, einschließlich "Geschlecht oder Geschlecht". 3. In diesem Beispiel ist der Wert dieser Eigenschaft "männlich". Zum Zeitpunkt des Schreibens dieses Artikels, wie genau Informationen sein können 6 Verweis auf verschiedene Artikel von DATASET-TH-001 die die Devolution von "male.a" unterstützen
dieses Feld mit strukturierten Daten. Dennoch als offenes Projekt für die kollaborative Schaffung von Wissen DATASET-TH-001 haben oft Vandalismus und Angriffe mit Adler et al. ( 2011 ); Geiger und Ribes 2010 ). Wenn böswillige Agenten die ursprünglichen strukturierten Daten von DATASET-TH-001 Fehler ohne manuelle Inspektion zu erkennen, wäre eine komplexe Aufgabe und dies umso mehr angesichts der großen Größe seiner Datenbank DATASET-TH-001. Auch, wenn es keine strukturierten Informationen über das Geschlecht in einem Artikel von DATASET-TH-001 Es wäre unmöglich, dem geschlechts- oder geschlechtseigentum für seinen eintritt direkt einen wert zuzuordnen. DATASET-TH-001 Diese Informationen werden der Kommission in ihrer ersten Sitzung übermittelt. Stattdessen werden geschlechtsspezifische Informationen als automatische Analyse von Textdaten bezeichnet, die im Körper unstrukturiert sind. DATASET-TH-001 Es könnte die Widerstandsfähigkeit gegenüber diesen Herausforderungen verbessern. Dieses Beispiel kann leicht auf jedes andere Informationssystem extrapoliert werden, das den Inhalt eines Textblocks automatisch mit einem Gender-Tag kennzeichnen sollte.
Wir konzentrierten uns auf einen spezifischen Fall, das Problem der automatischen Bestimmung seines oder ihres Geschlechts, wie es im biographischen Text beschrieben wird. Für den rest dieser arbeit werden wir dieses problem als geschlechtsidentifikation diskutieren. Der Mangel an Studien, die andere Sprachen als Englisch enthalten, macht es schwierig, neue Text-Mining-Verfahren mit einer besseren Perspektive zu entwickeln, um dieses Problem anzugehen. Anstatt sich ausschließlich auf englisch zu konzentrieren, haben wir uns mit weniger geschlechtsspezifischen elementen mit spanischem text beschäftigt, um morpheme zu erfassen, die informationen über das geschlecht enthalten und in dieser sprache häufiger vorkommen. Um dies zu erreichen, werden wir regelmäßige Normalisierungsschritte beim Abbau traditioneller Texte wie Derivate und Eisensteins Lematisierung vermeiden. 2019 ), da sie geschlechtsspezifische Informationen in sprachlicher Hinsicht ausschließen. Diesem Ansatz folgend haben wir gezeigt, dass ein Gender-Wert mit größerer Präzision textuellen Inhalten zugeordnet werden kann.
Bei der Verarbeitung von Text mit automatischen Lerntechnologien ist es normalerweise nützlich.
2 [LINK-REDACTED] 3 [LINK-REDACTED]
Um Vektorleistungen mit hoher Dimension und Dispersion durchzuführen, da sie zahlreiche Komponenten von Nullwert enthalten. In einer Umgebung von streuenden hochdimensionalen Darstellungen, MOguerza et al. (SVM) 2006 ) sind rechnerisch geeignete Jocachims ( 2002 ). Dennoch ist die Anpassung der traditionellen Optimierung Problemlösung Technologien für SVM Joachims ( 1999 Die Anwendung auf die Geschlechtsidentifikation garantiert keine schnelle Konvergenz, da sich die Iteration einer optimalen Lösung ihres zugrunde liegenden Optimierungsproblems nähert.
5.2 Vorschlag
In diesem Abschnitt verwenden wir als Teil des SVM-Frameworks geometrische Eigenschaften einer Text-Geschlechtsidentifikationsaufgabe, um das Stoppkriterium eines zugrunde liegenden Optimierungsalgorithmus zu modifizieren, indem wir Karush-Kuhn-Tucker Feng und Li ersetzen. 2018 ) durch einen neuen Vorschlag, der Informationen (die Fehlerrate) enthält, die mathematisch nicht direkt mit einem Kriterium in Zusammenhang stehen, das der klassische Optimierungs-SVM-Algorithmus zu erfüllen versucht, da er möglicherweise seine Natur anpassen und geometrisches Problem lösen kann. im Folgenden bezeichnet dieses modifizierte SVM als Geometrics (GLVM). Um die Leistung dieses neuen Ansatzes zu bewerten, werden diese Vorschläge mit anderen Wittan- und al-Überwachungsmethoden verglichen. 2017 ) für die automatisierte Geschlechtsidentifikation in biographischen Texten literarischer Autoren, extrahiert aus DATASET-TH-001. Es wird bewertet, ob die gemeinsame Passage der Lematisierung im Text-Mining zu vermeiden, die Geschlechtersupfixe mit Wörtern entfernt, die für die Textanalyse wichtig sind und die Leistung bei der Genderidentifikation verbessert. Die Wirksamkeit des GSVM-Ansatzes zur Beschleunigung der Trainingsphase eines Algorithmus wird ebenfalls gezeigt und zeigt, dass diese Methode die Prozedurleistung nicht signifikant beeinflusst.
5.2.1 Geometrisches Stoppkriterium
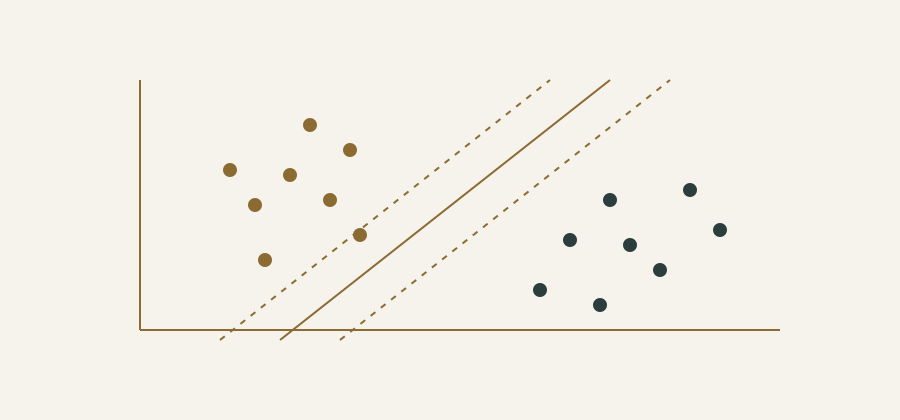
Die Geometrie der SVM-Entscheidungsfunktion in Verbindung mit Trainingsdaten ist innerhalb jeder Iteration quantifizierbar, indem die Fehlerrate gemessen oder geschätzt wird. Das heißt, wenn diese Fehlerrate stabilisiert, erfüllt die Entscheidungsfunktion jene Kriterien für eine effektive Klassifizierung von Daten. Die Zahl 5.1 zeigt ein Beispiel mit zwei mehrdimensionalen Gaußschen Wolken. Die Ausführung einer SVM bis zur Iteration 2 Herstellung der in Fig. 5.1 a while Abbildung 5.1 b die bis zur Iteration berechnete Trennfläche 18. Entscheidungsfunktion der Figur 5.1 a liefert den gleichen empirischen Fehler wie Figur Entscheidungsfunktion 5.1 b, die mehr Iterationen erforderten und
Somit mehr Trainingszeit für den Bau. Stattdessen ist die Konstruktion der Entscheidungsfunktion in Figur 5.1 a Er brauchte weniger Trainings-Iterationen.
(a) SVM läuft bis zur Iteration 2 (b) SVM läuft bis zur Iteration 18
Abbildung 5.1 Zwei Trennflächen mit SVM: (a) Freifläche erhalten nach 2 (b) Trennungsfläche berechnet nach 18 Iterationen
Basierend auf diesen Grundlagen definieren wir εk als die Fehlerrate für das Training, die bei Iteration K und ∞ > 0 als wahrer Wert, der mit Toleranz handelt. Gemäß () 2.3 ),
N X
εk = 1
g
i = 1 ( 1 yi f (xi) und 5.1 )
See δk = ∞ 124; εks - httg ~ 5 |. Die Methode wird abgebrochen, wenn folgende Anforderungen erfüllt sind:
(δk ≤ ∞) 5 {pos ()} 15 {pos (g)} 100 ε), ( 5.2 )
wobei das Symbol ) 'einen logischen Operator bezeichnet und, das heißt, mit allen vier Ungleichheiten innerhalb seines Kriteriums gleichzeitig erfüllt werden sollte. Indem wir die Differenz δk ≤ ∞ alle fünf Iterationen messen und ein klassisches Kriterium lockern, können wir unerwünschte Fehlerspitzen vermeiden, die durch Zufälligkeit verursacht werden. Das folgende Theorema zeigt, dass es einen direkten Zusammenhang zwischen den Kriterien für die Inhaftierung gibt: 2.12 ) und 5.2 ).
Theoremie 2. Dada ∞ > 0 und ∞ > 0 ), gibt es eine Anzahl von Iterationen ků und β wie δk ≤ ∞ y m (βg.
Nachweis. Nach Corollarus 1.1, wird geltend gemacht, dass
L" ım k"
m (βk) − M [β ks] = 0
Es gibt also eine Anzahl von Iterationen kΩ, so dass nämlich k > Kю erfüllt werden:
m (β k) − M und g.
Sei Vektor β ∗ Problemlösung () 2.5 ), wobei xi wie β ∗ I > 0 Es handelt sich um sogenannte Support-Vektoren. Es ist bekannt, dass die Funktion f ∗, die die Entscheidungsfläche g {(x) =) bestimmt. 0 Nehmen Sie das Formular an:
N X
f ∗ (x) =
i = 1 β ∗ i yiK (xi, x) + b * 5.3 )
mit
b ∗ = - pn i 1 β ∗ i iK (xi, x +)
2 + pn i = 1 β ∗ i iK (xi, x −)
2,
wobei x + und x- zwei Unterstützungsvektoren in Klassen mehr sind 1 und 1 als ihr zugehöriges β + und - Ligrange-Multiplikator wurden 0 < β + {C} und 0 < β − > C
Betrachten wir die Entscheidungsfunktion, die durch dieses Problem bestimmt wird () 2.5 ), bei Iteration k:
N X
f k (x) =
i = 1 β k i yiK (xi, x) + bg.
Es ist leicht zu beweisen, dass, γ > 0, gibt es eine Kloe-Iterationsnummer wie.k > qy:
g k (x) - f ∗ 5.4 )
Das liegt am Theorema. 1 Das bedeutet, dass:
L ım k → ∞ β g = ß ∗,
und damit das 0 Es gibt eine Anzahl von Iterationen kν, nämlich k > q.n. es ist erfüllt Das:
β k − α ≤ ν.
Wenn wir nehmen und wie klein, () 5.4 ) für kγ = k erfüllt ist. Dada ∞ > 0 Wenn wir klein genug sind und 5.4 ), und k > kγ mit der Definition ( 5.1 ), hat sie sich davon überzeugt, dass
{pos] 192,240 )} 5 | ≤τ,
und das Theorema ist gültig für kΩ, β = m ax {g-q.a.).
□
Seit dem Kriterium () 5.2 ) stützt sich auf die Fehlerrate, es ist intuitiv, einen Wert für ∞ festzulegen. Wir können es setzen, zum Beispiel mit a = 0,0005 als Fehlerrate bis zu 0,05 % kann als signifikant niedrig angesehen werden. Diese Intuition existiert nicht für das Kriterium () 2.12 ), weil die Größe von g (β) nicht im Voraus geschätzt werden kann. Abschnitt 5.3 Wir haben gezeigt, dass für den speziellen Fall der Geschlechtsidentifikation in Texten ein geeigneter verallgemeinernder Entscheidungsbereich gefunden und erfüllt werden kann () 5.2 ) in deutlich weniger Iterationen als erforderlich, um das weit verbreitete theoretische Kriterium zu erfüllen ( 2.12 ). Der entscheidende Punkt ist die hochdimensionale Umgebung, in der Text dargestellt wurde, so dass eine gute empirische Verallgemeinerung schnell erreicht werden kann. Daher wird erwartet, dass GSVM aus empirischer Sicht die Generalisierungseigenschaften für LVM erbt.
5.3 Experimente
In diesem abschnitt beschreiben wir im detail das problem der geschlechtsidentifikation und wie experimente eingerichtet werden.
5.3.1 Das Problem
Das Problem der Geschlechtsidentifikation in Textdaten als Überwachungstrainings-Klassifizierungsaufgabe stellt eine Herausforderung dar. Aufgrund eines Textblocks, der mit dem Gender-Label einer Person versehen werden kann, sollte der Algorithmus automatisch auf dieses Tag schließen. In diesem Fall betrachten wir zwei potenzielle Output-Labels: L = {"weiblich und männlich"), da unser experimenteller Datensatz nur Instanzen dieser beiden Geschlechterklassen enthält. 5.3.3. Daher beschränken wir unsere Wahl der Algorithmen auf diejenigen, die sich an der binären Klassifizierung orientieren. Derselbe Ansatz könnte erweitert werden, um zusätzliche Output-Labels zu berücksichtigen und das Problem als eine Aufgabe der Einstufung eines solchen gegen alle oder mehrere Tags neu zu formulieren.
Unser Arbeitsrahmen unterscheidet sich von früheren Ansätzen mit zwei Herausforderungen.
3 ).
Obwohl auf frühere Jobs konventionelle Text-Mining-Verfahren wie Ableitung folgten, vermeiden wir diesen Schritt bewusst, um das Geschlechtersupfix in Bezug auf Texte mit einem starken Tipping von Wörtern wie Spanisch zu bewahren und seine Auswirkungen auf die Geschlechtsidentifizierung zu untersuchen.
Anstatt eine Entity-Sequenz mit einem Namen im Text zu markieren, befassen wir uns mit dem Problem der Zuweisung eines Gender Labels zu einem Textblock oder einem vollständigen Dokument, das eine andere Person beschreibt. Das ist ein wichtiges Problem für viele Anwendungen, einschließlich der automatischen Eingabenotation in semantische Datenbanken.
Es gibt viele Sprachen, die sich gebeugt haben, was bedeutet, dass Wörter ihre Form ändern können, um Grammatikinformationen als Anzahl und Zeit oder Geschlecht widerzuspiegeln Hedlund et al. 2001 ). Auf Spanisch, Wörter, die enden at.or in einem Konsonanten bezeichnen männliche Genres, während diejenigen mit einem "sind hauptsächlich weiblich." Die Lemisierung versucht, Unterschiede zwischen den flexiblen Formen eines Wortes zu beseitigen und jedes Wort in seine Wurzelform zu reduzieren. Diese Vorverarbeitung war der Standardansatz für Text Mining und Informationswiederherstellung, um Schlüsselbegriffe mit einer bestimmten Nachricht genauer zu identifizieren.
Wie bereits im Spanischen erwähnt, kann die Hyperspsis vieler Wörter jedoch ein nützlicher und direkter Indikator für das Geschlecht sein. Deshalb scheint es vernünftig anzunehmen, dass, wenn wir keine Lematisierung anwenden und stattdessen Geschlechtersupfixe bewahren, sie die Genauigkeit ihrer Geschlechtsidentifizierung verbessern können. Die folgende Strategie zur Ermittlung von geschlechtsspezifischen Texten wird vorgeschlagen:
1. Implementieren Sie Standard-Text-Mining-Verfahren, um eine unverarbeitete Eingabe vorzubereiten, einschließlich Tokenisierung und Leerwortentsorgung (zusätzliche Implementierungsdetails finden Sie im Abschnitt) 5.3 ).
2. Vor der Erstellung der Vektordarstellung für jedes Dokument deuten konventionelle Text-Mining-Methoden darauf hin, dass einige Sproat et al. 2001 ), wie z. B. Lematisierung, um flexible Herausforderungen zu beseitigen und eine typische Darstellung ähnlicher Wörter zu liefern und gleichzeitig die Vokabelgröße zu reduzieren. Stattdessen schlagen wir vor, diesen Schritt der Textnormalisierung zu unterdrücken und stattdessen flexible Sufixe beizubehalten, die zusätzliche Informationen über das Geschlecht in bestimmten Sprachen enthalten.
3. Dann wählen wir den Standarddokumentproduktionsprozess erneut aus, erzeugen eine Vektordarstellung jedes Papiers und erstellen eine Begriffs-Buchstaben-Matrix (weitere Details sind in Abschnitt angegeben). 5.3 ).
Diese strategie gilt für die erstellung von textdaten, die einen autolearning-algorithmus zur geschlechtsidentifizierung trainieren. Um die Anwendbarkeit dieses Verfahrens in einer tatsächlichen Umgebung nachzuweisen, haben wir eine Nummer für die Durchführung von Validierungsexperimenten entworfen, die wie folgt beschrieben werden.
5.3.2 Konfiguration von Experimenten
Das hauptziel ist es, die kapazität unseres vorgeschlagenen rahmens für die automatische geschlechtsidentifikation im zusammenhang mit realen textdokumenten zu bewerten. Zu diesem Zweck haben wir biographische Artikel zurückgewonnen, die literarische Autoren aus der spanischen und englischen Version von DATASET-TH-001 und ihre Daten andere Systeme auf der Grundlage semantischen Wissens als DATASET-TH-001. So wurden zwei verschiedene Datensätze und einer für jede Sprache erstellt. Wir haben unseren Datensatz so konzipiert, dass eine gleichwertige Darstellung beider Etiketten an biografischen Eingaben gewährleistet ist, die für seine und ihre spanischen Experimente ausgewählt wurden.
Bei der Anwendung unseres Verfahrens als Eingangstext in Spanisch und Englisch möchten wir bestätigen, ob sich die Vermeidung einer Überweisung positiv auf die Leistung Ihres Geschlechts auswirkt. Unser ausgewählter Datensatz waren Biographien männlicher und weiblicher Autoren. Diese Wahl ermöglicht es uns, das Experiment als binäres Klassifizierungsproblem zu gestalten, für das es mehrere Standard-Autolearning-Algorithmen gibt. Die Zahl 5.2 eine allgemeine Beschreibung des experimentellen Verfahrens zur Bewertung jeder überwachten Lernmethode.
Jeder Datensatz von Biografien in Englisch und Spanisch ist in Trainings- oder Testuntergruppen unterteilt. Insbesondere: 70 % Biografien in jeder Sprache werden für das Training verwendet, während 30 % verbleibt als Testsatz zur Bewertung der Leistung überwachter Lernalgorithmen. Der folgende Abschnitt enthält zusätzliche Details zur Wiederherstellung und Produktion beider Datensätze.
5.3.3 Verwendete Datensätze
Wir haben begonnen, Biographien von literarischen Autoren von DATASET-TH-001 durch die Überwachung ihrer Web direkt mit dem Paket DATASET-TH-001 Keyes und Til-
Abbildung 5.2: Eine Beschreibung des vorgeschlagenen Rahmens für die Erprobung alternativer Überwachungsmethoden.
SOFTWARE-TH-003 ( 2017 ) für das statistische Umfeld R verfügbar, ORG-TH-112 ( 2022 ). Das Paket kann eine Liste von Seiten, Unterkategorien und Seiteninhalten sowie andere Informationen zu einer einzelnen Kategorie erhalten.
Der öffentliche Datensatz in Gomez und al. () 2021 a, 4 enthält 1000 Biografien von Schriftstellern, extrahiert aus DATASET-TH-001 in englischer Sprache. Diese artikel sind gleichermaßen in eine gruppe von frauen und ein array mit männern unterteilt. Die Biographien von Frauen wurden aus der Kategorie "Schriftsteller Frauen.und ihre erste" extrahiert 500 Seiten aus der Kategorie "Schriftsteller Männer" von The 19 Jahrhundert wurden für die Biographien des Menschen erhalten.
Der öffentliche Datensatz in Spanisch Gomez und al. () 2021 b
5 enthält 832 Biografien von DATASET-TH-001 auf Spanisch. Die Biographien von Frauen wurden aus der Kategorie "Spanische Schriftsteller" extrahiert. Im Gegenteil, erstens 416 Seiten aus der Kategorie "Spanische Schriftsteller der" 20 Jahrhundert 'wurden für die Biographien der Männer abgerufen. So sind diese Biografien auch in zwei Untergruppen unterteilt: eine von Frauen und eine andere über Männer.
Die Tabelle 5.1 fasst einige allgemeine Statistiken aus einer vorläufigen explorativen Analyse der Datensätze in Englisch und Spanisch wie oben beschrieben zusammen.
Wir haben zuvor jede Biographie mit einem R-Paket von Text Mining tm Feinereer et al. ( 2008 ). Um leere Wörter aus Biografien zu entfernen (gemeinsame Begriffe, die normalerweise keine nützlichen Informationen für die Analyse liefern) Eisens-
4 [LINK-REDACTED] 5 [LINK-REDACTED]
Tabelle 5.1 Die Gesamt- und Durchschnittszahl, die Datensätze in Spanisch oder Englisch beschreibt.
Datensatzbeschreibungsstatistiken Wert
Gesamtzahl der Biografien und Genomik 500 Ag. Anzahl der unterschiedlichen Begriffe pro Frau schreiben Biographie 50,86
Ag. Anzahl der unterschiedlichen Begriffe pro Frau schreiben Biographie (Stufe) 38,11
Englisch
Gesamtzahl der Biografien über männliche Autoren 500 Anzahl der unterschiedlichen Begriffe pro Biografie 46,2
Ag. Anzahl der unterschiedlichen Begriffe pro Mann schreiben Biographie (Stufe) 35,62
Gesamtzahl der Biografien und Genomik 416 Ag. Anzahl der unterschiedlichen Begriffe pro Frau schreiben Biographie 50,03
Ag. Anzahl der unterschiedlichen Begriffe pro Frau schreiben Biographie (Stufe) 31,44
Spanisch
Gesamtzahl der Biografien über männliche Autoren 416 Anzahl der unterschiedlichen Begriffe pro Mann schreiben Biographie 51,39
Ag. Anzahl der unterschiedlichen Begriffe pro Mann schreiben Biographie (Stufe) 32,68
Zwirn 2019 ), Zahl und Zeichen der Punktzahl mit leeren Leerzeichen. Der Text jeder Biographie wird später in Moll und die relative Begriff-Biografie-Matrix konvertiert, wie in dieser Tabelle gezeigt. 5.2. Somit kann jeder biographische Satz als m × n Matrix und mit einer N Anzahl von Biografien im Trainingspaket dargestellt werden. Jedes wij-Element der Begriffsbiografiematrix stellt einen wichtigen oder Gewichtsnamen für i in g Biographie dar. Um den Wert von wi j zu erhalten, verwenden wir die TF-IDA Aizawa () 2003 ), berechnet als ( 5.5 ):
!, ( 5.5 )
wi = t fi j × log N
d fi
wobei t fi j die Anzahl der Vorkommen aus dem Begriff i in der Biographie J bezeichnet; g ist eine Gesamtzahl für Biografien und schließlich gibt d F3 an, wie viele Biographis zu diesem Zeitpunkt gefunden wurden.
Es sollte angemerkt werden, dass nur Trainingsbiografien zur Konstruktion von Begriffen beitragen, die alle Biographen repräsentieren. Das heißt, wenn der Klassifikator neue Biografien über eine Testteilmenge überprüft, die
Tabelle 5.2: Beispiel einer Begriff-Biographie-Matrix, wobei wi j die Bedeutung und die Begriffe i am biographischen Eingang J darstellt.
Wörterbuch Biographie 1 Biografie 2... Biografie
Universität W11 w12... aw1n Ehe und M21, F9) Schriftsteller wm1 Wm2...
quier Begriff gefunden nicht in Biografien des Trainingssatzes wird für die Berechnung aus der Ferne ignoriert. Auch unsere Studie berücksichtigte keine Synonyme und Abkürzungen oder alternative Formen für einen bestimmten Begriff.
5.3.4 Ergebnisse
Die Ergebnisse von Experimenten, die verschiedene Strategien zur Geschlechtsidentifikation in Texten vergleichen, werden hier vorgestellt. Die Experimente für jeden Klassifikationsalgorithmus umfassen zehn Versuche mit am azar ausgewählten Trainingstestabteilungen.Um die Ergebnisse sichern zu können, haben wir Tests von Wilcoxon Hollander et al. () 2013 ), unter Berücksichtigung der statistischen Signifikanz für p-Werte kleiner als 0, 05.
GSVM im Vergleich zu Standard-AVS
Die folgenden abschnitte fassen die ergebnisse der auswertung von experimenten zusammen, die gsvm mit standard-vms im text-geschlechtsidentifikationsproblem vergleichen.
Vergleich der Iterationsnummer: GSVM versus Standard-AVS
Die Tabelle 5.3 Vergleich der Iterationen zählen für GSVM und ein typisches VMS mit dem klassischen Stoppkriterium. Es ist klar, dass mit einem Durchschnitt von etwa GSVM für den spanischen Datensatz 18 % (mit Derivaten) und 25 % (ohne Derivate) weniger Iterationen als der Standard-SVM-Ansatz. Gleichzeitig kann GSVM die Anzahl der Iterationen um etwa 42 % (mit Derivaten) und 44 % (ohne Derivate). Die großen Werte in der Standardabweichung für GSVM sind das Ergebnis beider Ansätze, die eine so hohe Iterationszahl erreichen, wie sie für einige Experimente definiert ist, um zu verstehen, wie viele Iterationen mit diesem Modell etabliert wurden.
Wilcoxons Test des in englischer Sprache verfügbaren Datensatzes zeigt, dass sich GSVM im Vergleich zu LVMN statistisch signifikant verbesserte, sowohl als angewendet als auch mit einem hohen
ca das Steming (p = Wert) 0,00195 ) als wenn nicht angewandt (p = 0,00589 ). Wenn wir uns den Fall der spanischen Biographien ansehen, ist diese Verbesserung statistisch signifikant, wenn das Steming nicht enthalten ist (p = Wert). 0,00195 ) ist aber bei der Verwendung von Steming nicht signifikant (p-Wert = 0,1 ).
Tabelle 5.3: Durchschnittliche (prom.) und Standardabweichung der Iterationszahl in den Trainingsphasen
Sprachmethode Stemming Keine Inszenierung
avg. s.d. p-Wert vg.a. p-Werte
Spanisch 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
Englisch SVM 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
Die Zahlen 5.3 a, 5.3 b, 5.4 a und 5.4 b wurde für jedes Experiment grafisch gezeigt, bei welcher Anzahl von GSVM- und Standard-AVS-Iterationen ihre Trainingsleistung gestoppt wird. Das GSVM-Stop-Kriterium erkennt, wie schnell der Fehlerquotenindikator stabilisiert wird (Tippline). Stattdessen erfordert das klassische SVM-Haltekriterium eine erhöhte Anzahl von Iterationen, um zu stoppen, ohne eine verbesserte Fehlerrate zu liefern.
Es sollte betont werden, dass die Leistung des GSVM-Stop-Kriteriums für Biographien in englischer Sprache ähnlich ist, unabhängig davon, ob eine Lematisierungsvorverarbeitung angewendet wurde oder nicht (siehe Zahlen). 5.3 b und 5.4 b. Eine weitere bemerkenswerte Erkenntnis ist, dass die Fehlerquote für Biografien in Spanisch (siehe Zahlen) 5.3 a und 5.4 a) Erweitern eines oszillierenden Musters bei Anwendung der Ableitungsvorverarbeitung (Abbildung 5.4 a. Dieses Verhalten kann auf einen erheblichen Informationsverlust zurückzuführen sein, der durch die Überweisung in dieser Sprache eingeführt wurde.
Schließlich ist zu erwähnen, dass die Bewertungsmetriken in allen Fällen für "weibliche" und (männliche) Produktionsetiketten mit beiden Sprachen sehr ähnlich sind.
Vergleich von GSVM vs. Genauigkeit Standard SVM
Um die Leistung der Standard-SVM-Technik mit GOVM zu bewerten. wir haben Präzision, Rückruf und Punktzahl Metriken F1 Baeza-Yates & Ribeiro () 2011 ); Sokolova und Lapalme 2009 ); Olson und Delen 2008 ). Die Tabelle 5.4 zeigt einen Vergleich von SVM und GLVM. für Biographien in englischer Sprache mit oder ohne Ableitung. Für jede Methode und Metrik zeigt diese Tabelle den Mittelwert (avg.) mit Standardabweichung [s.d.] Auch der p-Wert des Wilcoxon-Tests für jeden Vergleich wird gezeigt. Die Wilcoxon-Testergebnisse zeigen, dass es für keine der betrachteten Metriken statistisch signifikante Unterschiede gibt, da und wie sie in einer p-Wert-Spalte angezeigt werden, in der alle Werte höher waren als 0,05.
a Spanisch
b Englische Sprache
Abbildung 5.3: Keine Ableitung. Vergleich der Haftkriterien, wenn Sie keine Überweisungsvorverarbeitung verwenden.
Die in den Tabellen angegebenen Ergebnisse 5.4 und 5.5 Sie haben empirisch gezeigt, dass die GSVM-Techniken bei Text-Geschlechtsidentifikationsproblemen dieselben Eigenschaften wie die von LVMs erben und ähnliche Präzisionsergebnisse liefern.
Die Tabelle 5.5 zeigt einen Vergleich von SVM und GSSM. für spanische Biographien mit oder ohne Ableitung. Wiederum zeigt diese Tabelle für jede Methode und Metrik den Mittelwert (avg.) mit Standardabweichung [s.d.] sowie bei entsprechenden p-Werten des Wilcoxon-Tests Ähnlich wie in den Biographien in Englisch zeigen Wilcoxons Testergebnisse, dass es keine statistisch signifikanten Unterschiede für beide Metriken gibt (p-Werte waren höher als bei den anderen). 0.05 ). Das ist, wie sie...
a Spanisch
b Englische Sprache
Abbildung 5.4 Vergleich der Kriterien für seine Inhaftierung mit Bezug auf eine Überweisungsvorverarbeitung.
Tabelle 5.4: Englisch. SVM und GLVM. Leistungstechnologien für Biografien in englischer Sprache, mit oder ohne Ableitung.
Stamm. Gender Method Precision Recall F1-Score
p-Wert avg.
Keine weibliche SVM 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
Männliche SVM 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Ja weibliche SVM 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
Männliche SVM 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
Die Anzahl der von GSVM erreichten Iterationen hat keinen Einfluss auf die Genauigkeit und
Klassifikation.
Tabelle 5.5 Spanisch. SVM und GLVM. Leistungstechnologien für Biografien in Spanisch, mit oder ohne Ableitung.
Stamm. Gender Method Precision Recall F1-Score
p-Wert avg.
Keine weibliche SVM 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
Männliche SVM 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Ja weibliche SVM 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Männliche SVM 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Die Tabelle 5.6 Beispiel für GSVM einen Vergleich zwischen Ableitung und nicht-derivativ, mit den entsprechenden p-Werten. Für spanische Biographien zeigen die Ergebnisse eine signifikante Verschlechterung, wenn sie die Ableitung mit p-Werten von 0, 0097, 0, 00586 und 0, 00195 für Präzision, Rückruf und F1-Score jeweils in den weiblichen Genres. 0, 0137, 0, 00195 und 0, 00195 für Präzision, Rückruf und F1-Score jeweils in männlichen Genres. Für Biografien in englischer Sprache überschreiten stattdessen die p-Werte aller Metriken ihr Niveau und 0,05 Dies deutet darauf hin, dass keine signifikante Wirkung vorliegt.
Tabelle 5.6 Vergleich von Ableitungsleistungsmetriken mit nicht-derivativen bei der Anwendung von GSVM.
Language Gender Stem Precision Recall F1-Score
avg. p-value aw.p-valuation wings.ct
Spanisch Weiblich Nr. 0,909 0,0097 0,907 0,00586 0,903 0,00195 Ja 0,770 0,781 0,747
Männchen 0,889 0,0137 0,913 0,00195 0,891 0,00195 Ja 0,724 0,790 0,713
Englisch Female No. 0,908 0,343 0,859 0,124 0,879 1 Ja 0,880 0,898 0,888
Männchen 0,823 0,108 0,909 0,286 0,843 0,636 Ja 0,899 0,884 0,891
GSVM vs. andere Algorithmen
In diesem Unterabschnitt werden die Leistungs- und Schulungszeit von GSVM mit anderen Autolearning-Methoden wie Random Forests (RF) Breiman verglichen. 2001 und Boosting Schapire () 1990 ), aus gängigen Software-Buchhandlungen. Bei diesen Tests werden die Algorithmus-Hyperparameter auf ihre Standardwerte gesetzt. Für jeden Algorithmus und jede Sprache vergleichen wir zwei alternative Text-Mining-Workflows für jede Metrik: (i) sie enthalten einen Abweichungsschritt wie bei den meisten herkömmlichen Texting-Anwendungen. Wir verwenden Zeit als Metrik
Vergleich, da es keinen fairen Vergleich der Iterationszahlen gibt, wobei die Implementierung jeder Methode einem anderen Iterationsansatz folgt.
Vergleich der Trainingszeit: GSVM gegenüber anderen Algorithmen
Die Tabelle 5.7 Summieren Sie die Laufzeit (in Sekunden) für alle Versionen von Algorithmen, die mit dieser Forschung verwendet werden. Mit der Ableitung für Spanisch, GSVM ist im Durchschnitt bis 10,05 Mal schneller als das Boosting und 42,87 manchmal schneller als RF, während für die englische Sprache GSVM ein durchschnittlicher Anstieg ist 15,79 Mal schneller als Boosting und 59,15 Mal schneller als RF. Wenn die Ableitung nicht zutrifft, ist GSVM als Durchschnitt nach oben 49,63 Mal schneller als Boosting und 81,00 Mal schneller als RF. GSVMs als Durchschnitt 22,91 Mal schneller als Boosting und 77,70 Mal schneller als RF. Zusammenfassend lässt sich sagen, dass der durchgeführte Wilcoxon-Test und ein statistisch signifikanter Unterschied zwischen den Methoden darauf hindeuten, dass die Trainingszeit des GSVM konstant kürzer ist als bei anderen Technologien.
Tabelle 5.7: Mittelwert (avg.) und Standardabweichung [s.d.] der Trainingszeit
Sprachmethode Stemming Keine Inszenierung
avg. (s.d.) p-Wert apr.tit
Spanische GSVM 3,096 ( 0,460 ) 2,889 ( 0,150 ) Steigerung 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
Spanische GSVM 3,799 ( 0,074 ) 3,883 ( 0,525 ) Steigerung 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
Präzisionsvergleich: GSVM gegen andere Algorithmen
Da die Ableitung bei der Verarbeitung von Biografien in englischer Sprache nicht signifikant erscheint, werden wir unsere Analyse aus Platzgründen auf sein und ihr Spanisch konzentrieren. Die Tabelle 5.8 zeigt einen Ableitungsvergleich gegenüber nicht-derivativen und den entsprechenden p-Werten für GSVM, Boosting oder Random Forest. GSVM erzielt sehr vielversprechende Ergebnisse, insbesondere wenn die Ableitung nicht mit Präzision und Rückruf verwendet wird. F1-Score oben 90 % In den meisten Fällen verbessern Boosting und Random Forest jedoch hauptsächlich die GSVM-Leistung. Die Tatsache, dass beide Technologien zu denen gehören, die als ganze Methoden bekannt sind (Sagi und Rokach), 2018 ). Durch das Training mehrerer Modelle und die Integration ihrer Vorhersagen verbessern diese Methoden die prädiktive Leistung eines einzelnen Modells. Da sich GSVM in Bezug auf die Präzision mit einem Standard-MVS verhält, beweisen diese Ergebnisse die Bedeutung und Relevanz für die Ableitung aus der Nichtverweisung in Sprachen wie auf spanischer Ebene. Auch diese Vorverarbeitungstechnik
beeinflusst die Ergebnisse, die mit anderen Arten von Klassifikatoren erzielt werden sollen.
Auch die p-Werte dieser Tabelle 5.8 eine signifikante Leistungsminderung aller Algorithmen bei der Anwendung der Ableitung zeigen. Die Ergebnisse zeigen konsequent, dass für Spanisch, ohne Ableitung und Genauigkeit der F1-Score höher als 90 % In den meisten Fällen kommt es bei der Ableitung zu einer Verrundung des Abbaus. 15 %.
Tabelle 5.8: Präzisionstechnologien für Biografien Methoden in Spanisch.
Methode Gender Stem Precision Recall F1-Score
p-Wert avg.
GSVM Weibliche Nr. 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 Ja 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Männchen 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 Ja 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Steigerung der weiblichen No 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 Ja 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
Männchen 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 Ja 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF Weibliche Nr. 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 Ja 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
Männchen 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 Ja 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 Schlussfolgerungen
In diesem abschnitt betrachten wir einige erklärungen für die unterschiede, die in der geschlechtsidentifikationsleistung gefunden werden, und diese reflektieren mögliche einschränkungen unserer arbeit.
5.4.1 Vergleich von Klassifizierungsalgorithmen
Die Ergebnisse deuten darauf hin, dass die Überwachung von Stemmings Anwendung in der Textdatenproduktion, Leistungsmetriken unabhängig vom für die Klassifizierung ausgewählten Autolearning-Algorithmus ziemlich ähnlich sind. Dennoch gibt es Unterschiede in Abhängigkeit von der verwendeten Sprache.
Als Ergebnis können wir schließen, dass Autolearning-Klassifikationsalgorithmen für die Geschlechtsidentifizierung direkt von Sufixen betroffen sein können, die in Datensätzen vorhanden sind, die zum Trainieren des Algorithmus verwendet werden. Unsere Ergebnisse bestätigen, dass die Vorverarbeitung von Stemming, eine Methode, die das Klassifizierungsproblem anscheinend vereinfacht, geschlechtsspezifische Verwirrung induzieren kann, um dieses Problem zu lösen.
5.4.2 Auswirkungen der Stemming-Entfernung
Ein Hauptziel des vorgeschlagenen Rahmens ist es, zu erklären, ob die Speicherung und Überwachung mit Informationen über das Geschlecht in einigen Sprachen, wie Spanisch, eine bessere Klassifizierungsleistung für die Geschlechteridentifizierung bieten kann. Nach den in diesen Tabellen dargestellten Ergebnissen 5.6 und 5.8, gibt es einen ziemlich bemerkenswerten Anstieg der spanischen Bewertungsleistung für die Algorithmen, die wir bei unseren Experimenten in Betracht gezogen haben, wenn Ableitungsübergabe aus der Datenproduktion entfernt wird.
Stattdessen zeigen die Ergebnisse für die englische Sprache eine minimale Variation in der F1-Score-Metrik zwischen Stemming und Nicht-Scentering an, indem Daten auf einen Klassifizierungsalgorithmus angewendet oder vorbereitet werden. Diese Sprache hat ähnliche Ergebnisse in Bezug auf die Genauigkeit und Leistungsmetriken des Rückrufs.
Insgesamt unterstützen diese ergebnisse unsere anfängliche Überlegung, dass die vermeidung der umsetzung von stemming die geschlechtsidentifikation in texten positiv beeinflussen kann wenn inhalte mit sprachen verfügbar sind, die zusätzliche morphologische details liefern, die geschlechtsspezifische informationen wie spanisch hervorbringen. Bestätigung von Erkenntnissen aus früheren Untersuchungen über die Bedeutung der Datenproduktionsphase, insbesondere wenn mit anderen Sprachen als Uysal und Gunto gearbeitet wird 2014 ).
5.4.3 Einschränkungen
Die neue GSVM-Methode, die ein Early-Stop-Kriterium für die Trainingsphase einführt, funktioniert gut mit einem spezifischen Problem der Text-Geschlechtsidentifikation. Daher sollten zusätzliche Experimente durchgeführt werden, um die GSVM-Leistung bei anderen Klassifikationsaufgaben zu bewerten, bevor MSSG als allgemeine methodische Innovation von VMS mit automatischem Lernen empfohlen wird.
In Bezug auf den vorgeschlagenen Rahmen für die Identifizierung von Geschlechtstexten besteht eine wichtige Einschränkung unserer experimentellen Umgebung darin, dass wir ein Ziel geschlechtsvariabel mit binärer Wahl begrenzt haben. Problem aufgeworfen von anderen Hamidi et al. ( 2018 ); Keyes (Keyes) 2018 ). Haben Sie tatsächlich herausgefunden, dass 55 von 58 Studien zur automatischen Geschlechtsidentifikation mit Autolearning nahmen einen binären Gener-Output an. In diesem Sinne könnte ein potenzieller Weg für die zukünftige Forschung darin bestehen, unsere binären Klassifizierungsalgorithmen durch eine Alternative zu ersetzen, da es sich möglicherweise um automatische Lernmodelle handelt, die kontinuierliche und / oder multitilare Ziele zulassen. In solchen Kontexten wäre es interessant zu bewerten, ob Gender-Sufixe noch einige Vorteile für die Identifikation von Genres haben.
Eine weitere Einschränkung unseres Ansatzes besteht darin, dass der Text möglicherweise nicht in einer stark entzündeten Sprache verfügbar ist, die sich von Englisch unterscheidet. In diesem Fall könnte der Text jedoch automatisch aus dem Spanischen ins Russische oder in andere Sprachen mit ähnlichen Eigenschaften über automatisierte Dienste übersetzt werden. Die übersetzte Version des Textes kann zusätzliche geschlechtsspezifische Informationen liefern, die eine Optimierung der Klassifizierungsleistung ermöglichen. In ähnlicher Weise ist mehr Forschung erforderlich, um zu bestätigen, dass diese ersten Ergebnisse, die Spanisch und Englisch vergleichen, mit der Dateneingabe in alternative Sprachen replizierbar sind.
5.4.4 Innovation
In dieser Forschung haben wir ein neues Stop-Kriterium für unterstützende Vektoroptimierungsalgorithmen basierend auf den geometrischen Eigenschaften der vektoriellen Darstellung von Textinhalten mit dem Ziel, ein automatisiertes Problem der Geschlechteridentifikation zu lösen. Für dieses spezielle Problem zeigen wir, dass der vorgeschlagene Algorithmus im Vergleich zur Anwendung von Standard-SVM-Algorithmen weniger Zeit für das Training benötigt. In Bezug auf das Framework, anstatt herkömmliche Normalisierungsverfahren im Text-Mining zu befolgen, die geschlechtsspezifische Herausforderungen wie Überweisungen beseitigen, bewahren wir diese morphologischen Elemente bei stark zugefügten Sprachen und lassen sie ihre Leistung optimieren. Wir bewerten, wie effektiv dieser neue Ansatz in Bezug auf die Trainingszeiten umgesetzt werden kann, indem wir verschiedene Autolearning-Algorithmen zur Klassifizierung mithilfe eines biografischen Eingabedatensatzes vergleichen. DATASET-TH-001 und Spanisch.
Unsere Ergebnisse deuten darauf hin, dass eine Überweisung (Stemming) an die Vorverarbeitung von Text für Sprachen vermieden wird, einschließlich zusätzlicher Elemente mit geschlechtsspezifischen Informationen wie Spanisch und so weiter. Diese Prozedurverschiebung wirkte sich nicht auf andere neutrale Sprachen als Englisch aus.