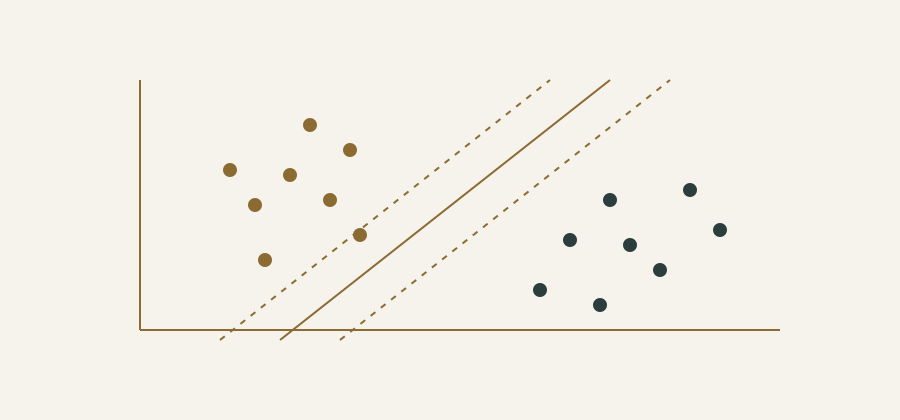
La disponibilitat de grans i rics conjunts de dades textuals, creats principalment a partir de contingut web, ha fomentat la mineria de dades, els algorismes i mètodes d'aprenentatge automàtic a un ritme sense precedents. El que ha generat un alt interès per la recerca de l'aprenentatge automàtic per a l'anàlisi de text Aggarwal ( 2018 ). Avui dia, la mineria de textos Srivastava i Sahamí (Cànt. 2009 ) i el processament del llenguatge natural (PLN ) Eisenstein ( 2019 ) constitueixen la base de molts d'aquests estudis i implementacions.
5.1 Introducció
DATASET-TH-001 Vrande ( vrandaci ) i Krötzsch ( 2014 ) és un exemple d'una font de dades estructurada i de lliure accés, que s'alimenta de la informació extreta d'articles de DATASET-TH-001 en múltiples idiomes. Les dades obtingudes dels articles de DATASET-TH-001 se sotmeten a un procés d'anotació semàntica per ampliar la base de coneixement de DATASET-TH-001, seguint un model de dades estructurat en gràfics per integrar noves aplicacions.
Una d'aquestes àrees d'aplicació és la identificació de gènere en el text. L'objectiu és assignar una etiqueta de gènere (per exemple "femení" o "masculí") a un bloc de text basant-se en propietats lingüístiques i altres característiques descriptives. En general, les investigacions anteriors s’han centrat a identificar el gènere i el perfil de la persona que escriu el text. Alguns exemples inclouen la identificació de gènere dels autors de blocs Yan i Yan (en anglès) 2006 ) i de microblocging
Mukherjee i Bala ( 2017 ) o en usuaris de sistemes de gestió de relacions amb el client ( CRM ) Amado et al. ( 2018 ).
La creació de noves entrades de DATASET-TH-001 es basa en pistes existents i dades estructurades en els articles de DATASET-TH-001 per completar cada tema. Per exemple, si volem recuperar dades estructurades sobre “Gabriel García Márquez”, podem buscar en DATASET-TH-001 corresponent 2. Després, podem explorar diversos camps amb característiques descriptives sobre aquesta persona, inclòs el "sex o gènere" 3. En aquest exemple, el valor d'aquesta propietat és «masculí». En el moment d'escriure aquest article, la precisió d'aquesta informació es basa en fins 6 referències a diferents articles de DATASET-TH-001 que dóna suport a l'atribució del valor "masculí.a
aquest camp basat en dades estructurades. No obstant això, com a projecte obert per a la creació col·laborativa de coneixement, DATASET-TH-001 ha patit sovint vandalisme i atacs de contingut Adler et al. ( 2011 ); Geiger i Ribes ( 2010 ). En el cas que agents maliciosos alterin les dades estructurades originals dels articles de DATASET-TH-001, detectar errors sense una inspecció manual seria una tasca complexa, més encara donada la gran grandària de la base de dades de temes de DATASET-TH-001. A més, si no hi ha informació estructurada sobre el gènere en un article de DATASET-TH-001 no seria possible assignar un valor directament a la propietat " sex o gènere " per a la seva entrada de DATASET-TH-001 corresponent. En canvi, etiquetar la informació de gènere en funció d'una anàlisi automàtica de dades textuals no estructurades en el cos dels articles de DATASET-TH-001 Podria millorar la resiliència davant d'aquests problemes. Aquest exemple es pot extrapolar fàcilment a qualsevol altre sistema d'informació que hagi d'etiquetar automàticament el contingut d'algun bloc de text amb una etiqueta de gènere.
Ens centrem en un cas específic, el problema de determinar automàticament el gènere de la persona descrita en un text biogràfic. A la resta d'aquesta feina, ens referirem a aquest problema com a identificació de gènere. La manca d'estudis que incloguin llengües diferents de l'anglès dificulta el desenvolupament de nous procediments en mineria de textos per abordar millor aquest problema. En comptes de centrar-nos exclusivament en l'anglès, que proporciona menys elements de gènere, examinem l'ús del text espanyol per capturar morfemes que porten informació de gènere i són més freqüents en aquest idioma. Per aconseguir-ho, evitarem els passos de normalització habituals en la mineria de textos tradicional, com els derivats i la lematització Eisenstein (Eisenstein). 2019 ), perquè descarten la informació de gènere en termes lingüístics. Seguint aquest enfocament, demostrarem que és possible assignar un valor de gènere al contingut textual amb una major precisió.
En processar text mitjançant tècniques d'aprenentatge automàtic, és habitual utili-
2 [LINK-REDACTED] 3 [LINK-REDACTED]
Les representacions vectorials, caracteritzades per una alta dimensionalitat i dispersió, ja que contenen nombrosos components de valor zero. En entorn de representacions disperses d'alta dimensió, les màquines de vectors de suport (SVM) Moguerza et al. ( 2006 ) són classificadors computacionalment adequats Joachims ( 2002 ). No obstant això, l'adaptació de les tècniques tradicionals de resolució de problemes d'optimització per a la classificació SVM Joachims ( 1999 ) aplicada a la identificació de gènere no garanteix una convergència ràpida quan les iteracions s'acosten a la solució òptima del problema d'optimització subjacent.
5.2 Proposta
En aquesta secció, dins del marc dels SVM, s'usen les propietats geomètriques de la tasca d'identificació de gènere de text per modificar el criteri de detenció de l'algorisme d'optimització subjacent en substituir el criteri clàssic de Karush-Kuhn- Tucker Feng i Li ( 2018 ) per una nova proposta, que incorpora informació (la taxa d'error) que no està directament relacionada matemàticament amb el criteri que l'algoritme SVM d'optimització clàssic intenta complir, ja que potencialment pot adaptar la naturalesa de l'algoritme al problema geomètric a resoldre. En endavant, es refereix a aquest SVM modificat com SVM geomètric (GSVM). Per avaluar el rendiment d'aquest nou enfocament, es compara aquesta nova proposta amb altres mètodes d'aprenentatge supervisat Witten et al. ( 2017 ) per a la identificació automatitzada de gènere dins de textos biogràfics d'autors literaris extrets DATASET-TH-001. S'aprova si evitar el pas comú de la lematització en la mineria de text, que elimina els sufixos de gènere en paraules rellevants per a l'anàlisi de text, millora el rendiment en la identificació de gènere. A més, es mostra l'efectivitat de l'enfocament GSVM per a l'acceleració de la fase d'entrenament de l'algorisme i es demostra que aquest mètode no afecta significativament el rendiment del procediment.
5.2.1 Criteri geomètric de parada
La geometria de la funció de decisió SVM vinculada a les dades d'entrenament és quantificable dins de cada iteració mesurant o estimant la taxa d'error. És a dir, quan aquesta taxa d'error s'estabilitza, la funció de decisió compleix amb els requisits per classificar amb èxit les dades. La Figura 5.1 mostra un exemple amb dos núvols gaussians bidimensionals. L'execució d'un SVM fins a la iteració 2 la superfície de separació representada a la Figura 5.1 a, mentre que la Figura 5.1 b mostra la superfície de separació calculada fins a la 18. La funció de decisió de la Figura 5.1 a proporciona el mateix error empíric que la funció de decisió de la 5.1 b, que va requerir més iteracions i,
Per tant, més temps d'entrenament per a la seva construcció. Per contra, la construcció de la funció de decisió a la Figura 5.1 Va necessitar menys iteracions d'entrenament.
(a) SVM run until iteration 2 (b) SVM run until iteration 18
Figura 5.1: Dues superfícies de separació calculades amb SVM: ( a ) superfície de separació obtinguda després de 2 iteracions; (b) superfície de separació calculada després de 18 iteracions.
Amb base en aquests fonaments, definem k com la taxa d'error per al conjunt d'entrenament en la iteració k i IFM > 0 com un valor real que actua com a tolerància. D'acord amb ( 2.3 ),
n X
εk = 1
n
i= 1 ( 1 −yi f(xi))+. ( 5.1 )
Sea δk = |εk −εk− 5 |. El mètode s'aturarà quan es compleixi el següent:
(δk ≤τ) ∧(δk− 5 ≤τ) ∧(δk− 15 ≤τ) ∧(|M(βk) −m(βk)| ≤ 100 ε), ( 5.2 )
on el símbol “d'una denota l'operador lògic “i”, és a dir, les quatre desigualtats dins del criteri s'han de complir simultàniament. En mesurar la desigualtat ≤k ≤ cada cinc iteracions i relaxar el criteri clàssic, podem evitar pics d'error no desitjats causats per l'aleatorietat. El següent teorema demostra que existeix una relació directa entre els criteris de detenció ( 2.12 ) y ( 5.2 ).
Teorema 2. Atès - > 0 y ε > 0, hi ha un nombre d'iteració k- –, tal que ≤k ≤ i m (k) - M ( ≤ k) ≤, (k > k- 0,
Demostració. Per Corolari 1.1, se sosté que:
l ́ım k→∞
m(βk) −M(βk) = 0
Per tant, hi ha un nombre d'iteració k- –, tal que'k'> k- 0 es compleix que:
m(βk) −M(βk) ≤ε.
Sigui el vector – la solució del problema ( 2.5 ), on xi tal que IFM i > 0 són els anomenats vectors de suport. És ben sabut que la funció f \\, que determina la superfície de decisió f - x = 0 pren la forma:
n X
f ∗(x) =
i= 1 IFM i yiK( xi, x) + b- 0, ( 5.3 )
with
b∗= − Pn i= 1 IFM i yiK( xi, x+)
2 + Pn i= 1 β∗ i yiK(xi, x−)
2,
on x+ y x IFMson dos vectors de suport en les classes + 1 y - 1, respectivament, tals que els seus multiplicadors de Lagrange associats \\ 1+ i animinen que 0 < β+ < C y 0 < β−< C.
Considerem la funció de decisió determinada pel problema ( 2.5 ), en la iteració k:
n X
f k(x) =
i= 1 k i yiK(xi, x) + bk.
És fàcil de demostrar que, "S'ha" > 0, hi ha un nombre d'iteració k---- tal que el k-)
f k(x) −f ∗(x) ≤γ. ( 5.4 )
Això es deu al Teorema 1, que garanteix que:
l ́ım k→∞βk = β∗,
i, per tant, que últim IFM > 0, hi ha un nombre d'iteració k--- tal que, k-
βk −β∗ ≤ν.
Si agafem el prou petit, ( 5.4 ) se cumple para kγ = kν. Atès - > 0, si prenem anglo prou petit en ( 5.4 ), k-k > k-23, considerant la definició ( 5.1 ), es compleix que:
δk = |εk −εk− 5 | ≤τ,
y el teorema es válido para kτ,ε = m ́ax{kε, kν}.
□
Atès que el criteri ( 5.2 ) es basa en la taxa d'error, és intuïtiu fixar un valor per a IFM. Podem fixar-lo, per exemple, en IFM = 0,0005 ja que una taxa d'error de fins 0,05 % Es pot considerar significativament baixa. Aquesta intuïció no existeix per al criteri ( 2.12 ) perquè la magnitud de g ( — ) no pot estimar-se per endavant. A la Secció 5.3, demostrarem que, per al cas particular de la identificació de gènere en textos, podem trobar superfícies de decisió generalitzates adequades que compleixen el criteri ( 5.2 ) en significativament menys iteracions que les requerides per complir amb el criteri teòric comunament utilitzat ( 2.12 ). El punt clau és l'entorn d'alta dimensió en el que es representa el text, el que permet assolir una bona generalització empírica ràpidament. Per tant, des d'un punt de vista empíric, s'espera que GSVM hereti les propietats de generalització de SVM.
5.3 Experiments
En aquesta secció, vam descriure en detall el problema d'identificació de gènere i la configuració dels experiments.
5.3.1 Plantejament del problema
Es planteja el problema de la identificació de gènere en dades textuals com una tasca de classificació d'aprenentatge supervisat. Atès un bloc de text el contingut del qual es pot etiquetar amb una etiqueta de gènere associada amb la persona descrita en el text, l'algorisme ha d'inferir automàticament aquesta etiqueta. En aquest cas, considerem dues possibles etiquetes de sortida, L = { "femenino", "masculino"}, ja que el nostre conjunt de dades experimentals només conté instàncies d'aquestes dues classes de gènere, com es descriu a la Subsecció 5.3.3. Per tant, restringim la nostra elecció d'algoritmes a aquells orientats a la classificació binària. El mateix enfocament podria estendre's per considerar etiquetes de sortida addicionals, reformulant el problema com una tasca de classificació d'una contra totes o de múltiples etiquetes.
El nostre marc de treball difereix dels enfocaments anteriors en dos aspectes prin-
xipals:
Si bé treballs anteriors segueixen procediments de mineria de text convencionals, com la derivació, evitem intencionalment aquest pas per conservar el sufix de gènere en els termes i explorar el seu impacte en la identificació de gènere per a textos en idiomes amb una forta inflexió com l'espanyol.
En lloc d'etiquetar una seqüència d'entitats amb nom en un text, abordem el problema d'assignar una etiqueta de gènere a un bloc de text o a un document complet que descriu una persona. Aquest és un problema rellevant per a moltes aplicacions, incloent- hi l'anotació automàtica d'entrades en bases de dades semàntiques.
Hi ha molts idiomes que són flexius, el que significa que les paraules poden canviar la seva forma per reflectir informació gramatical com nombre, temps o gènere Hedlund et al. ( 2001 ). En espanyol, les paraules que acaben en o.o en una consonant denoten gènere masculí, mentre que les que acaben en a "son principalment femenines. La lematització intenta eliminar les diferències entre les formes flexives d'una paraula per reduir cada paraula a la seva forma arrel. Aquest preprocessament ha estat l'enfocament estàndard en la mineria de text i la recuperació d'informació per millorar la precisió en la identificació de termes clau en un text determinat.
No obstant això, com es va esmentar anteriorment, en espanyol, el sufix de moltes paraules pot ser un indicador pràctic i directe del gènere. Per aquesta raó, sembla raonable suposar que si no apliquem la lematització i conservem en el seu lloc els sufixos de gènere, podem millorar la precisió en la identificació de gènere. Es proposa la següent estrategia per a la identificació del gènere de textos:
1. Aplica els procediments estàndard en mineria de text per a preparar el text d'entrada encara sense processar, incloent la tokenització i l'eliminació de paraules buides (es proporcionen detalls d'implementació addicionals a la Secció 5.3 ).
2. Abans de la creació de la representació vectoritzada per a cada document, els mètodes convencionals de mineria de text suggereixen la realització d'algun procés de normalització de text Sproat et al. ( 2001 ), com la lematització, per eliminar els afixos flexius, proporcionar una representació típica de paraules similars i reduir la mida del vocabulari. Al contrari, proposem suprimir aquest pas de normalització de text, conservant en el seu lloc els sufixos flexius que contenen informació addicional sobre el gènere en idiomes específics.
3. Després, vam reprendre el procés estàndard per a la preparació de documents, generant una representació vectoritzada de cada document i construint una matriu terme-document (novament, es donen més detalls a la Secció 5.3 ).
Aquesta estratègia s'aplica a la preparació de dades textuals que entrenaran un algorisme d'aprenentatge automàtic per a la identificació de gènere. Per demostrar l'aplicabilitat d'aquest procediment en un entorn real, hem dissenyat una sèrie d'experiments de validació, que es descriuen a la següent secció.
5.3.2 Configuració dels experiments
L'objectiu principal és avaluar la capacitat del nostre marc de treball proposat per a la identificació automàtica del gènere associat a documents de text del món real. Per a aquest propòsit, recuperem articles biogràfics que descriuen autors literaris de les versions en anglès i espanyol de DATASET-TH-001 les dades del qual alimenten altres sistemes basats en coneixement semàntic com a DATASET-TH-001. Per tant, es van crear dos conjunts de dades diferents, un per a cada idioma. Hem dissenyat la construcció del nostre conjunt de dades per assegurar una representació igualitària de les dues etiquetes a les entrades biogràfiques elegides per als nostres experiments en anglès i espanyol.
En implementar el nostre procediment en text d'entrada en anglès i espanyol, el nostre objectiu és confirmar si evitar la derivació té un impacte positiu en el rendiment del nostre classificador d'identificació de gènere. El nostre conjunt de dades seleccionat va consistir en biografies d'autors masculins i femenins. Aquesta elecció ens permet emmarcar l'experiment com un problema de classificació binària per al qual existeixen diversos algorismes d'aprenentatge automàtic estàndard. La figura 5.2 mostra una descripció general del procediment experimental per avaluar cada mètode d'aprenentatge supervisat.
Cada conjunt de dades de biografies en anglès i espanyol es divideix en els subconjunts d'entrenament i prova. Específicament, el 70 % de les biografies en cada idioma s'utilitzen per a l'entrenament, mentre que el 30 % restant es conserva com un conjunt de proves per avaluar el rendiment dels algorismes d'aprenentatge supervisat. La següent secció proveeix detalls addicionals sobre la recuperació i preparació d'ambdós conjunts de dades.
5.3.3 Conjunts de dades utilitzades
Comencem, recuperant biografies d'autors literaris de DATASET-TH-001 seguint la seva web directament mitjançant la utilització del paquet DATASET-TH-001 Keys i Til-
Figura 5.2: Descripció del marc proposat per provar mètodes alternatius d'aprenentatge supervisat.
SOFTWARE-TH-003 ( 2017 ), disponible per a l'entorn estadístic R, ORG-TH-112 ( 2022 ). Aquest paquet pot obtenir una llista de pàgines, subcategories, contingut de pàgines i altra informació sobre una categoria específica.
El conjunt de dades disponible públicament en anglès Gomez et al. ( 2021 a), 4 conté 1000 biografies d'escriptors extretes de DATASET-TH-001 en idioma anglès. Aquests articles estan dividits equitativament en un conjunt de dones i un conjunt d'homes. Les biografies de dones s'han extret de la categoria “escritores_mulleres_del_siglo XIX”, mentre que les primeres 500 pàgines de la categoria "escritors_homes_del_ siglo XIX" s'han obtingut per a les biografies d'homes.
El conjunt de dades disponible públicament en espanyol Gomez et al. ( 2021 b),
5 conté 832 biografies extretes de DATASET-TH-001 en llengua espanyol. Les biografies de dones s'han extret de la categoria "Escriptores d'Espanya". En contrari, les primeres 416 pàgines de la categoria "Escriptors d'Espanya del segle XX" s'han recuperat per a les biografies d'homes. Per tant, aquestes biografies també es divideixen en dos subconjunts, un de dones i un altre d'homes.
La Taula 5.1 Resumeix algunes estadístiques generals d'una anàlisi exploratòria preliminar dels conjunts de dades en anglès i espanyol descrits anteriorment.
Demanem prèviament cada biografia utilitzant un paquet R de mineria de text tm Feinerer et al. ( 2008 ). Eliminant de les biografies les paraules buides (palabres comunes que normalment no aporten informació útil per a l'anàlisi) Eisens-
4 [LINK-REDACTED] 5 [LINK-REDACTED]
Taula 5.1: Nombre total i mitjà que descriu els conjunts de dades en anglès i espanyol.
Dataset Descriptive statistics Value
Total number of biographies of female authors 500 Avg. number of distinct terms per female writer biography 50,86
Avg. number of distinct terms per female writer biography (stemming) 38,11
English
Total number of biographies of male authors 500 Avg. number of distinct terms per biography of male writer 46,2
Avg. number of distinct terms per male writer biography (stemling) 35,62
Total number of biographies of female authors 416 Avg. number of distinct terms per female writer biography 50,03
Avg. number of distinct terms per female writer biography (stemming) 31,44
Spanish
Total number of biographies of male authors 416 Avg. number of distinct terms per male writer biography 51,39
Avg. number of distinct terms per male writer biography (stemling) 32,68
tein ( 2019 ), nombres, signes de puntuació i espais en blanc. Més tard, el text de cada biografia es converteix a minúscules i es crea la matriu terme-biografia corresponent, com es presenta a la Taula 5.2. D'aquesta manera, cada conjunt biogràfic es pot representar com una matriu m × n, on m és el nombre de termes únics en el diccionari i n és el nombre de biografies en el conjunt d'entrenament. Cada element wij de la matriu terme-biografia representa la importància o el pes del terme i en la biografia j. Per obtenir el valor de wi j utilitzem la mesura TF-IDF Aizawa ( 2003 ), calculada com a ( 5.5 ):
!, ( 5.5 )
wij = t fi j × log n
d fi
on t fi j denota el nombre d'ocurrències del terme i en la biografia j; n és el nombre total de biografies del conjunt d'entrenament; i, finalment, d fi és el nombre de biografies en què apareix el terme i.
Cal assenyalar que només les biografies d'entrenament contribueixen a la construcció del diccionari de termes que representa totes les biografies. És a dir, quan el classificador comprova noves biografies sobre el subconjunt de prova, quin-
Taula 5.2: Exemple de matriu terme-biografia, on wi j representa la importància del terme i a l'entrada biogràfica j.
Dictionary Biography 1 Biography 2... Biography n
University w11 w12... w1n Marriage w21 w22... w2n Novel w31 w32... w3n........ Writer wm1 wm2... wmn
Quir terme no trobat en les biografies del conjunt d'entrenament s'ignora per al càlcul de la distància. Així mateix, en el nostre estudi no s’han considerat sinònims, abreviatures o formes alternatives per a un terme determinat.
5.3.4 Resultats
En aquesta secció es presenten els resultats d'experiments que comparen diferents estratègies per a la identificació de gènere en textos. Els experiments per a cada algorisme de classificació impliquen deu assajos de divisions de prova d'entrenament seleccionades a l'atzar. Amb l'objecte de poder donar suport als resultats, s'han realitzat tests d'hipòtesis estadístiques de Wilcoxon Hollander et al. ( 2013 ), havent considerat la significança estadística per a valors de p inferiors a 0, 05.
GSVM versus estàndard SVM
Les següents seccions resumeixen els resultats dels experiments d'avaluació que comparen GSVM amb SVM estàndard en el problema de la identificació de gènere del text.
Comparació del nombre d'iteracions: GSVM versus SVM estàndard
La taula 5.3 compara el recompte d'iteracions per a GSVM i un SVM típic usant el criteri d'aturada clàssic. És clar que, en mitjana, per al conjunt de dades en espanyol, GSVM convergeix a aproximadament 18 % (amb derivats) i 25 % (sense derivats) menys iteracions que l'enfocament SVM estàndard. Al seu torn, per al conjunt de dades disponible en anglès, GSVM permet reduir el nombre d'iteracions en aproximadament 42 % (amb derivats) i 44 % (sense derivats). Els grans valors en la desviació estàndard per a GSVM són una conseqüència que ambdós enfocaments assoleixen el nombre màxim definit d'iteracions per a alguns experiments, entenent-se com el nombre d'iteracions de l'enfocament SVM estàndard.
El test de Wilcoxon sobre el conjunt de dades disponibles en anglès mostra que la millora de GSVM sobre SVM és estadísticament significativa, tant quan s'apli-
ca el stemming ( valor p = 0,00195 ) com quan no s'aplica ( valor p = 0,00589 ). Si observem el cas de les biografies en espanyol, la millora és estadísticament significativa quan no s'inclou el stemming (valor p = 0,00195 ), però no és significativa quan s'utilitza el stemming ( valor p = 0,1 ).
Taula 5.3: Mitjana (prom.) i desviació estàndard (d.e. ) del recompte d'iteracions en les etapes d'entrenament.
Language Method Stemming No stemming
avg. s.d. p-value avg. s.d. p-value
Spanish SVM 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
English SVM 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
Les figures 5.3 a, 5.3 b, 5.4 a y 5.4 b mostren gràficament, per a cada experiment, en quin recompte d'iteracions GSVM i SVM estàndard detenen la seva execució d'entrenament, respectivament. El criteri de detenció de GSVM detecta l'instant en el que l'indicador de la taxa d'error s'estabilitza (línia de punts) sempre. Per contra, el criteri de detenció SVM clàssic requereix un major nombre d'iteracions per aturar- se sense proporcionar cap millora de la taxa d'error.
S'ha de destacar que el desenvolupament del criteri de parada de GSVM per a biografies en anglès sigui similar, independentment de si s'aplica o no el preprocessament de lematització (ver Figures) 5.3 b y 5.4 b). Una altra troballa notable és que la taxa d'error per a biografies en espanyol (ver Figures) 5.3 a y 5.4 a) exhibeix un patró oscil·lant quan s'aplica el preprocessament de derivació (Figura 5.4 a). Aquest comportament es pot deure a una pèrdua significativa d'informació introduïda per l'operació de derivació en aquest idioma.
Per últim, cal esmentar que les mètriques d'avaluació són molt similars, en tots els casos, per a les etiquetes de sortida "femení" i "masculí" en ambdós idiomes.
Comparació de la precisió de GSVM vs. SVM estàndard
Amb l'objectiu d'avaluar el rendimient de la tècnica SVM estàndard amb el GSVM observem les mètriques de precisió, recall i puntuació F1 Baeza-Jates i Ribeiro-Neto ( 2011 ); Soklova i Lapalme ( 2009 ); Olson i Delen ( 2008 ). La taula 5.4 mostra una comparació SVM i GSVM per a biografies en anglès, amb i sense derivació. Per a cada mètode i mètrica, aquesta taula mostra la mitjana (avg). i la desviació estàndard (s.d.). A més, es mostra el valor p del test de Wilcoxon per cada comparació. Els resultats del test de Wilcoxon indiquen que no hi ha diferències estadísticament significatives per a cap de les mètriques considerades, tal com s'indica a la columna del valor p, on tots els valors són més grans que 0,05.
(a) Spanish language
(b) English language
Figura 5.3: Sense derivació. Comparació dels criteris de detenció en el cas de no utilitzar el preprocessament de derivació.
Els resultats exposats a les taules 5.4 y 5.5 Es mostren empíricament que per als problemes d'identificació de gènere de text, les tècniques de GSVM hereten les mateixes propietats de les del SVM, proporcionant resultats de precisió similars.
La taula 5.5 mostra una comparació de SVM i GSVM per a biografies en espanyol, amb i sense derivació. Novament, per a cada mètode i mètrica, aquesta taula mostra la mitjana (av.), la desviació estàndard (s.d.) i els valors p corresponents de la prova de Wilcoxon. De manera similar a les biografies en anglès, els resultats de la prova de Wilcoxon indiquen que no hi ha diferències estadísticament significatives per a cap de les mètriques (els valors p són més grans que 0.05 ). Com a consecuen-
(a) Spanish language
(b) English language
Figura 5.4: Comparació dels criteris de detenció quan s'aplica el preprocessament de derivació.
Taula 5.4: Anglès. Mètriques de rendiment SVM i GSVM per a biografies en classificació en anglès, amb i sense derivació.
Stem. Gender Method Precision Recall F1 score
avg. (s.d.) p-value avg. (s.d.) p-value avg. (s.d.) p-value
No Female SVM 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
Male SVM 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Yes Female SVM 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
Male SVM 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
cia, la caiguda en el nombre d'iteracions assolides per GSVM no afecta la precisió de
la classificació.
Taula 5.5: Espanyol. Mètriques de rendiment SVM i GSVM per a biografies en classificació en espanyol, amb i sense derivació.
Stem. Gender Method Precision Recall F1 score
avg. (s.d.) p-value avg. (s.d.) p-value avg. (s.d.) p-value
No Female SVM 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
Male SVM 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Yes Female SVM 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Male SVM 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
La taula 5.6 mostra per a GSVM una comparació entre la derivació i la no- derivació, juntament amb els valors p corresponents. Per a les biografies en espanyol, els resultats mostren una degradació significativa quan s'inclou la derivació, amb valors p de 0, 0097, 0, 00586 y 0, 00195, per a precisió, recall i puntuació F1, respectivament, en el gènere femení; i valors p de 0, 0137, 0, 00195 y 0, 00195, per a precisió, recall i puntuació F1, respectivament, en el gènere masculí. En canvi, per a les biografies en anglès, els valors p per a totes les mètriques superen el nivell de significació de 0,05 el que indica l'absència d'un efecte significatiu.
Taula 5.6: Comparació de mètriques de rendiment de la derivació versus la no derivació quan s'aplica el mètode GSVM.
Language Gender Stem Precesion Recall F1 score
av. ~ ~ ~ p-value avg. p-value avg. p-value
Spanish Female No 0,909 0,0097 0,907 0,00586 0,903 0,00195 Yes 0,770 0,781 0,747
Male No 0,889 0,0137 0,913 0,00195 0,891 0,00195 Yes 0,724 0,790 0,713
English Female No 0,908 0,343 0,859 0,124 0,879 1 Yes 0,880 0,898 0,888
Male No 0,823 0,108 0,909 0,286 0,843 0,636 Yes 0,899 0,884 0,891
GSVM vs. altres algorismes
En aquesta subsecció es compara el rendiment i el temps d'entrenament del mètode GSVM amb altres mètodes d'aprenentatge automàtic, com, Random Forests (RF) Breman ( 2001 ) i Boosting Schapire ( 1990 ), procedents de llibreries de programari d'ús comú. En aquestes proves, els hiperparàmetres dels algorismes es fixen en els seus valors per omissió. Per a cada algorisme i idioma, comparem dos fluxos de treball de mineria de text alternatius per a cada mètrica: i) inclouen un pas de derivació, com en la major part de les aplicacions de mineria de text convencionals; i ii) eviten la derivació, conservant els afixos que proporcionen informació de gènere addicional en alguns idiomes. Usem el temps com a mètrica
de comparació, atès que no hi ha possibilitat de comparar justament els recomptes d'iteracions, ja que la implementació de cada mètode segueix un enfocament d'iteració diferent.
Comparació del temps d'entrenament: GSVM versus altres algorismes
La taula 5.7 Resumeix el temps d'execució (en segons) per a totes les versions dels algorismes utilitzats en aquesta investigació. Usant derivació per a l'idioma espanyol, GSVM és, en mitjana, fins 10,05 més ràpid que el mètode Boosting i 42,87 vegades més ràpid que RF, mentre que, per a l'idioma anglès, GSVM és, en mitjana, fins 15,79 vegades més ràpid que Boosting i 59,15 vegades més ràpid que RF. Quan no s'aplica derivació, per a l'idioma espanyol, GSVM és, en mitjana, fins 49,63 vegades més ràpid que Boosting i 81,00 vegades més ràpid que RF. Pel que fa a l'anglès, GSVM és, en mitjana, fins 22,91 vegades més ràpid que Boosting i 77,70 vegades més ràpid que RF. En resum, amb base en la prova de Wilcoxon realitzada, la columna de valor p indica una diferència estadísticament significativa entre els mètodes, la qual cosa demostra que el temps d'entrenament de GSVM és consistentment menor que en els altres mètodes.
Taula 5.7: Mitjana (avg ) i desviació estàndard (s.d. ) del temps d'entrenament.
Language Method Stemming No stemming
avg. (s.d.) p-value avg. (s.d.) p-value
Spanish GSVM 3,096 ( 0,460 ) 2,889 ( 0,150 ) Boosting 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
English GSVM 3,799 ( 0,074 ) 3,883 ( 0,525 ) Boosting 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
Comparació de precisió: GSVM versus altres algorismes
Com que la derivació no sembla ser significativa en processar biografies en anglès, per raons d'espai, centrarem la resta de la nostra anàlisi en les biografies en espanyol. La taula 5.8 mostra una comparació de derivació versus no derivació, i els valors p corresponents, per a GSVM, Boosting i Random Forest. GSVM obté resultats molt prometedors, especialment quan no s'usa derivació, amb precisió, recall i puntuació F1 per sobre del 90 % en la major part dels casos, encara que Boosting i Random Forest milloren principalment els resultats de GSVM. Fet, que constata que ambdues tècniques pertanyen als coneguts com a mètodes de conjunt (Sagi i Rokach, 2018 ). En entrenar múltiples models i integrar les seves prediccions, aquests mètodes milloren el rendiment predictiu d'un sol model. Cal destacar que, atès que GSVM es comporta com un SVM estàndard en termes de precisió, aquests resultats demostren la importància de la derivació davant de la no derivació en idiomes com l'espanyol. Aquesta tècnica de preprocessament també
afecta els resultats que s'obtindrien utilitzant altres tipus de classificadors.
A més, els valors p de la taula 5.8 Es mostra una degradació significativa en el rendiment de tots els algorismes quan s'aplica la derivació. Aquests resultats mostren consistentment que per a l'idioma espanyol, sense derivació, la precisió, la recuperació i la puntuació F1 són superiors al 90 % en la majoria dels casos, mentre que en usar derivació es produeix un arrodoniment de degradació del 15 %.
Taula 5.8: Mètriques de precisió per a mètodes sobre biografies en espanyol.
Method Gender Stem Precesion Recall F1 score
avg. (s.d.) p-value avg. (s.d.) p-value avg. (s.d.) p-value
GSVM Female No 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 Yes 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Male No 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 Yes 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Boosting Female No 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 Yes 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
Male No 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 Yes 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF Female No 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 Yes 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
Male No 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 Yes 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 Conclusions
En aquesta secció, considerem algunes explicacions per a les diferències detectades en el rendiment d'identificació de gènere i aquestes reflexionen sobre possibles limitacions en el nostre treball.
5.4.1 Comparació d'algorismes de classificació
Els resultats suggereixen que el control de l'aplicació Stemming en la preparació de dades textuals, les mètriques de rendiment són bastant similars, independentment de l'algorisme d'aprenentatge automàtic seleccionat per a la classificació. No obstant això, hi ha diferències depenent del llenguatge utilitzat.
Com a resultat, podem concloure que els algorismes de classificació d'aprenentatge automàtic per a la identificació de gènere es poden veure directament afectats pels sufixos presents en els conjunts de dades utilitzats per entrenar els algorismes. Els nostres resultats confirmen que el preprocessament de Stemming, un mètode que aparentment simplifica el problema de classificació, pot induir la confusió de gènere per resoldre el problema en qüestió.
5.4.2 Impacte de l'eliminació de stemming
Un dels objectius principals del marc proposat és explorar si la retenció d'elements morfològics que contenen informació de gènere en alguns idiomes, com l'espanyol, poden proporcionar un rendiment de classificació superior per a la identificació de gènere en el text. D'acord amb els resultats presentats a les taules 5.6 y 5.8 Hi ha un increment bastant notable en el rendiment de classificació en espanyol per als algorismes considerats en els nostres experiments quan el pas de derivació s'elimina del procés de preparació de dades.
Per contra, els resultats per a l'idioma anglès indiquen una variació mínima en la mètrica de puntatge de F1 entre l'aplicació de Stemming o no en el procés de preparació de dades per a qualsevol algorisme de classificació. Aquest llenguatge té resultats similars respecte a la precisió i les mètriques de rendiment del recall.
De manera global, aquests resultats recolzaven la nostra consideració inicial que evitar l'aplicació del Stemming pot afectar positivament la identificació de gènere en els textos Quan el contingut està disponible en idiomes que proporcionen detalls morfològics addicionals que porten informació de gènere, com l'espanyol. Confirmant el coneixement obtingut en investigacions prèvies sobre la importància de la fase de preparació de les dades, sobretot si es treballa amb idiomes diferents de l'anglès Uysal i Gunal ( 2014 ).
5.4.3 Limitacions
El nou mètode GSVM que introdueix un criteri de detenció primerenc per a la fase d'entrenament funciona bé pel problema específic de la identificació de gènere de text. Per tant, s'han de realitzar experiments addicionals per avaluar el rendiment de GSVM en altres tasques de classificació abans de recomanar GSVM com una innovació metodològica general de SVM en l'aprenentatge automàtic.
Pel que fa al marc proposat per a la identificació de gènere de text, una limitació important del nostre entorn experimental és que circumscrivim la variable de gènere objectiu a una elecció binària. Problema plantejat per altres autors Hamidi et al. ( 2018 ); Keys ( 2018 ). De fet, va trobar que 55 de 58 estudis per a la identificació automàtica de gènere amb aprenentatge automàtic van assumir una sortida de gènere binària. En aquest sentit, una possible ruta per a futures investigacions podria ser reemplaçar els nostres algorismes de classificació binària amb una alternativa com podries ser models d'aprenentatge automàtic que admetin objectius continus i/o multivariants. En aquests contextos, seria interessant avaluar si els sufixos de gènere encara proporcionen alguns avantatges per a la identificació de gènere.
Una altra limitació del nostre enfocament és que el text d'entrada pot no estar disponible en un idioma fortament inflexionat, diferent de l'anglès. No obstant això, en aquest cas, el text es podria traduir automàticament d'anglès a espanyol o altres idiomes amb propietats similars a través de Serveis automatitzats. Aquesta versió traduïda del text d'entrada pot proporcionar informació de gènere addicional que permet optimitzar el rendiment de la classificació. De la mateixa manera, es necessita més investigació per confirmar que aquests resultats inicials que comparen anglès i espanyol són replicables amb l'entrada de dades en idiomes alternatius.
5.4.4 Innovació
En aquesta investigació, presentem un nou criteri de detenció pels algorismes d'optimització de vectors de suport basats en les propietats geomètriques de la representació vectorial del contingut de text amb l'objectiu de resoldre el problema de la identificació de gènere automatitzat. Per a aquest problema en particular, ensenyem que l'algorisme proposat requereix menys temps per a l'entrenament si el comparem amb l'aplicació d'algorismes SVM estàndard. Pel que fa al marc, en comptes de seguir els procediments de normalització convencionals en la mineria de text que eliminen els afixos de gènere, com la derivació, conservem aquests elements morfològics trobats en llenguatges fortament infligits per tal d'eliminació el rendiment dels mètodes d'identificació de gènere. Evalua l'efectivitat d'aquest nou enfocament en termes de temps de capacitació comparant diferents algorismes d'aprenentatge automàtic per a la classificació, usant un conjunt de dades d'entrades biogràfiques de DATASET-TH-001 en anglès i espanyol.
Els nostres resultats suggereixen que evitar la derivació (stemming) en el preprocessat del text per a idiomes que inclouen elements addicionals que incorporen informació de gènere, com l'espanyol, és positiu. Aquest canvi de procediment no afecta cap altre idioma neutral com l'anglès.