Testuen datu-multzo handi eta aberatsak eskuragarri egoteak, batez ere web edukietatik sortuak, datuen meatzaritza, algoritmoak eta ikasketa automatikorako metodo aurreratuak sustatu ditu, aurrekaririk gabeko erritmoan. Horrek interes handia sortu du Aggarwal testu analisirako ikaskuntza automatikoaren ikerketari buruz ( 2018 ). Gaur egun, Srivastava eta Sahami testu meatzaritza ( 2009 ) eta hizkuntza naturalaren (PLN) prozesamendua Eisenstein (HPS) 2019 ) ikerketa eta inplementazio horietako askoren oinarria dira.
5.1 Sarrera
DATASET-TH-001 Vrandeci 'c eta Krötzsch ( 2014 ) datu iturri egituratu baten eta sarbide libreko baten adibidea da, eta honako artikuluetatik ateratako informazioaz elikatzen da: DATASET-TH-001 hizkuntza askotan. Artikuluen datuak DATASET-TH-001 idazpen semantikoko prozesu baten menpe jartzen dira, ezagutza-oinarria handitzeko DATASET-TH-001, aplikazio berriak integratzeko grafikoetan egituratutako datu-ereduari jarraituz.
Aplikazio-eremu horietako bat testuan generoaren identifikazioa da. Helburua da genero etiketa bat (adibidez, darifemenino Coresio edo chemasculino Irujo) testu-bloke bati esleitzea, hizkuntz propietateetan eta beste ezaugarri deskribatzaile batzuetan oinarrituz. Oro har, aurreko ikerketak testua idazten duen pertsonaren generoa eta profila identifikatzean oinarritu dira. Adibide batzuk ondorengoak dira: Yan eta Yan blogen egileen genero identifikazioa ( 2006 ) eta mikrobloging-ena
Mukherjee eta Bala ( 2017 ) edo bezeroarekiko harremanak kudeatzeko sistemen erabiltzaileengan (CRM) Amado et al. ( 2018 ).
Sarrera berriak sortzea DATASET-TH-001 existitzen diren pistetan eta artikuluetan egituratutako datuetan oinarritzen da DATASET-TH-001 gai bakoitza osatzeko. Adibidez, ARIGabriel García Márquez Egañari buruzko datuak berreskuratu nahi baditugu, hemen bilatu dezakegu DATASET-TH-001 dagokion sarrera 2. Gero, pertsona horri buruzko ezaugarri deskribatzaileak dituzten hainbat eremu azter ditzakegu, Éhsexoa edo generoa barne. 3. Adibide honetan, jabetza honen balioa skamaskulinoa da. Artikulu hau idazteko unean, informazio honen zehaztasuna arten oinarritzen da. 6 hainbat artikuluri buruzko erreferentziak DATASET-TH-001 balio "maskulinoaren" ekarpena babestu dezaten.
eremu hau datu egituratuetan oinarrituta. Hala ere, ezagutzaren elkarlanerako proiektu ireki gisa, DATASET-TH-001 sarritan izan ditu bandalismoa eta eduki-erasoak Adler et al. ( 2011 ); Geiger eta Ribes ( 2010 ). Agente maliziosek artikuluen jatorrizko datu egituratuak aldatzen badituzte DATASET-TH-001, eskuzko ikuskapenik gabe erroreak detektatzea lan konplexua litzateke, are gehiago datu- basearen tamaina handia emanez DATASET-TH-001. Gainera, generoari buruzko informazio egituraturik ez badago artikulu batean: DATASET-TH-001, ezin zaio balore bat zuzenean jabetzari "sexua edo generoa" esleitu sartu ahal izateko DATASET-TH-001 Dagokiona. Aldiz, generoaren informazioa etiketatu testu-datuen analisi automatiko baten arabera, honako artikulu hauen gorputzean egituratuta ez daudenen arabera: DATASET-TH-001 arazo hauen aurrean erreilientzia hobetu nezake. Adibide hau erraz atera daiteke genero-etiketa bat duen testu-bloke baten edukia automatikoki etiketatu behar duen beste edozein informazio-sistematara.
Kasu zehatz batean oinarritzen gara, testu biografiko batean deskribatutako pertsonaren generoa automatikoki determinatzeko arazoa. Lan honetan, arazo hau genero identifikazio gisa aztertuko dugu. Ingelesaz bestelako hizkuntzak barne hartzen dituzten ikasketarik ezak testu meatzaritzan prozedura berriak garatzea zailtzen du arazo honi hobeto heltzeko. Ingelesez bakarrik zentratu beharrean, genero-elementu gutxiago ematen baititu, espainiar testuak genero-informazioa daramaten morfemak harrapatzeko erabiltzen duen erabilera aztertzen dugu, eta hizkuntza horretan sarriago gertatzen dira. Hori lortzeko, ohiko testu-meatzari buruzko ohiko normalizazio-bideak saihestuko ditugu, hala nola, Eisensteinen deribatuak eta lematizazioa. 2019 ), hizkuntzalaritza aldetik generoari buruzko informazioa baztertzen dutelako. Ikuspegi horri jarraituz, frogatu dugu genero-balio bat zehaztasun handiagoz eman dakiokeela testu-edukiari.
Ikasketa automatikoko tekniken bidez testua prozesatzen denean, utili ohikoa da--
2 [LINK-REDACTED] 3 [LINK-REDACTED]
Ts. Errepresentazio bektorialak, dimentsio eta sakabanatze handiko ezaugarri direnak, zero balio duten osagai asko dituzte eta. Dimentsio handiko irudikapen sakabanatuen inguruan, euskarri bektoreen (SVM) Mogerza et al. ( 2006 ) Joachims ordenagailuz egokiak diren sailkatzaileak dira ( 2002 ). Hala ere, SVM Joachims sailkapenerako optimizazio arazoak konpontzeko teknika tradizionalak egokitzea ( 1999 ) Genero identifikazioari aplikatuta, ez du konbergentzia azkarrik bermatzen iterazioak azpiko optimizazio-arazoaren soluzio egokira hurbiltzen direnean.
5.2 Proposamena
Atal honetan, SVMen markoaren barruan, testu generoa identifikatzeko zereginaren propietate geometrikoak erabiltzen dira azpiko optimizazio algoritmoaren atxilotze-irizpidea aldatzeko, Karush-Kuhn-Tucker Feng eta Li irizpide klasikoaren ordez ( 2018 ) Optimizazio klasikoko SVM algoritmoak betetzen saiatzen den irizpidearekin matematikoki zerikusirik ez duen informazioa (errore-tasa) biltzen duen proposamen berri batengatik, algoritmoaren izaera arazo geometrikora molda daitekeelako. Aurrerantzean, SVM geometrikoa (GSVM) bezala aldatutako SVM horri buruz ari da. Ikuspegi berri honen errendimendua ebaluatzeko, proposamen berri hau Witten et al ikaskuntza gainbegiratuko beste metodo batzuekin alderatzen da ( 2017 ) generoaren identifikazio automatizatua egiteko, literaturatik ateratako egileen testu biografikoetan DATASET-TH-001. Testu-meatzarian lematizazioaren ohiko urratsa ez egitea ebaluatzen da, testu-analisiarako hitz esanguratsuetan genero-atzizkiak ezabatzen baititu, generoaren identifikazioko errendimendua hobetzen baitu. Gainera, GSVM ikuspegiaren eraginkortasuna erakusten da algoritmoaren entrenamendu-fasea bizkortzeko eta metodo honek ez duela modu esanguratsuan eragiten erakusten da.
5.2.1 Gelditze-irizpide geometrikoa
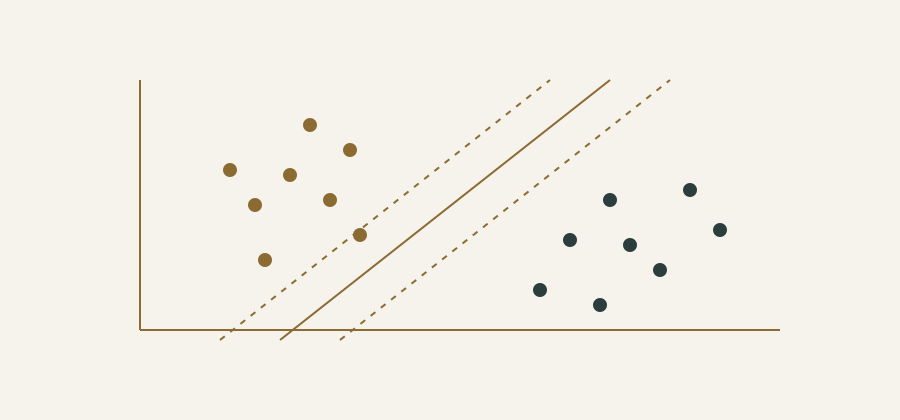
SVMren erabaki-funtzioaren geometria, entrenamendu-datuekin lotuta, iterazio bakoitzaren barruan neurgarria da errore-tasa neurtuz edo balioetsiz. Hau da, errore-tasa egonkortzen denean, erabaki-funtzioak datuak arrakastaz sailkatzeko baldintzak betetzen ditu. Irudia 5.1 bi hodei gaussiar bi dimentsioko adibide bat erakusten du. SVM bat exekutatu iteraziora arte 2 irudian irudikatutako banaketa gainazala sortzen du 5.1 a, iruditzen duen bitartean 5.1 b- iterazioraino kalkulatutako banaketa gainazala erakusten du 18. Irudiko erabaki funtzioa 5.1 a imajinaren erabakitze funtzioa bezalako errore enpirikoa ematen du 5.1 b, iterazio gehiago behar izan zituena eta,
beraz, denbora gehiago behar da lan egiteko. Aitzitik, erabaki-funtzioaren eraikuntza figuran 5.1 entrenamendu iterazio gutxiago behar izan zituen.
(a) SVM run until iteration 2 (b) SVM run until iteration 18
Irudia 5.1: SVM-rekin kalkulatutako banaketa gainazal bi: (a) horren ondoren lortutako banaketa azalera 2 iterazioak; (b) banantze gainazal kalkulatua, ondoren 18 iterazioak.
Oinarri hauetan oinarrituta, k eta STEK iterazioan entrenamenduak egiteko akats tasa bezala definitzen dugu. 0 tolerantzia gisa jokatzen duen balio erreal bat bezala. Bat dator ( 2.3 ),
n X
εk = 1
n
i= 1 ( 1 −yi f(xi))+. ( 5.1 )
Sea δk = |εk −εk− 5 |. Metodoa geldituko da honako hau betetzen denean:
(δk ≤τ) ∧(δk− 5 ≤τ) ∧(δk− 15 ≤τ) ∧(|M(βk) −m(βk)| ≤ 100 ε), ( 5.2 )
non zaharrak eragile logikoa adierazten duen, hau da, irizpidearen barruko lau desberdintasunak aldi berean bete behar diren. Bost iteraziotik behin eta irizpide klasikoa erlaxatuz, aleazioak eragin ez dituen errore-piezak ekidin ditzakegu. Hurrengo teoremak frogatzen du harreman zuzena dagoela atxilotze-irizpideen artean ( 2.12 ) y ( 5.2 ).
Teoroma 2. Dado 9.000 > 0 y ε > 0, iterazio-kopuru bat dago: kSTEL, CASTELET, H( 12k) STEM (K) STEF, STEK > KARTEL, STEM.
Demonstrazioa Korolario bidez 1.1, uste da:
l ́ım k→∞
m(βk) −M(βk) = 0
Beraz, kity iterazio-kopuru bat dago, eta honela betetzen da:
m(βk) −M(βk) ≤ε.
Demagun arazoaren soluzioa ( 2.5 ) non x- tan i > 0 euskarri bektoreak deitzen direnak dira. Ongi jakina da f ^ funtzioa, f ÉR( x) = erabaki-azalera zehazten duena 0, hartu forma:
n X
f ∗(x) =
i= 1 ^ i yik(xi, x) + bction, ( 5.3 )
wuth
b∗= − Pn i= 1 i yik( x, x+)
2 + Pn i= 1 β∗ i yiK(xi, x−)
2,
x+ eta xWherson bi euskarri- bektore + 1 y - 1 001+ eta trumilkatzaileen ustez 0 < β+ < C y 0 < β−< C.
Azter dezagun problemak erabakitzen duen erabaki-funtzioa ( 2.5 ) k iterazioan:
n X
f k(x) =
i= 1 001k i yik(xi, x) + bk.
Erraza da frogatzen, 0 iterazio-kopuru bat dago, k (10)k > kLATO:
f k(x) −f ∗(x) ≤γ. ( 5.4 )
Hau Teoromari zor zaio. 1, hau bermatzen duena:
l ́ım k→∞βk = β∗,
eta, beraz, zera > 0 iterazio-kopuru bat dago, eta honela betetzen da:
βk −β∗ ≤ν.
Behar bezain txikia hartzen badugu, ( 5.4 ) se cumple para kγ = kν. Dado 9.000 > 0, RIF hartzen badugu behar bezain txikia ( 5.4 ) qek > kSTENE, definizioa kontuan hartuz ( 5.1 ) Honako hau betetzen da:
δk = |εk −εk− 5 | ≤τ,
y el teorema es válido para kτ,ε = m ́ax{kε, kν}.
□
Irizpidea kontuan hartuta ( 5.2 ) errore-tasan oinarritzen da, intuitiboa da balio bat ezartzea Ére-rentzat. Adibidez, = = 0,0005, zeren eta errore- tasa bat 0,05 % esanguraz baxutzat jo daiteke. Intuizio hau ez da irizpidearentzat existitzen ( 2.12 ) g( 1957)-ren magnitudea ezin delako aldez aurretik aintzat hartu. Atalean 5.3, erakusten dugu, testuetan generoa identifikatzeko kasu partikularrerako, irizpidea betetzen duten erabaki orokortzaile egokien azalerak aurki ditzakegula ( 5.2 ) esanguratsuki, erabili ohi den irizpide teorikoa betetzeko eskatutakoak baino iterazio gutxiagotan ( 2.12 ). Funtsezko puntua testua irudikatzen duen dimentsio handiko ingurunea da, eta horrek azkar orokortze enpiriko ona lortzea ahalbidetzen du. Beraz, ikuspegi enpiriko batetik, espero da GSVMk SVMren orokortze-ezaugarriak hartzea.
5.3 Esperimentuak
Atal honetan, zehatz-mehatz deskribatzen ditugu generoa identifikatzeko arazoa eta esperimentuen konfigurazioa.
5.3.1 Arazoa planteatzea
Generoa testu-datuetan identifikatzeko arazoa planteatzen da, gainbegiratutako ikaskuntzaren sailkapen-lan gisa. Testu-bloke bat hartuta, testuan deskribatutako pertsonari lotutako genero-etiketa batekin etiketatzeko, algoritmoak automatikoki atera behar du etiketa hori. Kasu honetan, bi irteera-etiketa onartzen ditugu, L = {Mahizefemenino (1000), mámasculino}, gure datu esperimentalen multzoak bi genero mota hauen eskaerak bakarrik baititu, Subsekzioan azaltzen den bezala. 5.3.3. Beraz, bi urteko sailkapenera bideratutako algoritmoak aukeratzea murrizten dugu. Ikuspegi bera hedatu daiteke irteera-etiketa gehigarriak aztertzeko, arazoa etiketa guztien edo anitzen arteko sailkapen-lan gisa birformulatuz.
Gure lan-esparrua ez da aurreko ikuspegietatik bereizten, bi alderdi nagusitan:
cipalak:
Aurreko lanek ohiko testuetako meatzaritza-prozedurak jarraitzen badituzte ere, hala nola deribazioa, nahita ekidingo dugu urrats hori, genero-atzizkia terminoetan mantendu eta hizkuntzako testuetan generoaren identifikazioan duten eragina aztertzeko, espainiera bezalako inflexio handiarekin.
Testu batean izena duten entitateen sekuentzia etiketatu ordez, testu bati genero-etiketa edo pertsona bati deskribatzen dion dokumentu osoari esleitzearen arazoa jorratzen dugu. Hau aplikazio askorentzat arazo garrantzitsua da, sarreren ohar automatikoa datu base semantikoetan barne.
Hizkuntza asko daude malguboak direnak, eta horrek esan nahi du hitzek beren forma alda dezaketela informazio gramatikala adierazteko (zenbaki, denbora edo Hedlund et al.) 2001 ). Gazteleraz, kontsonante batean amaitzen diren hitzak gizonezkoen generoa adierazten dute, eta a"n bukatzen direnak, berriz, femeninoak dira batez ere. Sinpletizazioa hitz baten forma flexiboen arteko aldeak ezabatzen saiatzen da, hitz bakoitza bere erro-formara murrizteko. Aurre-prozesamendu hori testu meatzaritzaren ikuspegi estandarra izan da eta informazioa berreskuratzea testu jakin batean gako-hitzen identifikazioan zehaztasuna hobetzeko.
Hala ere, lehenago gaztelaniaz aipatu zenez, hitz askoren atzizkia generoaren adierazle praktiko eta zuzena izan daiteke. Horregatik, arrazoizkoa dirudi pentsatzea ez badiogu lematizazioa aplikatzen eta genero atzizkiak bere lekuan mantentzen baditugu, genero identifikazioan zehaztasuna hobetu dezakegula. Testuen generoa identifikatzeko honako estrategia proposatzen da:
1. Testuen meatzaritzako prozedura estandarrak aplikatzea oraindik prozesatu gabeko sarrerako testua prestatzeko, tokenizazioa eta hitz hutsak ezabatzea barne (atalean ezarpen gehigarriko xehetasunak ematen dira 5.3 ).
2. Dokumentu bakoitzerako ordezkaritza bektoriala sortu aurretik, testu meatzaritzaren ohiko metodoek Sproat et al testuaren normalizazio-prozesuren bat egitea iradokitzen dute ( 2001 ) lematizazioa bezala, flexibo-eransketak kentzeko, antzeko hitzen ohiko irudikapena emateko eta hiztegiaren tamaina gutxitzeko. Aitzitik, testu-normalizazioko urrats hau ezabatzea proposatzen dugu, hizkuntza espezifikoetan generoari buruzko informazio gehigarria duten atzizki malguak bere lekuan mantenduz.
3. Ondoren, dokumentuak prestatzeko prozesu estandarrari heldu genion, dokumentu bakoitzaren irudikapen bektorizatu bat sortuz eta termino-dokumentu matrize bat eraikiz (berriro, xehetasun gehiago ematen dira Atalean) 5.3 ).
Estrategia hau, generoa identifikatzeko ikaskuntza automatikoko algoritmo bat entrenatuko duten testu-datuen prestaketari aplikatzen zaio. Prozedura honen aplikazioa ingurune erreal batean frogatzeko, baliozkotze esperimentu batzuk diseinatu ditugu, hurrengo atalean deskribatutakoak.
5.3.2 Esperimentuen konfigurazioa
Helburu nagusia, mundu errealeko testu-dokumentuekin lotutako generoa automatikoki identifikatzeko proposatutako gure lan-esparruaren gaitasuna ebaluatzea da. Horretarako, ingeles eta espainiar bertsioen literatur egileak deskribatzen dituzten artikulu biografikoak berreskuratu ditugu. DATASET-TH-001, zeinen datuak ezagutza semantikoan oinarritutako beste sistema batzuk elikatzen dituzten, hala nola DATASET-TH-001. Beraz, bi datu-multzo desberdin sortu ziren, hizkuntza bakoitzerako bat. Gure datu-multzoaren eraikuntza diseinatu dugu, gure ingeles eta espainiar esperimentuetarako aukeratutako bi etiketen irudikapen berdin-berdina ziurtatzeko.
Gure prozedura ingelesez eta gaztelaniaz testuan inplementatzean, gure helburua deribazioa ekidinez gero eragin positiboa duen egiaztatzea da. Aukeratutako datu-multzoa egile maskulinoen eta emakumezkoen biografiak izan ziren. Aukera honek esperimentua sailkapen binarioko arazo gisa markoztatzeko aukera ematen digu, eta horretarako zenbait ikasketa automatiko estandarreko algoritmo daude. Irudia 5.2 ikaskuntza-metodo gainbegiratu bakoitza ebaluatzeko prozedura esperimentalaren deskribapen orokorra erakusten du.
Ingelesez eta gaztelerazko biografia-datuen multzo bakoitza entrenamendu eta proba azpimultzoetan banatzen da. Zehazki, 70 % Hizkuntza bakoitzeko biografiak entrenamendurako erabiltzen dira, baina hizkuntza 30 % Gainerakoak proba-multzo gisa gordetzen dira, gainbegiratutako ikaskuntza algoritmoen errendimendua ebaluatzeko. Ondorengo atalak bi datu-multzoak berreskuratzeari eta prestatzeari buruzko xehetasun gehigarriak ematen ditu.
5.3.3 Erabilitako datu- multzoak
Hasi ginen, idazleen biografiak berreskuratuz. DATASET-TH-001, zure webgunea zuzenean arakatuz paketea erabiliz DATASET-TH-001 Keyes eta Til-
Irudia 5.2: Proposatutako markoaren deskribapena, gainbegiratutako ikaskuntzako metodo alternatiboak probatzeko.
SOFTWARE-TH-003 ( 2017 R estatistika-ingurunerako eskuragarria, ORG-TH-112 ( 2022 ). Pakete honek orrialde zerrenda bat, azpikategorien zerrenda bat, orrien edukina eta kategoria zehatz bati buruzko beste informazio bat eskura ditzake.
Gomez et al. ingelesez jendaurrean eskuragarri dagoen datu multzoa ( 2021 a), 4, hau du 1000 hemendik ateratako idazleen biografiak DATASET-TH-001 ingelesez. Artikulu hauek emakume multzo batean eta gizon multzo batean banatzen dira zuzen-zuzenean. Emakumeen biografiak XIX. mendekoak diren bitartean, emakumeen kategoriatik atera dira. 500 XIX. mendeko gizon_gizon kategoriako orriak gizonen biografiak egiteko lortu dira.
Gomez et al. gaztelaniaz jendaurrean eskuragarri dagoen datu multzoa ( 2021 b),
5, hau du 832 hemendik ateratako biografiak DATASET-TH-001 espainieraz. Emakumeon biografiak Espainiako Idazle kategoriatik atera dira. Aitzitik, lehenak 416 XX. mendeko Espainiaren idazleak kategoriako orrialdeak (1700) berreskuratu dira gizakien biografiak egiteko. Beraz, biografia hauek ere bi azpimultzotan banatzen dira, bata emakumezkoa eta bestea gizonezkoa.
Taula 5.1 aurretik deskribatutako ingelesez eta gaztelerazko datu-multzoen aurretiazko azterketa baten zenbait estatistika orokor laburbiltzen ditu.
Lehenik eta behin, biografia bakoitza m Feiner et al testu meatzaritzako R paketea erabiliz prozesatzen dugu ( 2008 ). Biografiatik hitz hutsak kentzen (normalean analisirako balio ez duten hitz arruntak) Eisens...
4 [LINK-REDACTED] 5 [LINK-REDACTED]
Taula 5.1: Datu-multzoak ingelesez eta gaztelaniaz deskribatzen dituen kopuru osoa eta batez bestekoa.
Dataset Desscriptive statistics Value
Guztira number of biographies of female authors 500 Avg. number of distinct terms per female writer biography 50,86
Avg. number of distinct terms per female writer biography (stemming) 38,11
English
Guztira number of biographies of male authors 500 Avg. number of distinct terms per biography of male writer 46,2
Avg. number of distinct terms per male writer biography (stemming) 35,62
Guztira number of biographies of female authors 416 Avg. number of distinct terms per female writer biography 50,03
Avg. number of distinct terms per female writer biography (stemming) 31,44
Stanish
Guztira number of biographies of male authors 416 Avg. number of distinct terms per male writer biography 51,39
Avg. number of distinct terms per male writer biography (stemming) 32,68
tein ( 2019 ), zenbakiak, puntuazio zeinuak eta zuriuneak. Geroago, biografia bakoitzaren testua minuskula bihurtzen da eta dagokion termino-biografia matrizea sortzen da, taulan aurkezten den bezala. 5.2. Horrela, multzo biografiko bakoitza mx n matrize bat bezala adieraz daiteke, m hiztegian hitz bakarren kopurua delarik eta n entrenamendu-multzoko biografia-kopurua delarik. Matrize termino-biografiaren wij elementu bakoitzak i hitzaren garrantzia edo pisua adierazten du j biografian. wi j- ren balioa lortzeko, Aizawa TF-IDF neurria erabiltzen dugu ( 2003 ), honela kalkulatua ( 5.5 ):
!, ( 5.5 )
wij = t fi j x log n
d fi
non t fi j-k i hitzaren gertaera-kopurua adierazten duen j biografian; n entrenamendu-multzoaren biografia-kopurua da; eta, azkenik, d- fi hitzak dituen biografia-kopurua da.
Esan beharra dago entrenamenduen biografiak bakarrik laguntzen dutela biografia guztiak adierazten dituen terminoen hiztegia eraikitzen. Hau da, sailkatzaileak proba-azpimultzoari buruzko biografia berriak egiaztatzen dituenean, hau da--
Taula 5.2: Matrizearen adibidea termino-biografia, non wi j hitzak i hitzaren garrantzia adierazten duen sarrera biografikoan.
Dictionary Biography 1 Biography 2... Biography n
W11 w12 University... w1n Marriage w21 w22... w2n Novel w31 w32... w3n... Writer wm1 wm2... wmn
edozein termino ez da aurkitu entrenamendu-multzoaren biografiatan distantzia kalkulatzeko. Era berean, gure ikerketan ez dira termino jakin baterako sinonimo, laburdura edo ordezko formatzat hartu.
5.3.4 Emaitzak
Atal honetan, testuetan generoa identifikatzeko hainbat estrategia konparatzen dituzten esperimentuen emaitzak aurkezten dira. Sailkapen algoritmo bakoitzerako egindako esperimentuek ausazko entrenamenduko saioen hamar saiakuntza eskatzen dituzte. Emaitzak babestu ahal izateko Wilcoxon Hollander et al-en hipotesi estatistikoen testak egin dira ( 2013 ) p-tik beherako balioetarako estatistika-esentzia kontuan hartuta 0, 05.
GSVM versus estandarra SVM
Ondorengo atalak GSVM eta SVMren arteko ebaluazio esperimentuen emaitzak laburbiltzen ditu testuaren genero identifikazioaren arazoan.
Iterazioen kopuruaren konparaketa: GSVM versus SVM estandarra
Taula 5.3 GSVMrako iterazioen zenbaketa eta SVM tipiko bat konparatzen ditu geraleku klasikoaren irizpidea erabiliz. Argi dago, batez beste, GSVM-k, gaztelerazko datu multzorako gutxi gorabehera konbergeatzen duela 18 % (deribatuekin) y 25 % (deribaturik gabe) SVM ikuspegi estandarra baino iterazio gutxiago. Era berean, ingelesez eskuragarri dauden datu guztietarako GSVM-k gutxi gorabehera iterazioen kopurua murrizteko aukera ematen du 42 % (deribatuekin) y 44 % (deribaturik gabe). GSVMren desbiderapen estandarraren balio nagusiak bi ikuspegiek esperimentu batzuetarako iterazioen gehienezko kopuru zehatza lortzearen ondorio dira, SVM ikuspegi estandarraren iterazio kopurua bezala ulertuta.
Wilcoxonen testak ingelesez eskuragarri dauden datuei buruz erakusten du SVMren GSVMren hobekuntza estatistikoki esanguratsua dela, bai aplikatzen denean.
ca stemming balioa ( p = 0,00195 ) aplikatzen ez denean bezala ( p = balioa 0,00589 ). Gaztelaniazko biografiak kasuari erreparatzen badiogu, hobekuntza estatistikoki esanguratsua da stemminga (p = balioa) ez denean. 0,00195 ) baina ez da adierazgarria steming ( p = balioa) erabiltzen denean 0,1 ).
Taula 5.3: Batezbestekoa (prom.) eta desbiderapen estandarra (d.e.) iterazioen zenbaketa entrenamendu aldietan.
Language Method Stemming No stemming
avg. s.d. p- gorri-balioan
Spanish SVM 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
English SVM 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
Irudiak 5.3 a, 5.3 b, 5.4 a y 5.4 b-ek grafikoki erakusten dute, esperimentu bakoitzerako, zein GSVM eta SVM iterazioen zenbaketan geratzen diren entrenamendua gauzatzea, hurrenez hurren. GSVMren atxiloketa-irizpideak errore-tasaren adierazlea egonkortzen den unea (puntu-lerroa) beti antzematen du. Aitzitik, SVMren atxiloketa-irizpide klasikoak iterazio-kopuru handiagoa eskatzen du, errore-tasa batere hobetu gabe gelditzeko.
Nabarmendu behar da ingelesezko biografiak egiteko GSVMren geraleku-irizpidea antzekoa dela, goiburutze-aurreprozesamendua aplikatzen den ala ez kontuan hartu gabe (ikus Irudiak). 5.3 b y 5.4 b). Beste aurkikuntza aipagarri bat da Espainian biografiak egiteko errore-tasa (ikus Irudiak) 5.3 a y 5.4 a) eredu oszilakor bat erakusten du deribazio aurre-prozesamendua aplikatzen denean (Figura 5.4 a). Portaera hori hizkuntza honetan deribazio-eragiketak sartutako informazio-galeraren ondorio izan daiteke.
Azkenik, esan behar da ebaluazio-mekromek oso antzekoak direla, kasu guztietan, femeninoko irteera-etiketen kasuan, eta RAFeninoCO eta milmasculino Hernández bi hizkuntzetan.
GSVM vs-en zehaztasunaren konparaketa. SVM estandarra
GSVMren teknika estandarraren errendimentazioa ebaluatzeko asmoz, F1 Baeza- Yates eta Ribeiro-Neto puntu metrikoak ikusi ahal izango ditugu ( 2011 ); Sokolova eta Lapalme ( 2009 ); Olson eta Denen ( 2008 ). Taula 5.4 SVM eta GSVMren arteko konparazioa erakusten du ingelesezko biografiak egiteko, deribaziorik gabe. Metodo eta metrika bakoitzerako, taula honek batez bestekoa (adib.) eta desbiderapen estandarra (s.d.) erakusten ditu. Gainera, Wilcoxon-en testaren p balioa erakusten da konparazio bakoitzeko. Wilcoxon-en testaren emaitzek adierazten dutenez, ez dago estatistika aldetik ezberdintasun esanguratsurik aintzat hartzen diren metriketako batean ere, p balioaren zutabean adierazten den bezala, non balio guztiak baina handiagoak diren 0,05.
(a) Spanish language
(b) English Language
Irudia 5.3: Deribaziorik gabe. Atxiloketa-irizpideen konparaketa, deribatze-aurrezpena erabiltzen ez bada.
Tauletan azaldutako emaitzak 5.4 y 5.5 modu enpirikoan erakusten dute testu generoa identifikatzeko arazoetarako GSVMren teknikek SVMren ezaugarri berberak dituztela, antzeko zehaztasun-emaitzak emanez.
Taula 5.5 SVM eta GSVM-ren arteko konparazioa erakusten du, gaztelerazko biografiak egiteko, deribaziorik gabe. Berriro ere, metodo eta metrika bakoitzerako, taula honek batezbestekoa (adib.), desbiderapen estandarra (s.d.) eta Wilcoxon-en probaren balio plak erakusten ditu. Ingelesezko biografiak bezala, Wilcoxon-en probaren emaitzek adierazten dute ez dagoela estatistika aldetik ezberdintasun esanguratsurik metriketako batean ere (balio p-ak baino handiagoak dira 0.05 ). Ados nago...
(a) Spanish language
(b) English Language
Irudia 5.4: Atxiloketa-irizpideen konparazioa, deribatze-aurrezpena aplikatzen denean.
Taula 5.4: Ingelesa. SVMren eta GSVMren errendimenduko metrikak, ingelesezko sailkapeneko biografiak egiteko, deribaziorik gabe.
Stem. Gender Method Precision Recall F1 score
avg. (s.d.) p-Veg. (s.d.) p-balioan.
Ez Female SVM 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
Male SVM 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Yes Female SVM 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
Male SVM 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
cia, GSVMk lortutako iterazioen kopurua erortzeak ez du eraginik
sailkapena.
Taula 5.5: Gaztelera. SVM eta GSVMren errendimenduko metrikak, sailkapenezko biografiak egiteko gaztelaniaz, deribaziorik gabe.
Stem. Gender Method Precision Recall F1 score
avg. (s.d.) p-Veg. (s.d.) p-balioan.
Ez Female SVM 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
Male SVM 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Yes Female SVM 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Male SVM 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Taula 5.6 GSVM- rentzat deribazioaren eta deribazioaren arteko konparazio bat erakusten du, dagozkion p baloreekin batera. Gaztelaniazko biografiak egiteko, emaitzek degradazio esanguratsua erakusten dute deribazioa sartzen denean, p balioekin 0, 0097, 0, 00586 y 0, 00195, zehaztasunerako, F1 kalifikazioa eta puntuazioa, hurrenez hurren, emakumezkoen generoan; eta p balioak 0, 0137, 0, 00195 y 0, 00195, zehaztasunerako, F1 kalifikazioa eta puntuazioa, hurrenez hurren, gizonezkoen generoan. Aldiz, ingelesezko biografiak egiteko, metrika guztietarako p balioak garrantzi maila gainditzen dute 0,05, efektu esanguratsurik eza adierazten duena.
Taula 5.6: Deribazio versus-en errendimendu metrikoaren konparaketa, GSVM metodoa aplikatzen denean deribazioa ez denean.
Language Gender StemPrecision Recall F1 score
avg. gorri-balioan p-avg.
Stanish Female No 0,909 0,0097 0,907 0,00586 0,903 0,00195 Yes 0,770 0,781 0,747
Male No 0,889 0,0137 0,913 0,00195 0,891 0,00195 Yes 0,724 0,790 0,713
English Female No 0,908 0,343 0,859 0,124 0,879 1 Yes 0,880 0,898 0,888
Male No 0,823 0,108 0,909 0,286 0,843 0,636 Yes 0,899 0,884 0,891
GSVM vs. Beste algoritmo batzuk
Subsekzio honetan GSVM metodoaren entrenamenduko errendimendua eta denbora eta beste ikasketa-metodo automatiko batzuekin alderatzen dira, hala nola, Random Forests (RF) Breiman ( 2001 ) eta Boosting Schapire ( 1990 ), erabilera komuneko software-dendetatik ateratakoak. Proba hauetan, algoritmoen hiperparametroak bere balio lehenetsietan finkatzen dira. algoritmo eta hizkuntza bakoitzerako, metrika bakoitzerako testu alternatiboko meatzaritzako bi lan-fluxu alderatzen ditugu: i) deribazio-pasagune bat dute, ohiko testuetako meatzaritza-aplikazio gehienetan bezala; eta ii) deribazioa saihesten dute, zenbait hizkuntzatan genero gehigarriari buruzko informazioa ematen duten lasterbideak mantenduz. Denbora metrika bezala erabiltzen dugu.
konparaziozkoa, ez baitago iterazioen zenbaketak bidezkoki konparatzerik, metodo bakoitzaren inplementazioak iterazio-ikuspegi ezberdin bat jarraitzen baitu.
Trebakuntzaren denboraren konparaketa: GSVM versus beste algoritmoak
Taula 5.7 ikerketa honetan erabilitako algoritmoen bertsio guztietarako exekuzio denbora (segundotan) laburbiltzen du. Espainiako hizkuntzarako deribazioa erabiliz, GSVM batez beste, are gehiago 10,05 Boosting metodoa eta 42,87 RF baino azkarragoa da, eta ingelesarentzat, berriz, GSVM batez beste 15,79 Boosting eta 59,15 RF baino azkarrago. Deribazioa aplikatzen ez denean, gaztelaniarako, GSVM batez bestekoa da. 49,63 Boosting eta 81,00 RF baino azkarrago. Ingelesari dagokionez, GSVM batez besteraino iristen da 22,91 Boosting eta 77,70 RF baino azkarrago. Laburbilduz, Wilcoxon-en proban oinarrituta, p balio zutabean metodoen arteko alde estatistikoki adierazgarria adierazten da, eta horrek erakusten du GSVM-ren entrenamendu denbora beste metodoetan baino askoz ere txikiagoa dela.
Taula 5.7: Batez bestekoa (adib.) eta entrenamendu denboraren desbiderapen estandarra (s.d.).
Language Method Stemming No stemming
avg. (s.d.) p-balioan (s.d.)
Stanish GSVM 3,096 ( 0,460 ) 2,889 ( 0,150 ) Boosting 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
English GSVM 3,799 ( 0,074 ) 3,883 ( 0,525 ) Boosting 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
Zehaztasunaren konparaketa: GSVM versus beste algoritmo batzuk
Deribazioa ez denez esanguratsua ingelesezko biografiak prozesatzean, espazio arrazoiengatik, gure gainerako azterketa guztia gaztelerazko biografian oinarrituko dugu. Taula 5.8 deribazio versus ez deribaziozko konparazio bat erakusten du, eta dagozkion p balioak GSVM, Boosting eta Random Forest-entzat. GSVM-k oso emaitza itxaropentsuak lortzen ditu, batez ere deribaziorik erabiltzen ez denean, zehaztasunarekin, kualelarekin eta F1 puntuazioaren gainetik 90 % Kasu gehienetan, Boostingek eta Random Forestek GSVMren emaitzak hobetzen dituzten arren. Egina, bi teknikak multzo-metodo gisa ezagutzen direnak direla egiaztatzen duena (Sagi eta Rokach, 2018 ). Modelo ugari entrenatu eta bere iragarpenak integratuz, metodo horiek eredu bakar baten aurre-errendimendua hobetzen dute. Nabarmendu behar da, GSVMk zehaztasunaren arabera SVM estandarra bezala jokatzen duenez gero, emaitza hauek deribazioaren garrantzia erakusten dutela gaztelania bezalako hizkuntzetan deribazio ezaren aurrean. Aurre-prozesamendu teknika hau ere
beste sailkapen-mota batzuk erabiliz lortuko liratekeen emaitzei eragiten die.
Gainera, taularen p balioak 5.8 deribazioa aplikatzen denean, algoritmo guztien errendimenduan degradazio esanguratsua erakusten dute. Emaitza horiek erakusten dutenez, Espainiako hizkuntzarako, deribaziorik gabe, zehaztasuna, berreskuratzea eta F1 puntuazioa baino handiagoak dira. 90 % kasu gehienetan, deribazioa erabiltzean, ordea, endekatze-errenbiloa gertatzen da. 15 %.
Taula 5.8: Zehaztasunezko metrikak, gaztelerazko biografiak egiteko metodoetarako.
Method Gender StemPrecision Recall F1 score
avg. (s.d.) p-Veg. (s.d.) p-balioan.
GSVM Female No 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 Yes 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Male No 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 Yes 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Boosting Female No 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 Yes 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
Male No 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 Yes 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF Female No 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 Yes 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
Male No 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 Yes 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 Ondorioak
Atal honetan, generoaren identifikazio errendimenduan antzemandako ezberdintasunen inguruko azalpenak hartzen ditugu kontuan, eta horiek gure lanean izan daitezkeen mugapenei buruz gogoeta egiten dute.
5.4.1 Sailkapen algoritmoen konparaketa
Emaitzek iradokitzen dute Stemming-en aplikazioaren kontrola testu-datuen prestaketan oso antzekoak direla, sailkapenerako aukeratutako ikasketa automatikoko algoritmoa alde batera utzita. Hala ere, hizkuntza erabiliaren arabera desberdintasunak daude.
Ondorioz, ondorioztatu dezakegu generoa identifikatzeko ikasketa automatikoko sailkapen algoritmoak algoritmoak entrenatzeko erabiltzen diren datu-multzoetan agertzen diren atzizkiek zuzenean eragin ditzaketela. Gure emaitzek baieztatu dutenez, Stemming-en aldez aurreko prozesamenduak, itxuraz sailkapen arazoa errazten duen metodo batek, arazoari irtenbidea emateko genero-nahasketa eragin dezake.
5.4.2 Stemmining ezabaketaren eragina
Proposatutako markoaren helburu nagusietako bat da aztertzea ea zenbait hizkuntzatan genero informazioa duten elementu morfologikoen atxikipenak, hala nola espainierak, goragoko sailkapen-errendimendua eman dezaketen testuan generoa identifikatzeko. Tauletan aurkeztutako emaitzen arabera 5.6 y 5.8, nahiko gorakada nabarmena dago espainiar sailkapeneko errendimenduan gure esperimentuetan kontsideraturiko algoritmoetarako, deribazio-pasabidea datuak prestatzeko prozesutik kanpo geratzen denean.
Aitzitik, ingelesezko hizkuntzarako emaitzek gutxieneko aldaketa adierazten dute F1 puntaje-metrikoan Stemming aplikazioaren artean, edo ez sailkapen-modalitate guztietarako datuak prestatzeko prozesuan. Hizkuntza honek antzeko emaitzak ditu, telekalaren zehaztasun eta errendimendu-meriken aurrean.
Emaitza horiek, oro har, hasierako kontsiderazioaren babesa ematen digute, Stemming-en aplikazioa ez aplikatzeak eragin positiboa izan dezakeelako testuetan genero identifikazioari dagokionez, edukia hizkuntza morfologiko gehigarrietan eskuragarri dagoenean, genero informazioa ekartzen duten xehetasun morfologiko gehigarrietan, hala nola espainieran. Datuen prestaketa-fasearen garrantziaz aurretiaz egindako ikerketetan lortutako ezagutza baieztatuz, batez ere Uysal eta Gunal ingelesaren hizkuntza desberdinekin lan egiten bada ( 2014 ).
5.4.3 Mugak
GSVM metodo berriak, entrenamendu faserako goiz atxilotzeko irizpidea sartzen duenak, ondo funtzionatzen du testu generoaren identifikazioko arazo zehatzerako. Beraz, esperimentu gehigarriak egin behar dira GSVMren errendimendua beste sailkapen-lan batzuetan ebaluatzeko GSVM gomendatu aurretik, ikaskuntza automatikoan SVMren berrikuntza metodologiko orokor gisa.
Testu-generoa identifikatzeko proposatutako esparruari dagokionez, gure ingurune esperimentalaren muga garrantzitsu bat da genero objektiboaren aldagaia bitarra aukeratzera mugatzen dugula. Beste autore batzuek planteatutako arazoa, Hamidi et al. ( 2018 ); Keyes 2018 ). Izan ere, aurkitu duzu? 55 de 58 ikasketa automatikodun genero identifikazio automatikoa egiteko azterketak genero binarioaren irteera bat hartu zuten. Ildo horretatik, etorkizuneko ikerketarako bide posible bat izan liteke gure sailkapen binarioko algoritmoak ordezkatzea, etengabeko helburuak edota multibarianteak onartzen dituzten ikaskuntza automatikoko ereduak izan daitezkeen alternatiba batekin. Testuinguru horietan, interesgarria litzateke aztertzea genero atzizkiek oraindik generoa identifikatzeko abantaila batzuk ematen ote dituzten.
Gure ikuspuntuaren beste muga bat da sarrerako testua ez dagoela eskuragarri ingelesetik ezberdina den hizkuntza batean. Hala ere, orduan, testua automatikoki itzuli ahal izango da ingelesetik gaztelaniara edo antzeko ezaugarriak dituzten beste hizkuntza batzuetara Zerbitzu automatizatuen bidez. Sarrerako testutik itzulitako bertsio honek genero gehigarriko informazioa eman dezake, sailkapeneko errendimendua optimizatzeko. Era berean, ikerketa gehiago egin behar da hasierako emaitza horiek ingelesez eta gaztelaniaz alderatzen dituztela ziurtatzeko, hizkuntza alternatiboetan datuak sartzearekin batera erreplikagarriak direla egiaztatzeko.
5.4.4 Berrikuntza
Ikerketa honetan, atxilotze-irizpide berri bat aurkezten dugu testu-edukiaren bektore-ordezkaritzaren propietate geometrikoetan oinarritutako euskarri-bektoreen optimizazio- algoritmoetarako, genero automatizatuaren identifikazioaren arazoa ebazteko helburuarekin. Arazo honi dagokionez, proposatutako algoritmoak entrenamendurako denbora gutxiago behar duela erakusten dugu, SVM algoritmo estandarrak aplikatzearekin konparatuz gero. Esparruari dagokionez, testu meatzaritzako ohiko normalkuntza-prozedurak jarraitu beharrean, genero-afirioak, deribazioa esaterako, kentzen dituztenak, hizkuntza sendoetan aurkituriko elementu morfologiko horiek gordetzen ditugu, generoaren identifikazio-metodoen errendimendua optimizatzeko. Ikuspegi berri honen eraginkortasuna aztertzen dugu gaikuntza-denborari dagokionez, sailkapenerako ikasketa automatikoko algoritmo ezberdinak konparatuz, eta sarrera biografikoak erabiliz. DATASET-TH-001 ingelesez eta gaztelaniaz.
Gure emaitzek iradokitzen dutenez, ez da deribazioa (stemming) baztertu behar hizkuntzarako testuaren aldez aurreko prozesuan, genero-informazioa duten elementu gehigarriak barne hartzen dituztenetan, hala nola espainieran, positiboa da. Prozeduraren aldaketa horrek ez du eraginik ingelesa bezalako hizkuntza neutraletan.