A disponibilidade de grandes e ricos conjuntos de dados textuais, criados principalmente a partir de conteúdo web têm sido um fator importante na mineração de dados com algoritmos ou métodos de autoaprendizagem a preços sem precedentes. Isso tem gerado um grande interesse na pesquisa de aprendizagem automática para análise de texto Aggarwal ( 2018 ). Hoje, mineração de texto Srivastava e Sahami ( 2009 ) e o processamento da linguagem natural (PLN) Eisenstein 2019 ) constituem a base para muitos destes estudos e implementações.
5.1 Introdução
DATASET-TH-001 Vrandeňci ́ c e Krötzsch ( 2014 ) é um exemplo de uma fonte de dados estruturada e de acesso livre que se baseia em informações extraídas de DATASET-TH-001 em várias línguas. As informações obtidas dos artigos de DATASET-TH-001 vêm passando por um processo de notação semântica para ampliar a base de conhecimento de DATASET-TH-001 seguindo um modelo gráfico estruturado de dados para integrar novas aplicações.
Uma dessas áreas é a identificação de gênero no texto. O objetivo é atribuir um rótulo de gênero (por exemplo, "feminino e masculino) em uma área de texto usando propriedades linguísticas ou outras características descritivas. Em geral, pesquisas anteriores têm se concentrado na identificação do gênero e perfil de uma pessoa que escreve seu texto. Alguns exemplos incluem a identificação de gênero de autores de blogs Yan e Y ( 2006 ) e microblogging
Mukherjee e Bala ( 2017 ) ou para usuários de sistemas de gestão de relações com clientes (CRM) Amado et al. 2018 ).
A criação de novos insumos a partir de DATASET-TH-001 e dados estruturados nos artigos de DATASET-TH-001 para completar cada tópico. Por exemplo, se quisermos voltar dados estruturados sobre "Gabriel García Márquez e foram DATASET-TH-001 a entrada correspondente 2. Então podemos explorar vários campos com características descritivas sobre essa pessoa, incluindo "sexo ou gênero". 3. Neste exemplo, o valor dessa propriedade é "macho". No momento de escrever este artigo, como informações precisas podem ser 6 referência a diferentes artigos de DATASET-TH-001 que apoiam a desconcentração de "male.a
este campo utiliza dados estruturados. No entanto, como um projeto aberto para a criação colaborativa de conhecimento DATASET-TH-001 muitas vezes sofreram vandalismo e ataques com Adler et al. ( 2011 ); Geiger e Ribes ( 2010 ). Se os agentes maliciosos alteraram os dados estruturados originais de DATASET-TH-001, detectar erros sem uma inspeção manual seria uma tarefa complexa e, mais ainda, dado o grande tamanho de seu banco de dados DATASET-TH-001. Além disso, se não houver informação estruturada sobre gênero em um artigo de DATASET-TH-001, seria impossível atribuir um valor directamente à "propriedade do género ou do sexo para a sua entrada em DATASET-TH-001 Essas informações devem ser apresentadas à Comissão na sua primeira reunião. Em vez disso, rotular as informações de gênero como uma análise automática de dados textuais que foram desestruturados no corpo a partir de DATASET-TH-001 Poderia melhorar a resiliência a estes desafios. Esse exemplo pode ser facilmente extrapolado para qualquer outro sistema de informações que deve rotular automaticamente o conteúdo de algum bloco de texto com uma tag de gênero.
Focamos em um caso específico, o problema de determinar automaticamente seu gênero, conforme descrito no texto biográfico. Para o resto deste trabalho, discutiremos esse problema como uma identificação de gênero. A falta de estudos que incluam outros idiomas além do inglês dificulta o desenvolvimento de novos procedimentos de mineração de texto com uma visão melhor Para lidar com este problema. Em vez de nos concentrarmos exclusivamente no inglês, com menos elementos de género temos procurado utilizar o texto espanhol para capturar morfemas que carregam informações sobre o género e são mais comuns nesta língua. Para isso, evitaremos etapas regulares de normalização na mineração de textos tradicionais, como derivados e a lematização de Eisenstein ( 2019 ), pois excluim a informação de gênero em termos linguísticos. Seguindo essa abordagem, mostramos que um valor de gênero pode ser atribuído ao conteúdo textual com mais precisão.
Ao processar texto usando tecnologias de aprendizagem automática, geralmente é útil.
2 [LINK-REDACTED] 3 [LINK-REDACTED]
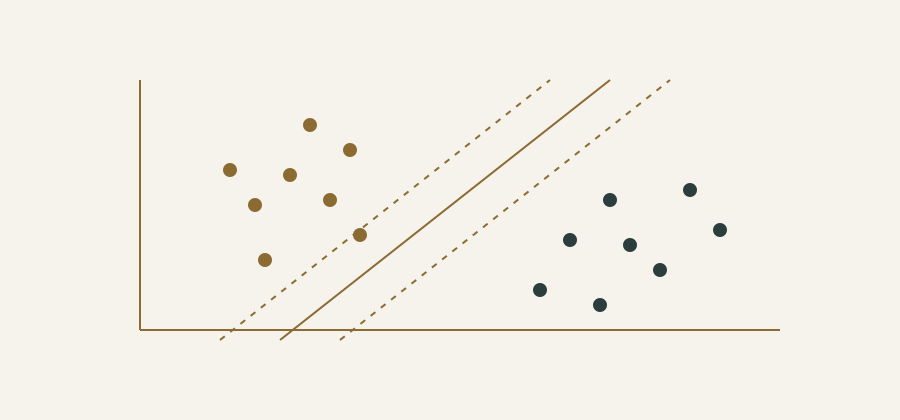
Realizar performances vetoriais com alta dimensional e dispersão, pois contêm numerosos componentes de valor zero. Em um ambiente de dispersão de representações de alta dimensão, MOguerza et al. (SVM) 2006 ) são Jocachims computativamente adequados ( 2002 ). No entanto, a adaptação das tecnologias tradicionais de resolução de problemas de otimização para SVM Joachims ( 1999 ) aplicado à identificação de gênero não garante uma convergência rápida, uma vez que a iteração se aproxima de uma solução ideal do seu problema de otimização subjacente.
5.2 Proposta
Nesta seção, como parte do framework SVM usamos propriedades geométricas de uma tarefa de identificação de gênero de texto para modificar o critério de parada de um algoritmo de otimização subjacente substituindo Karush- Kuhn-Tucker Feng e Li ( 2018 ) por uma nova proposta, que incorpora informações (a taxa de erro] que não está diretamente relacionada matematicamente com um critério que o algoritmo clássico de otimização SVM tenta cumprir, pois pode potencialmente adaptar sua natureza e resolver problemas geométricos. Para avaliar o desempenho desta nova abordagem, estas propostas são comparadas com outros métodos de monitorização Wittan e al ( 2017 ) para identificação automatizada de gênero dentro de textos biográficos de autores literários extraídos de DATASET-TH-001. Será avaliado se deve evitar-se a passagem comum de lematização na mineração de texto, que remove sufixos de gênero com palavras que são importantes para análise de texto e melhora o desempenho na identificação de gênero. A eficácia da abordagem GSVM para acelerar a fase de treinamento de um algoritmo também é mostrada e mostra que esse método não afeta significativamente o desempenho do procedimento.
5.2.1 Critério de paragem geométrica
A geometria da função de decisão SVM ligada a dados de treinamento é quantificável dentro de cada iteração, medindo ou estimando a taxa de erro. Ou seja, quando esta taxa de erro estabiliza a função de tomada de decisão cumpre esses critérios para classificação efetiva dos dados. A figura 5.1 mostra um exemplo com duas nuvens gaussianas multidimensionais. A execução de um SVM até à iteração 2 produção da superfície de separação representada na figura 5.1 um tempo Figura 5.1 b mostra a área de separação calculada até a iteração 18. Função de decisão da figura 5.1 a fornece o mesmo erro empírico que a função de decisão da figura 5.1 b, que exigiu mais iterações e
Assim, mais tempo de treinamento para sua construção. Em vez disso, a construção da função de tomada de decisão na figura 5.1 a Ele precisava de menos iterações de treino.
a) SVM executado até iteração 2 b) Correr SVM até à iteração 18
Figura 5.1 Duas superfícies de separação com SVM: (a) superfície de depuração obtida após 2 b) Área de separação calculada após 18 iterações.
Com base nestas bases, definimos εk como a taxa de erro para o treinamento definida na iteração K e □ > 0 como um verdadeiro valor que age com tolerância. De acordo com ( 2.3 ),
N X
εk = 1
g
i = 1 ( 1 − yi f (xi) e 5.1 )
Mar δk = 124; εks - httg ~ 5 |. O método deve ser interrompido após o cumprimento dos seguintes requisitos:
(δk ≤ □) 5 {pos ()} 15 {pos (g)} 100 ε), ( 5.2 )
onde o símbolo ") 'denota um operador lógico e, isto é, com todas as quatro desigualdades dentro de seu critério deve ser atendido simultaneamente. Medindo a diferença δk ≤ □ a cada cinco iterações e relaxando um critério clássico, podemos evitar picos indesejados de erro causados pela aleatoriedade. O seguinte teorema mostra que existe uma ligação directa entre os critérios de detenção ( 2.12 ) e 5.2 ).
Teorema 2. Dada □ > 0 e □ > 0 ), há uma série de iterações kŽ e β tais como δk ≤ ع y m (βg.
Prova. A Corolarus 1.1, argumenta-se que:
L ′′ ım k →
m (βk) − M [β ks] = 0
Assim, há uma série de iterações que k > K ° são cumpridas:
m (β k) - M e g.
Seja a solução do problema do vector β ( 2.5 ), em que β 0 são chamados vetores de suporte. É bem conhecido que a função f, que determina a superfície de decisão g {(x) = 0 Tomar a forma:
N X
f □ (x) =
i = 1 β □ i yiK (xi, x) + b 5.3 )
com
b □ = − pn i) 1 β □ iK (xi, x +)
2 + pn i = 1 β □ iK (xi, x -)
2,
onde x + e x- são dois vetores de suporte em classes mais 1 e 1 como o seu multiplicador de β + e ′′ − Ligrange associado foram 0 < β + {C} e 0 < β - > C
Consideremos a função de tomada de decisão determinada por este problema ( 2.5 ), na iteração k:
N X
f k (x) =
i = 1 β k i yiK (xi, x) + bg.
É fácil provar isso, ′′ γ > 0, há um número de iteração kloe como.k > qy:
g k (x) − f 5.4 )
Isso é por causa do teorema. 1 Isso significa que:
L ′′ ım k →
e, assim, que 0 há uma série de iteração kv tal que, ou seja, k > q.n. ele se encontrou Que:
β k - α ′′ ≤ / /.
Se tomarmos e quão pequeno, ( 5.4 ) é atingido por kγ = k. Dada □ > 0, se temos e somos suficientemente pequenos para ( 5.4 ), e k > kγ com a definição ( 5.1 ), considera que:
{pos ( 192,240 )} 5 | ≤τ,
e o teorema é válido para kē, β = m ′′ ax {g-q.a.).
□
Desde o critério ( 5.2 ) baseia-se na taxa de erro, é intuitivo definir um valor para. Podemos colocá-lo, por exemplo com a) = 0,0005 como uma taxa de erro até 0,05 % pode ser considerado como significativamente baixo. Essa intuição não existe para o critério ( 2.12 ) porque a magnitude de g (β] não pode ser estimada com antecedência. Secção 5.3 mostramos que, para o caso particular de identificação de gênero em textos, uma área de decisão 5.2 ) em iterações significativamente inferiores às exigidas para satisfazer o critério teórico amplamente utilizado ( 2.12 ). O ponto-chave é o ambiente de alta dimensão em que o texto foi representado, permitindo uma boa generalização empírica a ser alcançada rapidamente. Assim, do ponto de vista empírico espera-se que a GSVM herde as propriedades de generalização para a LVM.
5.3 Experimentos
Nesta seção, descrevemos detalhadamente o problema da identificação de gênero e como são criadas as experiências.
5.3.1 O problema
O problema da identificação de gênero em dados textuais como uma tarefa de monitoramento da classificação de treinamento desafios. Devido a um bloco de texto que pode ser marcado com o rótulo de gênero de um indivíduo, o algoritmo deve inferir automaticamente esta tag. Neste caso, consideramos dois potenciais rótulos de saída: L = {"feminino e masculino) como nosso conjunto de dados experimentais contém apenas instâncias destas Duas Classes de Gênero. 5.3.3. Assim, restringimos nossa escolha de algoritmos àqueles orientados à classificação binária. A mesma abordagem poderia ser estendida para considerar rótulos de saída adicionais, reformulando o problema como uma tarefa de classificar um contra todos ou várias tags.
O nosso quadro de trabalho difere das abordagens anteriores com dois desafios.
3 ).
Embora trabalhos anteriores tenham sido seguidos por procedimentos convencionais de mineração de texto, como derivação, deliberadamente evitamos este passo para preservar o sufixo de gênero em termos e explorar seu impacto na identificação de gênero para textos com uma forte ponta de palavras como o espanhol.
Em vez de marcar uma sequência de entidade com um nome em texto, abordamos o problema sobre atribuir A Gender Label a um bloco de texto ou documento completo descrevendo outra pessoa. Esse é um problema importante para muitas aplicações, incluindo notação automática de entrada em bases de dados semânticas.
Há muitas línguas que têm sido flexionadas, o que significa que as palavras podem mudar sua forma para refletir informações gramaticais como número e tempo ou gênero Hedlund et al. ( 2001 ). Em espanhol, palavras que terminam em.ou em uma consoante denotam gêneros masculinos enquanto aqueles com um "são principalmente femininos. A lemização tenta remover diferenças entre as formas flexionantes de uma palavra e reduzir cada palavra em sua forma raiz. Esse pré-processamento tem sido a abordagem padrão para mineração de texto e recuperação de informações para uma melhor precisão na identificação de termos-chave com uma determinada mensagem.
No entanto, como mencionado anteriormente em espanhol, a hiperspse de muitas palavras pode ser um indicador útil e direto para o gênero. É por isso que parece razoável supor que se não aplicarmos a tematização e preservarmos sufixos de gênero, eles podem melhorar a precisão de sua identificação de gênero. Propõe-se a seguinte estratégia para a identificação de textos de gênero:
1. Implementar procedimentos de mineração de texto padrão para preparar uma entrada não processada, incluindo tokenização e eliminação de palavras vazias (detalhes adicionais de implementação são fornecidos na seção 5.3 ).
2. Antes da criação de representação vetorial para cada documento, métodos convencionais de mineração de texto sugerem que alguns Sproat et al. ( 2001 ), como a lematização para remover desafios de flexão e fornecer uma representação típica de palavras semelhantes, enquanto reduzindo o tamanho do vocabulário. Em vez disso, propomos suprimir esta etapa de normalização do texto e, em vez disso, preservar sufixos flexivos que contenham informações adicionais sobre gênero em línguas específicas.
3. Em seguida, re-selecionamos o processo padrão de produção do documento, gerando uma representação vetorial de cada papel e construindo uma matriz de letra-termo (de novo mais detalhes são dados na seção). 5.3 ).
Essa estratégia aplica-se à produção de dados textuais que irão treinar um algoritmo de autoaprendizagem para identificação de gênero. Para provar a aplicabilidade deste procedimento em um ambiente real, nós projetamos um número para realizar experimentos de validação e estes são descritos como segue.
5.3.2 Configurar as experiências
O objetivo principal é avaliar a capacidade de nosso framework proposto para identificação automática de gênero associada a documentos de texto do mundo real. Para tanto, recuperamos artigos biográficos que descrevem autores literários das versões espanhola e inglesa de DATASET-TH-001 e seus dados alimentam outros sistemas baseados no conhecimento semântico como DATASET-TH-001. Assim, foram criados dois conjuntos de dados diferentes e um para cada idioma. Nós projetamos nosso conjunto de dados para garantir uma representação igual de ambos os rótulos em insumos biográficos escolhidos para suas experiências espanholas.
Ao aplicar nosso procedimento como texto de entrada em espanhol e inglês, pretendemos confirmar se evitar o encaminhamento tem um impacto positivo no desempenho do seu identificador de gênero. Nosso conjunto de dados selecionados foram biografias de autores masculinos e femininos. Essa escolha nos permite enquadrar o experimento como um problema de classificação binária para o qual existem vários algoritmos padrão de autoaprendizagem. A figura 5.2 apresenta uma descrição geral do procedimento experimental para avaliação de cada método de aprendizagem supervisionado.
Cada conjunto de dados de biografias em inglês e espanhol é dividido em subconjuntos de treinamento ou teste. Especificamente, 70 % as biografias em cada língua são utilizadas para o treinamento enquanto 30 % permanece como um conjunto de testes para avaliar o desempenho de algoritmos de aprendizagem monitorados. A secção seguinte fornece pormenores adicionais sobre a recuperação e produção de ambos os conjuntos de dados.
5.3.3 Conjuntos de dados utilizados
Começamos, recuperando biografias de autores literários de DATASET-TH-001 monitorando sua web diretamente usando o pacote DATASET-TH-001 Keyes e Til-
Figura 5.2: Uma descrição do quadro proposto para testar métodos alternativos de monitorização.
SOFTWARE-TH-003 ( 2017 ) disponível para o ambiente estatístico R, ORG-TH-112 ( 2022 ). O pacote pode obter uma lista de páginas, subcategorias e conteúdos da página, bem como outras informações sobre uma categoria individual.
O conjunto de dados público disponível em Gomez e al. ( 2021 a) 4 contém 1000 biografias de escritores extraídos de DATASET-TH-001 em inglês. Estes artigos são igualmente divididos em um grupo de mulheres e uma matriz com os homens. As biografias das mulheres foram extraídas da categoria "escritores mulheres.e seu primeiro 500 páginas da categoria "escritores homens] do 19 O século foi obtido para as biografias do homem.
O conjunto de dados público disponível em espanhol Gomez e al. ( 2021 b)
5 contém 832 biografias de DATASET-TH-001 em espanhol. As biografias das mulheres foram extraídas da categoria "Escritores espanhóis". Pelo contrário, primeiro 416 páginas da categoria "Espanhol Escritores do 20 O século 'foram recuperados para biografias dos homens. Assim, essas biografias são também divididas em dois subconjuntos: um de mulheres e outro de homens.
O quadro 5.1 resume algumas estatísticas gerais a partir de uma análise exploratória preliminar dos conjuntos de dados em inglês e espanhol, conforme descrito acima.
Processamos previamente cada biografia utilizando um pacote R de mineração de texto tm Feinereer et al. ( 2008 ). Para remover das biografias palavras vazias (termos comuns que normalmente não fornecem informações úteis para análise) Eisens-
4 [LINK-REDACTED] 5 [LINK-REDACTED]
Quadro 5.1: Número total e médio descrevendo conjuntos de dados em espanhol ou inglês.
Dataset Descrição estatística Valor
Número total de biografias e genómicas 500 Ag. número de termos distintos por biografia de escrita feminina 50,86
Ag. número de termos distintos por biografia de escrita feminina (staging) 38,11
Inglês
Número total de biografias sobre autores do sexo masculino 500 Ag. número de termos distintos por biografia 46,2
Ag. número de termos distintos por biografia de escrita masculina (estadiamento) 35,62
Número total de biografias e genómicas 416 Ag. número de termos distintos por biografia de escrita feminina 50,03
Ag. número de termos distintos por biografia de escrita feminina (staging) 31,44
Espanhol
Número total de biografias sobre autores do sexo masculino 416 Ag. número de termos distintos por biografia escrita masculina 51,39
Ag. número de termos distintos por biografia de escrita masculina (estadiamento) 32,68
Tein ( 2019 ), número e sinal de pontuação com espaços em branco. O texto de cada biografia será posteriormente convertido em menor e a matriz relativa termo-biografia como mostrado nesta tabela. 5.2. Assim, cada conjunto biográfico pode ser representado como matriz m × n e com número N de biografias no pacote de treinamento. Cada elemento wij da matriz termo-biografia representa um nome importante ou peso para i em g biografia. Para obter o valor de wi j usamos o TF-IDA Aizawa ( 2003 ), calculado em ( 5.5 ):
!, ( 5.5 )
wi = t fi j × log N
d fi
onde t fi j denota o número de ocorrências do termo i na biografia J; g é uma figura total para biografias e, por fim, d F3 indica quantas biografias foram encontradas na época.
Note-se que apenas as biografias de treinamento contribuem para a construção de termos dicionário representando todas as biografias. Ou seja, quando o classificador verifica novas biografias sobre um subconjunto de teste que
Quadro 5.2: Exemplo de uma matriz termobiografia, onde wi j representa a importância e os termos i na entrada biográfica J.
Biografia do Dicionário 1 Biografia 2... Biografia
Universidade W11 w12... aw1n Casamento e M21, F9) Escritor wm1 Wm2...
o termo quier encontrado não nas biografias do conjunto de treinamento é ignorado para cálculo da distância. Além disso, nosso estudo não considerou sinônimos e abreviaturas ou formas alternativas para um determinado termo.
5.3.4 Resultados
Aqui são apresentados os resultados de experimentos que comparam diferentes estratégias de identificação de gênero em textos. Os experimentos para cada algoritmo de classificação envolvem dez ensaios de divisões de testes de treinamento selecionados no azar.Para podermos fazer backup dos resultados, realizamos testes de Wilcoxon Hollander et al. ( 2013 ), tendo considerado a significância estatística para valores de p inferiores a 0, 05.
GSVM versus AVS padrão
As seguintes seções resumem os resultados da avaliação de experimentos que comparam o GSVM com o VMS padrão no problema de identificação de gênero de texto.
Comparação do número de iterações: GSVM versus AVS padrão
O quadro 5.3 Comparação da contagem de Iterações para GSVM e um VMS típico usando o critério clássico stop. É claro que com uma média de cerca de GSVM para o conjunto de dados espanhol 18 % (com derivados) e 25 % (sem derivados) menos iterações do que a abordagem padrão SVM. Ao mesmo tempo, GSVM pode reduzir o seu número de iterações em cerca de 42 % (com derivados) e 44 % (sem derivados). Os grandes valores no desvio padrão para o GSVM são resultado de ambas as abordagens atingirem um elevado número de iterações definido para alguns experimentos, entender quantas iterações foram estabelecidas com este modelo.
O teste de Wilcoxon do conjunto de dados disponível em inglês mostra que a GSVM melhorou em relação à LVMN foi estatisticamente significante, tanto na forma aplicada quanto com alta
ca a derivação (p = valor 0,00195 ) como se não fosse aplicado (p = 0,00589 ). Se olharmos para o caso das biografias espanholas, esta melhoria é estatisticamente significativa se não estiver incluída a derivação (p = valor 0,00195 ) mas não é significativo ao usar derivação (valor p = 0,1 ).
Quadro 5.3: Média (prom.) e desvio padrão da contagem de iteração em estágios de treinamento
Método de linguagem Stemming Sem estadiamento
valor- p vg. s. d. vg. a. valores- p
Espanhol 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
SVM em inglês 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
Os números 5.3 a, 5.3 b, 5.4 a e 5.4 b foram mostrados graficamente para cada experimento em que a contagem de iterações GSVM e AVS padrão param seu desempenho de treinamento, respectivamente. O critério GSVM stop detecta como o indicador de taxa de erro será estabilizado em breve (tipline). Em vez disso, o critério clássico de detenção SVM requer um número aumentado de iterações para parar sem fornecer qualquer taxa de erro melhorada.
Deve-se enfatizar que o desempenho do critério de parada da GSVM para biografias em inglês é semelhante, independentemente de ter ou não sido aplicado o pré-processamento de lematização (ver Figuras). 5.3 b e 5.4 b). Outro achado notável é que a taxa de erro para biografias em espanhol (ver Figuras) 5.3 a e 5.4 a) Expandir um padrão oscilante ao aplicar o pré-processamento de derivação (Figura 5.4 (a) Essa conduta pode ser devida a uma perda significativa de informações introduzidas pela operação de referência nesta língua.
Finalmente, deve-se mencionar que as métricas de avaliação são muito semelhantes em todos os casos para rótulos de produção "feminino" e (masculino) com ambas as línguas.
Comparação de GSVM vs. precisão padrão SVM
Para avaliar o desempenho da técnica padrão de SVM com GOVM, temos monitorado as métricas de precisão, memória e pontuação F1 Baeza-Yates & Ribeiro ( 2011 ); Sokolova e Lapalme ( 2009 ); Olson e Delen ( 2008 ). O quadro 5.4 mostra uma comparação de MVS e MLVS. para biografias em inglês com ou sem derivação. Para cada método e métrica, esta tabela mostra a média (avg.) com desvio padrão [s.d.] Além disso, o valor de p do teste de Wilcoxon para cada comparação é mostrado. Os resultados do teste de Wilcoxon indicam que não há diferenças estatisticamente significantes para nenhuma das métricas consideradas, como e como é indicado em uma coluna de p-valor onde todos os valores foram superiores a 0,05.
a) Espanhol
b) Língua inglesa
Figura 5.3: Sem derivação. Comparação dos critérios de detenção se você não usar pré-processamento de referência.
Os resultados apresentados nas Tabelas 5.4 e 5.5 eles têm sido mostrados empiricamente que, para problemas de identificação de gênero de texto, as técnicas da GSVM herdam as mesmas propriedades das LVMs e fornecem resultados de precisão semelhantes.
O quadro 5.5 mostra uma comparação de SVM e GSSM. para biografias espanholas com ou sem derivação. Novamente, para cada método e métrica esta tabela mostra a média (avg.) com desvio padrão [s.d.] bem como os valores de p correspondentes do teste de Wilcoxon Similarmente às biografias em inglês, os resultados do teste de Wilcoxon indicam que não há diferenças estatisticamente significantes para ambas as métricas (valores de p foram maiores que 0.05 ). É assim que eles...
a) Espanhol
b) Língua inglesa
Figura 5.4 Comparação dos critérios para a sua detenção com referência a um pré-processamento de referência.
Quadro 5.4: Inglês. Tecnologias de desempenho SVM e GLVM. para biografias em inglês, com ou sem derivação.
Stem. Método de Gênero Precisão Record F1 score
(s.d.) valor p avg.
Sem SVM Feminino 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
SVM masculino 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Sim SVM feminina 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
SVM masculino 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
O número de iteração alcançada pelo GSVM não tem impacto na precisão e
a classificação.
Quadro 5.5 Espanhol. Tecnologias de desempenho SVM e GLVM. para biografias em espanhol, com ou sem derivação.
Stem. Método de Gênero Precisão Record F1 score
(s.d.) valor p avg.
Sem SVM Feminino 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
SVM masculino 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Sim SVM feminina 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
SVM masculino 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
O quadro 5.6 amostra para GSVM uma comparação entre derivação e não-derivativa, com os valores de p correspondentes. Para as biografias espanholas, os resultados mostram uma degradação significativa ao incluir derivação com valores de p 0, 0097, 0, 00586 e 0, 00195 para precisão, memória e pontuação F1, respectivamente, nos gêneros femininos. 0, 0137, 0, 00195 e 0, 00195 para precisão, memória e pontuação F1 respectivamente em gêneros masculinos. Em vez disso, para biografias em inglês os valores de p de todas as métricas excedem seu nível e 0,05 Isso indica ausência de um efeito significativo.
Quadro 5.6: Comparação de métricas de desempenho de derivação versus não-derivativas ao aplicar GSVM.
Linguagem Gênero Stem Precision Remember F1 score
avg. p-value aw.p-valuation ases.ct
N.o de Mulher Espanhola 0,909 0,0097 0,907 0,00586 0,903 0,00195 Sim. 0,770 0,781 0,747
N.o masculino 0,889 0,0137 0,913 0,00195 0,891 0,00195 Sim. 0,724 0,790 0,713
N.o de Mulher Inglês 0,908 0,343 0,859 0,124 0,879 1 Sim. 0,880 0,898 0,888
N.o masculino 0,823 0,108 0,909 0,286 0,843 0,636 Sim. 0,899 0,884 0,891
GSVM vs. outros algoritmos
Essa subseção compara o desempenho e o tempo de treinamento da GSVM com outros métodos de autoaprendizagem, como o Random Forests (RF) Breiman. 2001 ) e Boosting Schapire ( 1990 ), de livrarias de software comuns. Nestes testes, os hiperparâmetros do algoritmo são definidos em seus valores padrão. Para cada algoritmo e linguagem, comparamos dois fluxos de trabalho de mineração de texto alternativos para cada métrica: (i) eles incluem um passo de desvio como com a maioria das aplicações de texto convencionais. Usamos o tempo como uma métrica
Comparação, uma vez que não há comparação justa das contagens de iteração, com a implementação de cada método seguindo uma abordagem de iteração diferente.
Comparação do tempo de treino: GSVM versus outros algoritmos
O quadro 5.7 somar o tempo de execução (em segundos) para todas as versões dos algoritmos utilizados com esta pesquisa. Usando derivação para o espanhol, GSVM está em média acima 10,05 vezes mais rápido que o Boosting e 42,87 às vezes mais rápido do que o RF, enquanto para a língua inglesa GSVM é uma média de 15,79 vezes mais rápido do que o Boosting e 59,15 vezes mais rápido do que o RF. Quando a derivação não se aplica, o GSVM é como uma média para cima 49,63 vezes mais rápido do que o Boosting e 81,00 vezes mais rápido do que o RF. GSVM em média 22,91 vezes mais rápido do que o Boosting e 77,70 vezes mais rápido do que o RF. Em suma, com o teste de Wilcoxon realizado e uma diferença estatisticamente significante entre os métodos indica que o tempo de treinamento da GSVM é consistentemente menor do que em outras tecnologias.
Quadro 5.7: média (avg.) e desvio-padrão [d.p.] do tempo de treino
Método de linguagem Stemming Sem estadiamento
avg. (s.d.) p- value apr.tit
Espanhol GSVM 3,096 ( 0,460 ) 2,889 ( 0,150 ) Promoção 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
Espanhol GSVM 3,799 ( 0,074 ) 3,883 ( 0,525 ) Promoção 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
Comparação de precisão: GSVM versus outros algoritmos
Uma vez que a derivação não parece ser significativa com o processamento de biografias em inglês, por razões espaciais vamos focar nossa análise no espanhol dele e dela. O quadro 5.8 mostra uma comparação de derivação versus valores não derivados e os correspondentes valores de p para GSVM, Boosting ou Random Forest. O GSVM obtém resultados muito promissores, especialmente quando a derivação não é usada com precisão e memória. Pontuação F1 acima 90 % Na maioria dos casos, embora Boosting e Random Forest melhorem principalmente o desempenho da GSVM. O facto de ambas as tecnologias pertencerem àqueles conhecidos como métodos inteiros (Sagi e Rokach, 2018 ). Ao treinarem múltiplos modelos e integrarem suas predições, esses métodos melhoram o desempenho preditivo de um único modelo. Note-se que, como a GSVM se comporta com uma MVS padrão em termos de precisão, esses resultados comprovam a importância e relevância para derivação da não-referência em idiomas como o espanhol. Essa técnica de pré-processamento também
afeta os resultados a serem obtidos utilizando outros tipos de classificadores.
Além disso, os valores de p desta tabela 5.8 apresentar uma degradação significativa no desempenho de todos os algoritmos ao aplicar a derivação. Os resultados mostram consistentemente que para o espanhol, sem derivação e precisão do escore F1 foram maiores que 90 % na maioria dos casos, ao utilizar derivação ocorre um arredondamento de degradação. 15 %.
Quadro 5.8: Tecnologias de precisão para métodos de biografia em espanhol.
Método Gênero Stem Precision Remember F1 score
(s.d.) valor p avg.
N.o GSVM Mulher 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 Sim. 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
N.o masculino 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 Sim. 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Aumentar a Mulher Não 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 Sim. 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
N.o masculino 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 Sim. 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF Feminino 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 Sim. 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
N.o masculino 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 Sim. 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 Conclusões
Nesta Seção, consideramos algumas explicações para as diferenças encontradas no desempenho de identificação de gênero e estas refletem sobre as potenciais limitações de nosso trabalho.
5.4.1 Comparação de algoritmos de classificação
Os resultados sugerem que monitorando a aplicação de Stemming na produção de dados textuais, as métricas de desempenho são bastante semelhantes independentemente do algoritmo de autoaprendizagem selecionado para classificação. No entanto, há diferenças dependendo da linguagem utilizada.
Como resultado, podemos concluir que algoritmos de classificação autolearning para identificação de gênero podem ser diretamente afetados por sufixos presentes em conjuntos de dados usados para treinar o algoritmo. Nossos resultados confirmam que o pré-processamento de Stemming, um método que aparentemente simplifica o problema de classificação pode induzir confusão de gênero para resolver essa questão.
5.4.2 Impacto da remoção de hastes
Um dos principais objetivos do quadro proposto é explicar se a retenção e o monitoramento com informações sobre gênero em algumas línguas, como o espanhol, podem proporcionar um melhor desempenho de classificação para identificação de gênero. De acordo com os resultados apresentados nessas tabelas 5.6 e 5.8, há um aumento notável no desempenho da classificação espanhola para os algoritmos que temos considerado com nossos experimentos quando a derivação passa é removida da produção de dados.
Em vez disso, os resultados para a língua inglesa indicam uma variação mínima na métrica de pontuação F1 entre Stemming e não-Scentering aplicando ou preparando dados para qualquer algoritmo de classificação. Essa linguagem tem resultados semelhantes no que diz respeito à precisão e às métricas de desempenho do remember.
No geral, esses resultados apoiam nossa consideração inicial de que evitar a implementação de Stemming pode afetar positivamente a identificação de gênero em textos Quando o conteúdo está disponível com idiomas, fornecendo detalhes morfológicos adicionais que trazem informações de gênero como o espanhol. Confirmando o conhecimento obtido de pesquisas anteriores sobre a importância da fase de produção de dados, especialmente se trabalhar com outras línguas que não Uysal e Gunto ( 2014 ).
5.4.3 Restrições
O novo método GSVM que introduz um critério de parada precoce para a fase de treinamento funciona bem com um problema específico de identificação de gênero de texto. Experimentos adicionais devem, portanto, ser realizados para avaliar o desempenho do GSVM em outras tarefas de classificação antes de recomendar o MSSG como uma inovação metodológica global do VMS com aprendizagem automática.
No que se refere ao quadro proposto para identificação de texto de gênero, uma importante limitação do nosso ambiente experimental é que confinamos um gênero-alvo variável com escolha binária. Problema levantado por outros Hamidi et al. ( 2018 ); Chaves ( 2018 ). Na verdade, você encontrou que 55 de 58 estudos para identificação automática de gênero com autolearning assumiram uma saída binária de geração. Nesse sentido, um caminho potencial para pesquisas futuras poderia ser substituir nossos algoritmos de classificação binária por uma alternativa, pois eles podem ter sido modelos automáticos de aprendizagem que admitem alvos contínuos e/ou multitilaricos. Nesses contextos, seria interessante avaliar se sufixos de gênero ainda têm alguns benefícios para a identificação de gêneros.
Outra limitação de nossa abordagem é que o texto pode não estar disponível em uma língua fortemente inflamada, diferente do inglês. No entanto, nesse caso, o texto poderia ser traduzido automaticamente de espanhol para russo ou outras línguas com propriedades semelhantes através de Serviços Automatizados. A versão traduzida do texto pode fornecer informações de gênero adicionais que permitem otimizar o desempenho da classificação. Da mesma forma, mais pesquisas são necessárias para confirmar que esses resultados iniciais comparando espanhol e inglês são replicados com a entrada de dados em idiomas alternativos.
5.4.4 Inovação
Nesta pesquisa, temos um novo critério de parada para algoritmos de otimização de vetores de suporte baseados nas propriedades geométricas da representação vetorial de conteúdo de texto com o objetivo de resolver o problema automatizado de identificação de gênero. Para esse problema em particular, mostramos que o algoritmo proposto requer menos tempo para treinamento se comparado com a aplicação de algoritmos padrão SVM. No que diz respeito ao framework, em vez de seguir procedimentos convencionais de normalização na mineração de textos que eliminam desafios de gênero, como o encaminhamento, preservamos esses elementos morfológicos encontrados com linguagens fortemente infligidas e os otimizamos seu desempenho. Avaliamos a eficácia dessa nova abordagem em termos de tempos de treinamento, comparando diferentes algoritmos de autoaprendizagem para classificação, utilizando um conjunto de dados biográficos. DATASET-TH-001 e espanhol.
Nossos resultados sugerem que evitemos uma referência (conseqüente) ao pré-processamento de texto para idiomas, incluindo elementos adicionais com informações de gênero, como espanhol e assim por diante. Essa mudança de procedimento não afetou outras línguas neutras como o inglês.