Tillgången till stora och rika textuppsättningar, som huvudsakligen skapats av webbinnehåll, har varit en viktig faktor i datautvinning med algoritmer eller autolearning metoder till oöverträffade priser. Det har genererat ett stort intresse för forskning av automatisk inlärning för textanalys Aggarwal (Aggarwal) 2018 ). Idag, textbrytning Srivastava och Sahami ( 2009 ) och bearbetning av naturspråk (PLN) Eisenstein 2019 ) utgör grunden för många av dessa studier och genomföranden.
5.1 Introduktion
DATASET-TH-001 Vrandeňci' c och Krötzsch ( 2014 ) är ett exempel på en strukturerad och fri tillgång datakälla som förlitar sig på information som utvinns från DATASET-TH-001 på flera språk. Den information som erhållits från artiklarna i DATASET-TH-001 har genomgått en semantisk notationsprocess för att utvidga kunskapsbasen DATASET-TH-001 efter en grafisk strukturerad datamodell för att integrera nya applikationer.
Ett av dessa områden är könsidentifiering i text. Syftet är att tilldela en könsetikett (t.ex. "feminin och manlig) till ett textområde med hjälp av språkliga egenskaper eller andra beskrivande egenskaper. I allmänhet har tidigare forskning fokuserat på att identifiera kön och profil för en person som skriver sin text. Några exempel är könsidentifiering av Yan och Y bloggar författare ( 2006 ) och microblogging
Mukherjee och Bala 2017 ) eller till användare av kundrelationshanteringssystem (CRM) Amado et al. 2018 ).
Skapandet av nya ingångar från DATASET-TH-001 och strukturerade data i artiklarna i DATASET-TH-001 för att slutföra varje ämne. Till exempel, om vi ska få tillbaka strukturerade data om "Gabriel García Márquez och har varit DATASET-TH-001 motsvarande post 2. Sedan kan vi utforska flera områden med beskrivande egenskaper om denna person, inklusive "sex eller kön. 3. I det här exemplet är värdet av den egendomen "manligt. När du skriver denna artikel, hur exakt information kan vara 6 hänvisning till olika artiklar av DATASET-TH-001 som stöder devolutionen av "male.a
Detta fält med hjälp av strukturerade data. Ändå som ett öppet projekt för samarbetsskapandet av kunskap DATASET-TH-001 har ofta lidit vandalism och attacker med Adler et al. 2011 ); Geiger och Ribes ( 2010 ). Om skadliga agenter har ändrat de ursprungliga strukturerade data från DATASET-TH-001 att upptäcka fel utan manuell inspektion skulle vara en komplex uppgift och mer så med tanke på den stora storleken på databasen. DATASET-TH-001. Om det inte finns någon strukturerad information om kön i en artikel av DATASET-TH-001 Det skulle vara omöjligt att tilldela ett värde direkt till "kön eller kön" egendom för dess inträde i DATASET-TH-001 Denna information ska lämnas in till kommissionen vid sitt första möte. Istället för att märka könsinformation som en automatisk analys av textdata som har ostrukturerats i kroppen från DATASET-TH-001 Det kan förbättra motståndskraften mot dessa utmaningar. Det exemplet kan enkelt extrapolera till alla andra informationssystem som automatiskt bör märka innehållet i vissa textblock med en könstagg.
Vi fokuserade på ett specifikt fall, problemet med att automatiskt bestämma hans eller hennes kön som beskrivs i biografisk text. För resten av detta arbete kommer vi att diskutera det problemet som könsidentifiering. Bristen på studier som inkluderar andra språk än engelska gör det svårt att utveckla nya textbrytningsprocedurer i syfte att hantera detta problem. Istället för att fokusera uteslutande på engelska, med färre könselement har vi tittat på att använda spansk text för att fånga morfemer som bär information om kön och är vanligare på detta språk. För att uppnå detta kommer vi att undvika regelbundna normaliseringssteg i gruvdriften av traditionella texter som derivat och Eisensteins lematisering. 2019 ), när de utesluter könsinformation i språkliga termer. Efter detta tillvägagångssätt har vi visat att ett könsvärde kan tilldelas textinnehåll med mer precision.
Vid bearbetning av text med automatisk inlärningsteknik är det vanligtvis användbart.
2 [LINK-REDACTED] 3 [LINK-REDACTED]
För att utföra vektorprestanda med högdimensionell och spridning eftersom de innehåller många komponenter av nollvärde. I en miljö med spridning av högdimensionella representationer, MOguerza et al. (SVM) 2006 ) är beräkningsmässigt lämpliga Jocachims ( 2002 ). Ändå anpassning av traditionell optimeringsproblemlösningsteknik för SVM Joachims (SVM Joachims) 1999 ) tillämpad på könsidentifiering garanterar inte en snabb konvergens eftersom iterationen närmar sig en optimal lösning av dess underliggande optimeringsproblem.
5.2 Förslag
I detta avsnitt, som en del av SVM-ramverket använder vi geometriska egenskaper från en textgenusidentifieringsuppgift för att modifiera ett underliggande optimeringsalgoritms stoppkriterium genom att ersätta Karush-Kuhn-Tucker Feng och Li ( 2018 ) genom ett nytt förslag, som innehåller information (felfrekvensen) Det är inte direkt relaterat matematiskt med ett kriterium som klassisk optimering SVM-algoritm försöker uppfylla eftersom det potentiellt kan anpassa sin natur och geometriska problemlösning. nedan kallad denna modifierade SVM som Geometrics (GLVM). För att utvärdera resultatet av detta nya tillvägagångssätt jämförs dessa förslag med andra Wittan- och al-övervakningsmetoder. 2017 ) för automatisk identifiering av kön inom biografiska texter av litterära författare som utvinns ur DATASET-TH-001. Det kommer att utvärderas om man undviker den gemensamma passagen av lematisering i textbrytning, som tar bort könssubstanser med ord som är viktiga för textningsanalys och förbättrar prestanda på könsidentifiering. GSVM-metodens effektivitet för att accelerera träningsfasen av en algoritm visas också och visar att denna metod inte påverkar förfarandeprestanda väsentligt.
5.2.1 Geometrisk stoppkriterium
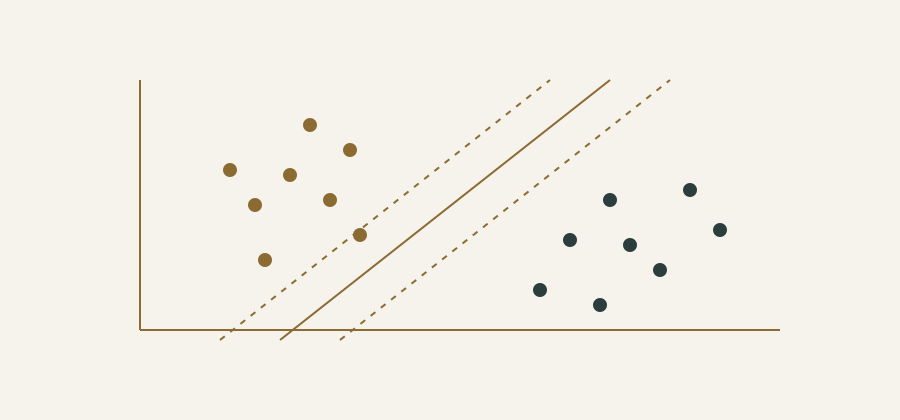
Geometrin för SVM-beslutsfunktion kopplad till utbildningsdata är kvantifierbar inom varje iteration genom att mäta eller uppskatta felfrekvensen. Det vill säga, när denna felfrekvens stabiliserar beslutsfattandet uppfyller dessa kriterier för att effektivt klassificera data. Siffran 5.1 visar ett exempel med två multidimensionella gaussiska moln. Utförandet av en SVM upp till iteration 2 produktion av separationsytan representerad i figur 5.1 ett tag figur 5.1 b visar separationsområdet beräknat till iteration 18. Siffrans beslutsfunktion 5.1 a ger samma empiriska fel som figurbeslutsfunktion 5.1 b, som krävde fler iterationer och
Således mer träningstid för sin konstruktion. Istället byggandet av beslutsfattande funktion i figur 5.1 Han behövde mindre utbildnings iterationer.
(a) SVM körs till iteration 2 (b) SVM körs till iteration 18
Figur 5.1 Två separationsytor med SVM: a) clearance yta som erhållits efter 2 b) separationsområde beräknat efter 18 iterationer.
Baserat på dessa grundvalar definierar vi εk som felfrekvensen för utbildning som fastställs vid iteration K och ∞> 0 som ett verkligt värde som handlar med tolerans. enligt (förutsatt) 2.3 ),
N X
εk = 1
gigantiska g
I = 1 ( 1 − yi f (xi) och 5.1 )
Sea δk = ∞ 124; εks - httg ~ 5 |. Metoden ska stoppas efter att följande efterlevs:
(δk ≤ ∞) 5 {Pos ()} 15 {pos (g)} 100 ε), ( 5.2 )
Där symbolen ") betecknar en logisk operatör och det vill säga med alla fyra ojämlikheter inom sitt kriterium bör uppfyllas samtidigt. Genom att mäta skillnaden δk ≤ ∞ var femte iterationer och koppla av ett klassiskt kriterium, kan vi undvika oönskade toppar av fel som orsakas av slumpmässighet. Följande teorema visar att det finns en direkt koppling mellan kriterierna för kvarhållande ( 2.12 ) och 5.2 ).
Theorema 2. Dada ∞ > 0 och ∞ > 0 ), det finns ett antal iteration kù och β såsom δk ≤ ∞ y m (βg.
Bevis. Till Corollarus 1.1 Det hävdas att:
L ′′ ım k →
m (βk) − M [β ks] = 0
Således finns det ett antal iteration k som nämligen k > Kα möts:
m (β k) - M och g.
Var vektor β † problemlösning (*) 2.5 ), där xi såsom β † I > 0 kallas så stödvektorer. Det är välkänt att funktionen f †, som bestämmer beslutsytan g {(x) = 0 Ta formen:
N X
f † (x) =
I = 1 β † i yiK (xi, x) + b * 5.3 )
med
b † = − pn i) 1 β † iK (xi, x +)
2 + pn i = 1 β i iK (xi, x −)
2,
där x + och x− är två stödvektorer i klasser mer 1 och 1 som deras tillhörande β + och "- Ligrange multiplikator har varit 0 < β + {C} och 0 < β −> C
Låt oss överväga den beslutsfattande funktion som bestäms av detta problem. 2.5 vid iteration k:
N X
f k (x) =
I = 1 β k i yiK (xi, x) + bg.
Det är lätt att bevisa det, ′′ ≤> 0, det finns ett kloe iteration nummer som.k> qy:
g k (x) − f † 5.4 )
Det är på grund av theorema. 1 Det betyder att:
L " ım k → ∞ β g = ß †,
Och sålunda 0 Det finns ett antal iteration k wi att, nämligen k > q.n. det är uppfyllt:
β k − α ′′ ≤ wi.
Om vi tar och hur litet, 5.4 ) möts för ky = k. Dada ∞ > 0 Om vi har och är små nog att ( 5.4 ), och k > k i definitionen ( 5.1 Det är uppfyllt att:
{pos (på engelska) 192,240 )} 5 | ≤τ,
och theorema är giltig för kΩ, β = m ′′ ax {g-q.a.).
□
Sedan kriteriet ( 5.2 ) förlitar sig på felfrekvensen, det är intuitivt att ange ett värde för ∞. Vi kan lägga den, till exempel med a) = 0,0005 Som en felfrekvens upp till 0,05 % kan betraktas som signifikant låg. Denna intuition existerar inte för kriteriet ( 2.12 eftersom storleken på g (β) inte kan beräknas i förväg. Avsnitt 5.3 Vi har visat att för det särskilda fallet av könsidentifiering i texter kan ett lämpligt generaliserande beslutsområde hittas och uppfyllas. 5.2 i betydligt mindre iterationer än vad som krävs för att möta det allmänt använda teoretiska kriteriet. 2.12 ). Nyckelpunkten är den högdimensionella miljö där texten representerades, vilket gör det möjligt att snabbt uppnå en god empirisk generalisering. Således, från en empirisk synvinkel förväntas GSVM ärva generaliseringsegenskaperna för LVM.
5.3 Experiment
I det här avsnittet beskriver vi i detalj problemet med könsidentifiering och hur experiment är inställda.
5.3.1 Problemet
Problemet med könsidentifiering i textdata som en uppföljning av utbildningsklassificeringsuppgiftsutmaningar. På grund av ett textblock som kan märkas med en individs könsetikett, bör algoritmen automatiskt dra slutsatsen. I det här fallet anser vi två potentiella utgångsetiketter: L = { "feminin och manlig) eftersom vårt experimentella dataset endast innehåller instanser av dessa två könsklasser. 5.3.3. Sålunda begränsar vi vårt val av algoritmer till de inriktade på binär klassificering. Samma tillvägagångssätt kan utvidgas för att överväga ytterligare etiketter, omformulera problemet som en uppgift att betygsätta en mot alla eller flera taggar.
Vår arbetsram skiljer sig från tidigare tillvägagångssätt med två utmaningar.
3 ).
Även om tidigare jobb har följts av konventionella textbrytningsförfaranden, till exempel härledning, undviker vi medvetet detta steg för att bevara könssubstans i termer och utforska dess inverkan på könsidentifiering för texter med en stark tippning av ord som spanska.
Istället för att märka en enhetssekvens med ett namn i text, tar vi upp problemet om att tilldela A Gender Label till en textblock eller komplett dokument som beskriver en annan person. Det är ett viktigt problem för många applikationer, inklusive automatisk inmatning i semantiska databaser.
Det finns många språk som har flexat, vilket betyder att ord kan ändra sin form för att återspegla grammatikinformation som antal och tid eller kön Hedlund et al. 2001 ). På spanska, ord som slutar på. eller i en konsonant beteckna manliga genrer medan de med en "är huvudsakligen feminina. Lokaliseringen försöker ta bort skillnader mellan de böjande formerna av ett ord och reducera varje ord till sin rotform. Denna förbehandling har varit standardmetoden för textmining och informationsåterställning för bättre noggrannhet i att identifiera nyckelord med ett visst meddelande.
Men som tidigare nämnts på spanska kan hyperspsis av många ord vara en användbar och direkt indikator för kön. Det är därför det verkar rimligt att anta att om vi inte tillämpar lematisering och bevarar könssubstanser istället kan de förbättra noggrannheten i deras könsidentifiering. Följande strategi för identifiering av könstexter föreslås:
1. Implementera standardtextbrytningsprocedurer för att förbereda en obearbetad inmatning, inklusive tokenisering och tomt ord bortskaffande (utöver genomförande detaljer ges i avsnitt 5.3 ).
2. Före skapandet av vektorrepresentation för varje dokument tyder konventionella textminingmetoder på att vissa Sproat et al. 2001 ), såsom lematisering för att ta bort flexing utmaningar och ge en typisk representation av liknande ord samtidigt minska vokabulär storlek. Istället föreslår vi att undertrycka detta steg av text normalisering och istället bevara flexativa sufix som innehåller ytterligare information om kön på specifika språk.
3. Sedan återväljar vi standarddokumentproduktionsprocessen, genererar en vektorrepresentation av varje papper och bygger en term - bokstavsmatris (igen mer detaljer ges i avsnitt). 5.3 ).
Denna strategi gäller produktion av textdata som kommer att utbilda en autolearning algoritm för könsidentifiering. För att bevisa tillämpligheten av detta förfarande i en verklig miljö har vi utformat ett antal för att genomföra valideringsexperiment och dessa beskrivs enligt följande.
5.3.2 Konfigurera experiment
Huvudmålet är att utvärdera kapaciteten hos vår föreslagna ram för automatisk könsidentifiering i samband med verkliga textdokument. För detta ändamål har vi återfått biografiska artiklar som beskriver litterära författare från de spanska och engelska versionerna. DATASET-TH-001 och dess data matar andra system baserat på semantisk kunskap som DATASET-TH-001. Således har två olika datamängder skapats och en för varje språk. Vi har utformat vår dataset för att säkerställa en lika representation av båda etiketterna vid biografiska ingångar som valts för hans och hennes spanska experiment.
När vi tillämpar vår procedur som en posttext på både spanska och engelska syftar vi till att bekräfta om vi undviker remiss har en positiv inverkan på resultatet av din könsidentitet. Vårt utvalda dataset var biografier av manliga och kvinnliga författare. Det valet gör att vi kan rama in experimentet som ett binärt klassificeringsproblem för vilket det finns flera standard autolearning algoritmer. Siffran 5.2 visar en allmän beskrivning av experimentproceduren för att utvärdera varje övervakad inlärningsmetod.
Varje datamängd av biografier på engelska och spanska är indelad i utbildnings- eller provningssubset. Specifikt, 70 % av biografier på varje språk används för utbildning medan 30 % förblir som en testuppsättning för att utvärdera prestandan hos övervakade inlärningsalgoritmer. Följande avsnitt ger ytterligare detaljer om återhämtning och produktion av båda datamängderna.
5.3.3 Datauppsättningar som används
Vi har börjat återvinna biografier från litterära författare. DATASET-TH-001 genom att övervaka deras webb direkt med hjälp av paketet DATASET-TH-001 Keyes och Til-
Figur 5.2 En beskrivning av den föreslagna ramen för testning av alternativa övervakningsmetoder.
SOFTWARE-TH-003 ( 2017 ) tillgänglig för statistisk miljö R, ORG-TH-112 ( 2022 ). Paketet kan få en lista över sidor, underkategorier och sidinnehåll samt med annan information om en enskild kategori.
Den offentliga dataset som finns tillgängligt i Gomez och al. 2021 a), 4 innehåller 1000 Biografier av författare som utvinns ur DATASET-TH-001 på det engelska språket. Dessa artiklar är lika uppdelade i en grupp kvinnor och en samling med män. Kvinnobiografierna har utvunnits ur kategorin ”författare” och deras första 500 sidor från kategorin "writers mens" av The 19 1900-talet har erhållits för människans biografier.
Den offentliga dataset som finns tillgängligt på spanska Gomez och al. 2021 b) b)
5 innehåller 832 Biografier från DATASET-TH-001 på spanska. Kvinnobiografierna har utvunnits ur kategorin ”Spanish Writers. Tvärtom, först 416 sidor från kategorin "Spanish Writers of The 20 1900-talet har hämtats för mäns biografier. Således är dessa biografier också indelade i två deluppsättningar: en av kvinnorna och en annan om män.
Bordet 5.1 sammanfattar viss allmän statistik från en preliminär undersökning av datamängderna på engelska och spanska enligt beskrivningen ovan.
Vi behandlar tidigare varje biografi med hjälp av ett R-paket av textbrytning tm Feinereer et al. 2008 ). Att ta bort från biografier tomma ord (vanliga termer som normalt inte ger användbar information för analys) Eisens-
4 [LINK-REDACTED] 5 [LINK-REDACTED]
Bord 5.1 Det totala och genomsnittliga antalet som beskriver datamängder på både spanska eller engelska.
Dataset Description Statistikvärde
Totalt antal biografier och genomics 500 Antal olika termer per kvinnlig skrivbiografi 50,86
Antal olika termer per kvinnlig skrivbiografi (staging) 38,11
engelska engelska engelska
Totalt antal biografier om manliga författare 500 Antal distinkta termer per biografi 46,2
Antalet olika termer per manlig skrivbiografi (staging) 35,62
Totalt antal biografier och genomics 416 Antal olika termer per kvinnlig skrivbiografi 50,03
Antal olika termer per kvinnlig skrivbiografi (staging) 31,44
Spanska spanska
Totalt antal biografier om manliga författare 416 Antal olika termer per manlig skrivbiografi 51,39
Antalet olika termer per manlig skrivbiografi (staging) 32,68
Tein (Tein) 2019 ), antal och tecken på poäng med tomma utrymmen. Texten för varje biografi kommer senare att konverteras till mindre och den relativa termbiografimatrisen som visas i denna tabell. 5.2. Således kan varje biografisk uppsättning representeras som en m × n-matris och med ett N-nummer av biografier i träningspaketet. Varje wij-element i termbiografimatrisen representerar ett viktigt eller viktnamn för jag i g biografi. För att få wi j:s värde använder vi TF-IDA Aizawa (TF-IDA) 2003 ), beräknat som ( 5.5 ):
!, ( 5.5 )
wi = t fi j × log N
d fi
där t fi j betecknar antalet händelser från term i biografi J; g är en total siffra för biografier och slutligen, d F3 indikerar hur många biografer som har hittats vid den tiden.
Det bör noteras att endast utbildningsbiografier bidrar till byggandet av ordbok som representerar all biografi. Det vill säga, när klassificeraren kontrollerar nya biografier om en testdel som
Bord 5.2 Exempel på en termbiografi matris, där wi j representerar betydelsen och villkoren i vid biografiska ingång J.
Dictionary Biography 1 Biografi 2... Biografi
University W11 w12... aw1n äktenskap och M21, F9) författare wm1 Wm2
Quer term som inte finns i biografier av träningsuppsättningen ignoreras för beräkning från avstånd. Dessutom har vår studie inte beaktat synonymer och förkortningar eller alternativa former för en viss term.
5.3.4 Resultat
Resultaten av experiment som jämför olika strategier för könsidentifiering i texter presenteras här. Experimenten för varje klassificeringsalgoritm involverar tio försök av utbildningstestdivisioner som valts på azar.För att kunna backa upp resultat har vi utfört tester från Wilcoxon Hollander et al. 2013 ), med beaktande av den statistiska betydelsen för p-värden mindre än 0, 05.
GSVM jämfört med standard AVS
Följande avsnitt sammanfattar resultaten av utvärderingsexperiment som jämför GSVM med standard VMS i textgenusidentifieringsproblem.
Jämförelse av itherationsnummer: GSVM kontra standard AVS
Bordet 5.3 Jämförelse av iterationer räknas för GSVM och en typisk VMS med det klassiska stoppkriteriet. Det är tydligt att med i genomsnitt cirka GSVM för det spanska datasetet. 18 % (med derivat) och 25 % (utan derivat) mindre iterationer än standard SVM-metoden. Samtidigt kan GSVM minska antalet iterationer med cirka 42 % (med derivat) och 44 % (utan derivat). De stora värdena i standardavvikelsen för GSVM är ett resultat av att båda tillvägagångssätten når så högt ett iterationsnummer som definieras för vissa experiment, förstår hur många iterationer som har fastställts med denna modell.
Wilcoxons test av datamängden som finns på engelska visar att GSVM förbättrades i förhållande till LVMN var statistiskt signifikant, både som tillämpad och med hög
ca the stemming (p = värde 0,00195 som om den inte tillämpas (p = 0,00589 ). Om vi tittar på fallet med spanska biografier, är denna förbättring statistiskt signifikant om stemming inte ingår (p = värde 0,00195 ) men är inte signifikant när du använder stemming (p-värde = 0,1 ).
Bord 5.3 Genomsnittlig (prom.) och standardavvikelse av iteration räknas vid träningsstadier
Språkmetod som stammar ingen iscensättning
s.d. p-värde vg.a. p-värden
Spanska spanska 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
Engelska SVM 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
siffrorna 5.3 A, 5.3 b, 5.4 a och 5.4 b har visats grafiskt för varje experiment på vilket antal GSVM och standard AVS iterationer stoppa deras träningsprestanda, respektive. GSVM stop-kriteriet upptäcker hur snart felfrekvensindikatorn kommer att stabiliseras (tipline). Istället kräver det klassiska SVM-fängelsekriteriet ett ökat antal iterationer för att sluta utan att ge någon förbättrad felfrekvens.
Det bör understrykas att prestandan hos GSVM:s stoppkriterium för biografier på engelska är liknande, oavsett om lematiseringsförbearbetning tillämpades (se siffror). 5.3 b och 5.4 b). Ett annat anmärkningsvärt konstaterande är att felfrekvensen för biografier på spanska (se siffror) 5.3 a och 5.4 a) Utöka ett oscillerande mönster när du tillämpar derivationspreprocessing (Figurering) 5.4 a). Detta beteende kan bero på en betydande förlust av information som införs genom hänvisningsoperationen på detta språk.
Slutligen bör det nämnas att bedömningsmätningarna är mycket likartade i alla fall för "feminina" och (manliga) produktionsetiketter med båda språken.
Jämförelse av GSVM vs. noggrannhet Standard SVM
För att utvärdera prestandan för standard SVM-teknik med GOVM har vi övervakat precision, återkalla och poäng mätvärden F1 Baeza-Yates & Ribeiro (F1 Baeza-Yates & Ribeiro) 2011 ); Sokolova och Lapalme 2009 ); Olson och Delen ( 2008 ). Bordet 5.4 visar en jämförelse av SVM och GLVM. för biografier på engelska med eller utan härledning. För varje metod och metrisk visar denna tabell medelvärdet (avg.) med standardavvikelse [s.d.] Dessutom visas p-värdet av Wilcoxons test för varje jämförelse. Wilcoxon-testresultaten indikerar att det inte finns några statistiskt signifikanta skillnader för någon av mätvärdena, liksom hur det anges i en kolumn med p-värde där alla värden har varit högre än 0,05.
a) Spanska
b) engelska språket
Figur 5.3 Ingen härledning. Jämförelse av förvarskriterier om du inte använder remissförädling.
Resultaten som visas i tabeller 5.4 och 5.5 De har visats empiriskt att för textgenusidentifieringsproblem ärver GSVM:s tekniker samma egenskaper som LVM:s och ger liknande precisionsresultat.
Bordet 5.5 visar en jämförelse av SVM och GSSM. för spanska biografier med eller utan härledning. Återigen, för varje metod och metrisk visar denna tabell medelvärdet (avg.) med standardavvikelse [s.d.] samt motsvarande p-värden av Wilcoxons test på samma sätt som biografierna på engelska, tyder Wilcoxons testresultat på att det inte finns några statistiskt signifikanta skillnader för antingen metriska (p-värden har varit högre än 0.05 ). Det är så de...
a) Spanska
b) engelska språket
Figur 5.4 Jämförelse av kriterierna för hans eller hennes frihetsberövande med hänvisning till en remissbehandling.
Bord 5.4 Engelska. SVM och GLVM. prestandateknik för biografier på engelska, med eller utan härledning.
Stem. Könsmetod Precision Recall F1 poäng
(s.d.) p-värde avg.
Ingen kvinnlig SVM 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
Male SVM 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Kvinna SVM 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
Male SVM 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
Antalet iterationer som uppnåtts av GSVM påverkar inte noggrannheten och
klassificeringen.
Bord 5.5 Spanska. SVM och GLVM. prestandateknik för biografier på spanska, med eller utan härledning.
Stem. Könsmetod Precision Recall F1 poäng
(s.d.) p-värde avg.
Ingen kvinnlig SVM 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
Male SVM 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Kvinna SVM 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Male SVM 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Bordet 5.6 prov för GSVM en jämförelse mellan härledning och icke-derivat, med motsvarande p-värden. För spanska biografier visar resultaten en signifikant nedbrytning när det gäller att bland annat härleda p-värden 0, 0097, 0, 00586 och 0, 00195 för precision, återkallelse och F1 poäng respektive i de kvinnliga genrerna. 0, 0137, 0, 00195 och 0, 00195 för precision, återkallelse och F1 poäng respektive i manliga genrer. Istället för biografier på engelska överstiger p-värdena för alla mätvärden deras nivå och 0,05 Det indikerar en frånvaro av en betydande effekt.
Bord 5.6 Jämförelse av derivationsprestanda metrik jämfört med icke-derivat vid tillämpning av GSVM.
Språkgener Stem Precision Recall F1 poäng
avg. p-värde aw.p-valuation wings.ct
Spanska kvinnligt nej 0,909 0,0097 0,907 0,00586 0,903 0,00195 Ja ja ja ja ja ja 0,770 0,781 0,747
Male No 0,889 0,0137 0,913 0,00195 0,891 0,00195 Ja ja ja ja ja ja 0,724 0,790 0,713
Engelska Kvinna Ingen 0,908 0,343 0,859 0,124 0,879 1 Ja ja ja ja ja ja 0,880 0,898 0,888
Male No 0,823 0,108 0,909 0,286 0,843 0,636 Ja ja ja ja ja ja 0,899 0,884 0,891
GSVM mot andra algoritmer
Det underavsnittet jämför GSVM:s prestations- och träningstid med andra autolearning metoder, såsom Random Forests (RF) Breiman. 2001 ) och öka Schapire ( 1990 ), från vanliga programvaruhandlare. I dessa tester är algoritmhyperparametrar inställda på deras standardvärden. För varje algoritm och språk jämför vi två alternativa textbrytningsflöden för varje metrisk: (i) de innehåller ett avvikelsesteg som med de flesta konventionella textningsapplikationer. Vi använder tid som metrisk
Jämförelse eftersom det inte finns någon rättvis jämförelse av iteration räknas, med varje metods genomförande efter en annan iterationsmetod.
Jämförelse av träningstid: GSVM kontra andra algoritmer
Bordet 5.7 sammanfatta körtiden (i sekunder) för alla versioner av algoritmer som används med denna forskning. Med hjälp av derivation för spanska är GSVM i genomsnitt upp 10,05 gånger snabbare än Boosting och 42,87 Ibland snabbare än RF, medan för det engelska språket är GSVM ett genomsnitt upp 15,79 gånger snabbare än Boosting och 59,15 gånger snabbare än RF. När härledningen inte gäller, är GSVM som ett genomsnitt upp 49,63 gånger snabbare än Boosting och 81,00 gånger snabbare än RF. GSVM är i genomsnitt 22,91 gånger snabbare än Boosting och 77,70 gånger snabbare än RF. Sammanfattningsvis, med Wilcoxon test utfört och en statistiskt signifikant skillnad mellan metoder indikerar att GSVM utbildningstid är konsekvent kortare än i annan teknik.
Bord 5.7: medel (avg.) och standardavvikelse [s.d.] av träningstid
Språkmetod som stammar ingen iscensättning
avg. (s.d.) p-värde apr.tit
Spanska GSVM 3,096 ( 0,460 ) 2,889 ( 0,150 ) Öka 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
Spanska GSVM 3,799 ( 0,074 ) 3,883 ( 0,525 ) Öka 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
Precision Jämförelse: GSVM mot andra algoritmer
Eftersom härledningen inte verkar vara betydande med bearbetningsbiografier på engelska, av rymdskäl kommer vi att fokusera vår analys på hans och hennes spanska. Bordet 5.8 visar en derivation jämförelse jämfört med icke-derivat och motsvarande p-värden för GSVM, Boosting eller Random Forest. GSVM får mycket lovande resultat, särskilt när härledningen inte används med precision och återkallelse. F1 poäng över 90 % I de flesta fall, även om Boosting och Random Forest främst förbättrar GSVM prestanda. Det faktum att båda teknikerna tillhör de som kallas hela metoder (Sagi och Rokach, 2018 ). Genom att träna flera modeller och integrera deras förutsägelser förbättrar dessa metoder prediktiv prestanda för en enda modell. Det bör noteras att eftersom GSVM beter sig med en standard MVS när det gäller precision visar dessa resultat vikten och relevansen för härledning från icke-referral till språk som på spansk nivå. Denna preprocessing teknik samt
påverkar de resultat som ska erhållas med hjälp av andra typer av klassimatorer.
Också p-värdena för denna tabell 5.8 visa en signifikant nedbrytning av utförandet av alla algoritmer när de tillämpar härledningen. Resultaten visar konsekvent att för spanska, utan härledning och noggrannhet av F1-poängen har varit högre än 90 % i de flesta fall, medan du använder härledning en avrundning av nedbrytning inträffar. 15 %.
Bord 5.8 Precisionsteknik för biografimetoder på spanska.
Metodgener Stem Precision Recall F1 poäng
(s.d.) p-värde avg.
GSVM Kvinnan Nej 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 Ja ja ja ja ja ja 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Male No 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 Ja ja ja ja ja ja 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Öka kvinnligt nej 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 Ja ja ja ja ja ja 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
Male No 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 Ja ja ja ja ja ja 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF-kvinnan inte 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 Ja ja ja ja ja ja 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
Male No 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 Ja ja ja ja ja ja 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 Slutsatser
I detta avsnitt anser vi vissa förklaringar till skillnaderna i könsidentifieringsprestanda och dessa reflekterar över potentiella begränsningar av vårt arbete.
5.4.1 Jämförelse av klassificeringsalgoritmer
Resultaten tyder på att övervakning av Stemmings tillämpning i textdataproduktion, prestandamätningar är ganska lika oberoende av den automatiska algoritmen som valts för klassificering. Ändå finns det skillnader beroende på språket som används.
Som ett resultat kan vi dra slutsatsen att autolearning klassificeringsalgoritmer för könsidentifiering kan påverkas direkt av sufix som finns i datamängder som används för att träna algoritmen. Våra resultat bekräftar att Stemmings förbehandling, en metod som tydligen förenklar klassificeringsproblemet kan inducera könsförvirring för att lösa problemet.
5.4.2 Påverkan av Stemming Removal
Ett huvudmål för det föreslagna ramverket är att förklara om lagring och övervakning med information om kön på vissa språk, till exempel spanska kan ge en bättre klassificeringsprestanda för könsidentifiering. Enligt de resultat som presenteras i dessa tabeller 5.6 och 5.8 Det finns en ganska anmärkningsvärd ökning av spansk ratingprestanda för de algoritmer som vi har övervägt med våra experiment när derivation passerar avlägsnas från dataproduktion.
Istället indikerar resultat för det engelska språket en minsta variation i F1-poängmått mellan Stemming och icke-Scentering som tillämpar eller förbereder data för någon klassificeringsalgoritm. Det språket har liknande resultat med avseende på återkallelsens noggrannhet och prestandamätningar.
Sammantaget stöder dessa resultat vårt första övervägande att undvika Stemmings genomförande kan påverka könsidentifiering i texter När innehållet är tillgängligt med språk som ger ytterligare morfologiska detaljer om könsinformation som spanska. Bekräfta kunskap som erhållits från tidigare forskning om betydelsen av dataproduktionsfasen, särskilt om arbetet med andra språk än Uysal och Gunto. 2014 ).
5.4.3 Begränsningar
Den nya GSVM-metoden som introducerar ett tidigt stoppkriterium för träningsfasen fungerar bra med ett specifikt problem med textgenusidentifiering. Ytterligare experiment bör därför utföras för att utvärdera GSVM-prestanda i andra klassificeringsuppgifter innan man rekommenderar MSSG som en övergripande metodologisk innovation av VMS med automatisk inlärning.
När det gäller den föreslagna ramen för identifiering av könstext är en viktig begränsning av vår experimentella miljö att vi har begränsat ett mål som är jämställt med binära val. Problem som uppstått av andra Hamidi et al. 2018 ); Keyes (Nycklar) 2018 ). Faktum är att du upptäckte att 55 av 58 studier för automatisk könsidentifiering med autolearning antog en binär generproduktion. I denna mening kan en potentiell väg för framtida forskning vara att ersätta våra binära klassificeringsalgoritmer med ett alternativ eftersom de kan ha varit automatiska inlärningsmodeller som erkänner kontinuerliga och / eller multitilariska mål. I sådana sammanhang skulle det vara intressant att utvärdera om könssubstanser fortfarande har några fördelar för identifiering av genrer.
En ytterligare begränsning av vårt tillvägagångssätt är att texten kanske inte är tillgänglig på ett starkt inflammerat språk, som skiljer sig från engelska. I så fall kan texten översättas automatiskt från spanska till ryska eller andra språk med liknande egenskaper genom Automated Services. Den översatta versionen av texten kan ge ytterligare könsinformation som gör det möjligt att optimera klassificeringsprestanda. På samma sätt krävs mer forskning för att bekräfta att dessa första resultat som jämför spanska och engelska är replikerbara med datainmatning i alternativa språk.
5.4.4 Innovation Innovation Innovation Innovation
I denna forskning har vi ett nytt stoppkriterium för stödvektoroptimering algoritmer baserat på de geometriska egenskaperna hos textinnehåll vektoriell representation med syfte att lösa automatiserade könsidentifieringsproblem. För just detta problem visar vi att den föreslagna algoritmen kräver mindre tid för träning jämfört med vanliga SVM-algoritmer. När det gäller ramverket, i stället för att följa konventionella normaliseringsförfaranden i textbrytning som eliminerar könsutmaningar som remiss bevarar vi dessa morfologiska element som finns med kraftigt tillfogade språk och har dem optimerat deras prestanda. Vi utvärderar hur effektivt detta nya tillvägagångssätt kan sättas i termer av träningstider genom att jämföra olika autolearning algoritmer för klassificering, med hjälp av en biografisk indatamängd. DATASET-TH-001 och spanska.
Våra resultat tyder på att man undviker en hänskjutning (stämpling) till bearbetning av text för språk, inklusive ytterligare element med könsinformation, såsom spanska och så vidare. Förändringen påverkade inte andra neutrala språk som engelska.