La disponibilidad de grandes y ricos conjuntos de datos textuales, creados principalmente a partir de contenido web, ha fomentado la minería de datos, los algoritmos y métodos de aprendizaje automático a un ritmo sin precedentes. Lo que ha generado un alto interés por la investigación del aprendizaje automático para el análisis de texto Aggarwal (2018). Hoy en día, la minería de textos Srivastava y Sahami (2009) y el procesamiento del lenguaje natural (PLN) Eisenstein (2019) constituyen la base de muchos de estos estudios e implementaciones.
5.1 Introducción
DATASET-TH-001 Vrandeˇci ́c y Krötzsch (2014) es un ejemplo de una fuente de datos estructurada y de libre acceso, que se alimenta de la información extraída de artículos de DATASET-TH-001 en múltiples idiomas. Los datos obtenidos de los artículos de DATASET-TH-001 se someten a un proceso de anotación semántica para ampliar la base de conocimiento de DATASET-TH-001, siguiendo un modelo de datos estructurado en gráficos para integrar nuevas aplicaciones.
Una de esas áreas de aplicación es la identificación de género en el texto. El objetivo es asignar una etiqueta de género (por ejemplo, “femenino” o “masculino”) a un bloque de texto basándose en propiedades lingüísticas y otras características descriptivas. En general, las investigaciones anteriores se han centrado en identificar el género y el perfil de la persona que escribe el texto. Algunos ejemplos incluyen la identificación de género de los autores de blogs Yan y Yan (2006) y de microblogging
Mukherjee y Bala (2017) o en usuarios de sistemas de gestión de relaciones con el cliente (CRM) Amado et al. (2018).
La creación de nuevas entradas de DATASET-TH-001 se basa en pistas existentes y datos estructurados en los artículos de DATASET-TH-001 para completar cada tema. Por ejemplo, si queremos recuperar datos estructurados sobre “Gabriel García Márquez”, podemos buscar en DATASET-TH-001 la entrada correspondiente 2. Luego, podemos explorar varios campos con características descriptivas sobre esta persona, incluido el “sexo o género” 3. En este ejemplo, el valor de esta propiedad es “masculino”. En el momento de escribir este artículo, la precisión de esta información se basa en hasta 6 referencias a diferentes artículos de DATASET-TH-001 que respaldan la atribución del valor "masculino.a
este campo basándose en datos estructurados. Sin embargo, como proyecto abierto para la creación colaborativa de conocimiento, DATASET-TH-001 ha sufrido con frecuencia vandalismo y ataques de contenido Adler et al. (2011); Geiger y Ribes (2010). En el caso de que agentes maliciosos alteren los datos estructurados originales de los artículos de DATASET-TH-001, detectar errores sin una inspección manual sería una tarea compleja, más aún dado el gran tamaño de la base de datos de temas de DATASET-TH-001. Además, si no hay información estructurada sobre el género en un artículo de DATASET-TH-001, no sería posible asignar un valor directamente a la propiedad "sexo o género"para su entrada de DATASET-TH-001 correspondiente. En cambio, etiquetar la información de género en función de un análisis automático de datos textuales no estructurados en el cuerpo de los artículos de DATASET-TH-001 podría mejorar la resiliencia frente a estos problemas. Este ejemplo se puede extrapolar fácilmente a cualquier otro sistema de información que deba etiquetar automáticamente el contenido de algún bloque de texto con una etiqueta de género.
Nos centramos en un caso específico, el problema de determinar automáticamente el género de la persona descrita en un texto biográfico. En el resto de este trabajo, nos referiremos a este problema como identificación de género. La falta de estudios que incluyan idiomas distintos del inglés dificulta el desarrollo de nuevos procedimientos en minería de textos para abordar mejor este problema. En lugar de centrarnos exclusivamente en el inglés, que proporciona menos elementos de género, examinamos el uso del texto en español para capturar morfemas que llevan información de género y son más frecuentes en ese idioma. Para conseguirlo, evitaremos los pasos de normalización habituales en la minería de textos tradicional, como los derivados y la lematización Eisenstein (2019), porque descartan la información de género en términos lingüísticos. Siguiendo este enfoque, demostramos que es posible asignar un valor de género al contenido textual con una mayor precisión.
Al procesar texto mediante técnicas de aprendizaje automático, es habitual utili-
2[LINK-REDACTED] 3[LINK-REDACTED]
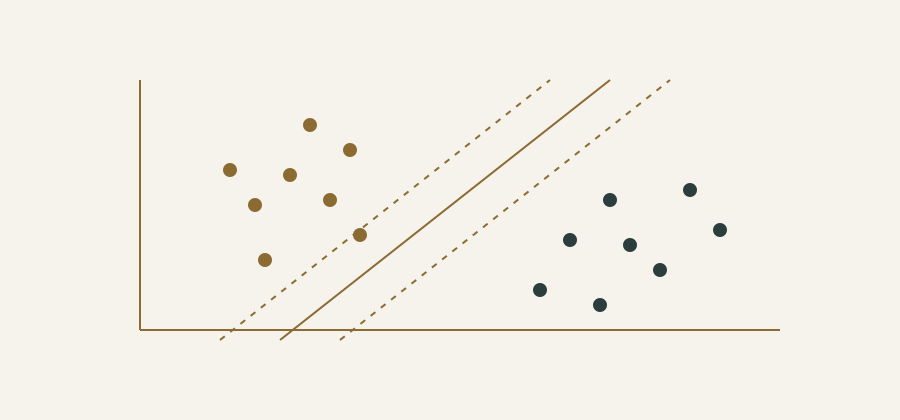
zar representaciones vectoriales, caracterizadas por una alta dimensionalidad y dispersión, ya que contienen numerosos componentes de valor cero. En entorno de representaciones dispersas de alta dimensión, las máquinas de vectores de soporte (SVM) Moguerza et al. (2006) son clasificadores computacionalmente adecuados Joachims (2002). Sin embargo, la adaptación de las técnicas tradicionales de resolución de problemas de optimización para la clasificación SVM Joachims (1999) aplicada a la identificación de género no garantiza una convergencia rápida cuando las iteraciones se acercan a la solución óptima del problema de optimización subyacente.
5.2 Propuesta
En esta sección, dentro del marco de los SVM, se utilizan las propiedades geométricas de la tarea de identificación de género de texto para modificar el criterio de detención del algoritmo de optimización subyacente al sustituir el criterio clásico de Karush-Kuhn-Tucker Feng y Li (2018) por una nueva propuesta, que incorpora información (la tasa de error) que no está directamente relacionada matemáticamente con el criterio que el algoritmo SVM de optimización clásico intenta cumplir, ya que potencialmente puede adaptar la naturaleza del algoritmo al problema geométrico a resolver. En lo sucesivo, se refiere a este SVM modificado como SVM geométrico (GSVM). Para evaluar el rendimiento de este nuevo enfoque, se compara esta nueva propuesta con otros métodos de aprendizaje supervisado Witten et al. (2017) para la identificación automatizada de género dentro de textos biográficos de autores literarios extraídos de DATASET-TH-001. Se evalúa si evitar el paso común de la lematización en la minería de texto, que elimina los sufijos de género en palabras relevantes para el análisis de texto, mejora el rendimiento en la identificación de género. Además, se muestra la efectividad del enfoque GSVM para la aceleración de la fase de entrenamiento del algoritmo y se demuestra que este método no afecta significativamente el rendimiento del procedimiento.
5.2.1 Criterio geométrico de parada
La geometría de la función de decisión de SVM vinculada a los datos de entrenamiento es cuantificable dentro de cada iteración midiendo o estimando la tasa de error. Es decir, cuando dicha tasa de error se estabiliza, la función de decisión cumple con los requisitos para clasificar con éxito los datos. La Figura 5.1 muestra un ejemplo con dos nubes gaussianas bidimensionales. La ejecución de un SVM hasta la iteración 2 produce la superficie de separación representada en la Figura 5.1a, mientras que la Figura 5.1b muestra la superficie de separación calculada hasta la iteración 18. La función de decisión de la Figura 5.1a proporciona el mismo error empírico que la función de decisión de la Figura 5.1b, que requirió más iteraciones y,
por lo tanto, más tiempo de entrenamiento para su construcción. Por el contrario, la construcción de la función de decisión en la Figura 5.1a necesitó menos iteraciones de entrenamiento.
(a) SVM run until iteration 2 (b) SVM run until iteration 18
Figura 5.1: Dos superficies de separación calculadas con SVM: (a) superficie de separación obtenida después de 2 iteraciones; (b) superficie de separación calculada después de 18 iteraciones.
Con base en estos fundamentos, definamos εk como la tasa de error para el conjunto de entrenamiento en la iteración k y τ > 0 como un valor real que actúa como tolerancia. De acuerdo con (2.3),
n X
εk = 1
n
i=1 (1 −yi f(xi))+. (5.1)
Sea δk = |εk −εk−5|. El método se detendrá cuando se cumpla lo siguiente:
(δk ≤τ) ∧(δk−5 ≤τ) ∧(δk−15 ≤τ) ∧(|M(βk) −m(βk)| ≤100ε), (5.2)
donde el símbolo “∧” denota el operador lógico “y”, es decir, las cuatro desigualdades dentro del criterio deben cumplirse simultáneamente. Al medir la desigualdad δk ≤τ cada cinco iteraciones y relajar el criterio clásico, podemos evitar picos de error no deseados causados por la aleatoriedad. El siguiente teorema demuestra que existe una relación directa entre los criterios de detención (2.12) y (5.2).
Teorema 2. Dado τ > 0 y ε > 0, existe un número de iteración kτ,ε tal que δk ≤τ y m(βk) −M(βk) ≤ε, ∀k > kτ,ε.
Demostración. Por Corolario 1.1, se sostiene que:
l ́ım k→∞
m(βk) −M(βk) = 0
Por lo tanto, existe un número de iteración kε tal que ∀k > kε se cumple que:
m(βk) −M(βk) ≤ε.
Sea el vector β∗la solución del problema (2.5), donde xi tal que β∗ i > 0 son los llamados vectores de soporte. Es bien sabido que la función f ∗, que determina la superficie de decisión f ∗(x) = 0, toma la forma:
n X
f ∗(x) =
i=1 β∗ i yiK(xi, x) + b∗, (5.3)
with
b∗= − Pn i=1 β∗ i yiK(xi, x+)
2 + Pn i=1 β∗ i yiK(xi, x−)
2 ,
donde x+ y x−son dos vectores de soporte en las clases +1 y -1, respectivamente, tales que sus multiplicadores de Lagrange asociados β+ y β−sostienen que 0 < β+ < C y 0 < β−< C.
Consideremos la función de decisión determinada por el problema (2.5), en la iteración k:
n X
f k(x) =
i=1 βk i yiK(xi, x) + bk.
Es sencillo demostrar que, ∀γ > 0, existe un número de iteración kγ tal que ∀k > kγ:
f k(x) −f ∗(x) ≤γ. (5.4)
Esto se debe al Teorema 1, que garantiza que:
l ́ım k→∞βk = β∗,
y, por lo tanto, que ∀ν > 0, existe un número de iteración kν tal que, ∀k > kν, se cumple que:
βk −β∗ ≤ν.
Si tomamos ν lo suficientemente pequeño, (5.4) se cumple para kγ = kν. Dado τ > 0, si tomamos γ lo suficientemente pequeño en (5.4), ∀k > kγ, considerando la definición (5.1), se cumple que:
δk = |εk −εk−5| ≤τ,
y el teorema es válido para kτ,ε = m ́ax{kε, kν}.
□
Dado que el criterio (5.2) se basa en la tasa de error, es intuitivo fijar un valor para τ. Podemos fijarlo, por ejemplo, en τ = 0,0005, ya que una tasa de error de hasta 0,05 % puede considerarse significativamente baja. Esta intuición no existe para el criterio (2.12) porque la magnitud de g(β) no puede estimarse de antemano. En la Sección 5.3, demostramos que, para el caso particular de la identificación de género en textos, podemos encontrar superficies de decisión generalizadoras adecuadas que cumplen el criterio (5.2) en significativamente menos iteraciones que las requeridas para cumplir con el criterio teórico comúnmente utilizado (2.12). El punto clave es el entorno de alta dimensión en el que se representa el texto, lo que permite alcanzar una buena generalización empírica rápidamente. Por lo tanto, desde un punto de vista empírico, se espera que GSVM herede las propiedades de generalización de SVM.
5.3 Experimentos
En esta sección, describimos en detalle el problema de identificación de género y la configuración de los experimentos.
5.3.1 Planteamiento del problema
Se plantea el problema de la identificación de género en datos textuales como una tarea de clasificación de aprendizaje supervisado. Dado un bloque de texto cuyo contenido puede etiquetarse con una etiqueta de género asociada con la persona descrita en el texto, el algoritmo debe inferir automáticamente dicha etiqueta. En este caso, consideramos dos posibles etiquetas de salida, L = {“femenino”, “masculino”}, ya que nuestro conjunto de datos experimentales solo contiene instancias de estas dos clases de género, como se describe en la Subsección 5.3.3. Por lo tanto, restringimos nuestra elección de algoritmos a aquellos orientados a la clasificación binaria. El mismo enfoque podría extenderse para considerar etiquetas de salida adicionales, reformulando el problema como una tarea de clasificación de una contra todas o de múltiples etiquetas.
Nuestro marco de trabajo difiere de los enfoques anteriores en dos aspectos prin-
cipales:
Si bien trabajos anteriores siguen procedimientos de minería de texto convencionales, como la derivación, evitamos intencionalmente este paso para conservar el sufijo de género en los términos y explorar su impacto en la identificación de género para textos en idiomas con una fuerte inflexión como el español.
En lugar de etiquetar una secuencia de entidades con nombre en un texto, abordamos el problema de asignar una etiqueta de género a un bloque de texto o a un documento completo que describe a una persona. Este es un problema relevante para muchas aplicaciones, incluida la anotación automática de entradas en bases de datos semánticas.
Hay muchos idiomas que son flexivos, lo que significa que las palabras pueden cambiar su forma para reflejar información gramatical como número, tiempo o género Hedlund et al. (2001). En español, las palabras que terminan en o.o en una consonante denotan género masculino, mientras que las que terminan en a"son principalmente femeninas. La lematización intenta eliminar las diferencias entre las formas flexivas de una palabra para reducir cada palabra a su forma raíz. Este preprocesamiento ha sido el enfoque estándar en la minería de texto y la recuperación de información para mejorar la precisión en la identificación de términos clave en un texto determinado.
Sin embargo, como se mencionó anteriormente, en español, el sufijo de muchas palabras puede ser un indicador práctico y directo del género. Por esta razón, parece razonable suponer que si no aplicamos la lematización y conservamos en su lugar los sufijos de género, podemos mejorar la precisión en la identificación de género. Se propone la siguiente estrategía para la identificación del género de textos:
1. Aplicar procedimientos estándar en minería de textos para preparar el texto de entrada aún sin procesar, incluyendo la tokenización y la eliminación de palabras vacías (se proporcionan detalles de implementación adicionales en la Sección 5.3).
2. Previa a la creación de la representación vectorizada para cada documento, los métodos convencionales de minería de textos sugieren la realización de algún proceso de normalización de texto Sproat et al. (2001), como la lematización, para eliminar los afijos flexivos, proporcionar una representación típica de palabras similares y reducir el tamaño del vocabulario. Por el contrario, proponemos suprimir este paso de normalización de texto, conservando en su lugar los sufijos flexivos que contienen información adicional sobre el género en idiomas específicos.
3. Luego, retomamos el proceso estándar para la preparación de documentos, generando una representación vectorizada de cada documento y construyendo una matriz término-documento (nuevamente, se brindan más detalles en la Sección 5.3).
Esta estrategia se aplica a la preparación de datos textuales que entrenarán un algoritmo de aprendizaje automático para la identificación de género. Para demostrar la aplicabilidad de este procedimiento en un entorno real, hemos diseñado una serie de experimentos de validación, que se describen en la siguiente sección.
5.3.2 Configuración de los experimentos
El objetivo principal es evaluar la capacidad de nuestro marco de trabajo propuesto para la identificación automática del género asociado a documentos de texto del mundo real. Para este propósito, recuperamos artículos biográficos que describen autores literarios de las versiones en inglés y español de DATASET-TH-001, cuyos datos alimentan otros sistemas basados en conocimiento semántico como DATASET-TH-001. Por lo tanto, se crearon dos conjuntos de datos diferentes, uno para cada idioma. Hemos diseñado la construcción de nuestro conjunto de datos para asegurar una representación igualitaria de las dos etiquetas en las entradas biográficas elegidas para nuestros experimentos en inglés y español.
Al implementar nuestro procedimiento en texto de entrada en inglés y español, nuestro objetivo es confirmar si evitar la derivación tiene un impacto positivo en el rendimiento de nuestro clasificador de identificación de género. Nuestro conjunto de datos seleccionado consistió en biografías de autores masculinos y femeninos. Esta elección nos permite enmarcar el experimento como un problema de clasificación binaria para el cual existen varios algoritmos de aprendizaje automático estándar. La figura 5.2 muestra una descripción general del procedimiento experimental para evaluar cada método de aprendizaje supervisado.
Cada conjunto de datos de biografías en inglés y español se divide en los subconjuntos de entrenamiento y prueba. Específicamente, el 70 % de las biografías en cada idioma se utilizan para el entrenamiento, mientras que el 30 % restante se conserva como un conjunto de prueba para evaluar el rendimiento de los algoritmos de aprendizaje supervisado. La siguiente sección proporciona detalles adicionales sobre la recuperación y preparación de ambos conjuntos de datos.
5.3.3 Conjuntos de datos utilizados
Comenzamos, recuperando biografías de autores literarios de DATASET-TH-001, rastreando su web directamente mediante la utilización del paquete DATASET-TH-001 Keyes y Til-
Figura 5.2: Descripción del marco propuesto para probar métodos alternativos de aprendizaje supervisado.
SOFTWARE-TH-003 (2017), disponible para el entorno estadístico R, ORG-TH-112 (2022). Este paquete puede obtener una lista de páginas, subcategorías, contenido de páginas y otra información sobre una categoría específica.
El conjunto de datos disponible públicamente en inglés Gomez et al. (2021a), 4, contiene 1000 biografías de escritores extraídas de DATASET-TH-001 en idioma inglés. Estos artículos están divididos equitativamente en un conjunto de mujeres y un conjunto de hombres. Las biografías de mujeres se han extraído de la categoría “escritoras_mujeres_del_siglo XIX”, mientras que las primeras 500 páginas de la categoría “escritores_hombres_del_siglo XIX” se han obtenido para las biografías de hombres.
El conjunto de datos disponible públicamente en español Gomez et al. (2021b),
5, contiene 832 biografías extraídas de DATASET-TH-001 en idioma español. Las biografías de mujeres se han extraído de la categoría “Escritoras de España”. En contrario, las primeras 416 páginas de la categoría “Escritores de España del siglo XX” se han recuperado para las biografías de hombres. Por lo tanto, estas biografías también se dividen en dos subconjuntos, uno de mujeres y otro de hombres.
La Tabla 5.1 resume algunas estadísticas generales de un análisis exploratorio preliminar de los conjuntos de datos en inglés y español descritos anteriormente.
Procesamos previamente cada biografía utilizando un paquete R de minería de texto tm Feinerer et al. (2008). Eliminando de las biografías las palabras vacías (palabras comunes que normalmente no aportan información útil para el análisis) Eisens-
4[LINK-REDACTED] 5[LINK-REDACTED]
Tabla 5.1: Número total y promedio que describe los conjuntos de datos en inglés y español.
Dataset Descriptive statistics Value
Total number of biographies of female authors 500 Avg. number of distinct terms per female writer biography 50,86
Avg. number of distinct terms per female writer biography (stemming) 38,11
English
Total number of biographies of male authors 500 Avg. number of distinct terms per biography of male writer 46,2
Avg. number of distinct terms per male writer biography (stemming) 35,62
Total number of biographies of female authors 416 Avg. number of distinct terms per female writer biography 50,03
Avg. number of distinct terms per female writer biography (stemming) 31,44
Spanish
Total number of biographies of male authors 416 Avg. number of distinct terms per male writer biography 51,39
Avg. number of distinct terms per male writer biography (stemming) 32,68
tein (2019),números, signos de puntuación y espacios en blanco. Más tarde, el texto de cada biografía se convierte a minúsculas y se crea la matriz término-biografía correspondiente, como se presenta en la Tabla 5.2. De este modo, cada conjunto biográfico se puede representar como una matriz m × n, donde m es el número de términos únicos en el diccionario y n es el número de biografías en el conjunto de entrenamiento. Cada elemento wij de la matriz término-biografía representa la importancia o el peso del término i en la biografía j. Para obtener el valor de wi j utilizamos la medida TF-IDF Aizawa (2003), calculada como (5.5):
! , (5.5)
wij = t fi j × log n
d fi
donde t fi j denota el número de ocurrencias del término i en la biografía j; n es el número total de biografías del conjunto de entrenamiento; y, finalmente, d fi es el número de biografías en las que aparece el término i.
Cabe señalar que sólo las biografías de entrenamiento contribuyen a la construcción del diccionario de términos que representa todas las biografías. Es decir, cuando el clasificador comprueba nuevas biografías sobre el subconjunto de prueba, cual-
Tabla 5.2: Ejemplo de matriz término-biografía, donde wi j representa la importancia del término i en la entrada biográfica j.
Dictionary Biography 1 Biography 2 ... Biography n
University w11 w12 ... w1n Marriage w21 w22 ... w2n Novel w31 w32 ... w3n ... ... ... ... ... Writer wm1 wm2 ... wmn
quier término no encontrado en las biografías del conjunto de entrenamiento se ignora para el cálculo de la distancia. Asimismo, en nuestro estudio no se han considerado sinónimos, abreviaturas o formas alternativas para un término determinado.
5.3.4 Resultados
En esta sección se presentan los resultados de experimentos que comparan diferentes estrategias para la identificación de género en textos. Los experimentos para cada algoritmo de clasificación implican diez ensayos de divisiones de prueba de entrenamiento seleccionadas al azar.Con el objeto de poder respaldar los resultados, se han realizado tests de hipótesis estadísticos de Wilcoxon Hollander et al. (2013), habiendo considerado la significancia estadística para valores de p inferiores a 0, 05.
GSVM versus estándar SVM
Las siguientes secciones resumen los resultados de los experimentos de evaluación que comparan GSVM con SVM estándar en el problema de la identificación de género del texto.
Comparación del número de iteraciones: GSVM versus SVM estándar
La tabla 5.3 compara el recuento de iteraciones para GSVM y un SVM típico utilizando el criterio de parada clásico. Es claro que, en promedio, para el conjunto de datos en español, GSVM converge a aproximadamente 18 % (con derivados) y 25 % (sin derivados) menos iteraciones que el enfoque SVM estándar. A su vez, para el conjunto de datos disponible en inglés, GSVM permite reducir el número de iteraciones en aproximadamente 42 % (con derivados) y 44 % (sin derivados). Los grandes valores en la desviación estándar para GSVM son una consecuencia de que ambos enfoques alcanzan el número máximo definido de iteraciones para algunos experimentos, entiéndase como el número de iteraciones del enfoque SVM estándar.
El test de Wilcoxon sobre el conjunto de datos disponibles en inglés muestra que la mejora de GSVM sobre SVM es estadísticamente significativa, tanto cuando se apli-
ca el stemming (valor p = 0,00195) como cuando no se aplica (valor p = 0,00589). Si observamos el caso de las biografías en español, la mejora es estadísticamente significativa cuando no se incluye el stemming (valor p = 0,00195), pero no es significativa cuando se utiliza el stemming (valor p = 0,1).
Tabla 5.3: Promedio (prom.) y desviación estándar (d.e.) del recuento de iteraciones en las etapas de entrenamiento.
Language Method Stemming No stemming
avg. s.d. p-value avg. s.d. p-value
Spanish SVM 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
English SVM 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
Las figuras 5.3a, 5.3b, 5.4a y 5.4b muestran gráficamente, para cada experimento, en qué recuento de iteraciones GSVM y SVM estándar detienen su ejecución de entrenamiento, respectivamente. El criterio de detención de GSVM detecta el instante en el que el indicador de la tasa de error se estabiliza (línea de puntos) siempre. Por el contrario, el criterio de detención SVM clásico requiere un mayor número de iteraciones para detenerse sin proporcionar ninguna mejora de la tasa de error.
Se debe destacar que el desempeño del criterio de parada de GSVM para biografías en inglés sea similar, independientemente de si se aplica o no el preprocesamiento de lematización (ver Figuras 5.3b y 5.4b). Otro hallazgo notable es que la tasa de error para biografías en español (ver Figuras 5.3a y 5.4a) exhibe un patrón oscilante cuando se aplica el preprocesamiento de derivación (Figura 5.4a). Este comportamiento puede deberse a una pérdida significativa de información introducida por la operación de derivación en este idioma.
Por último se debe mencionar, que las métricas de evaluación son muy similares, en todos los casos, para las etiquetas de salida “femenino” y “masculino” en ambos idiomas.
Comparación de la precisión de GSVM vs. SVM estándar
Con el el objetivo de evaluar el rendimiennto de la técnica de SVM estándar con el GSVM observamos las métricas de precisión, recall y puntuación F1 Baeza-Yates y Ribeiro-Neto (2011); Sokolova y Lapalme (2009); Olson y Delen (2008). La tabla 5.4 muestra una comparación de SVM y GSVM para biografías en inglés, con y sin derivación. Para cada método y métrica, esta tabla muestra el promedio (avg.) y la desviación estándar (s.d.). Además, se muestra el valor p del test de Wilcoxon por cada comparación. Los resultados del test de Wilcoxon indican que no hay diferencias estadísticamente significativas para ninguna de las métricas consideradas, tal y cómo se indica en la columna del valor p, donde todos los valores son mayores que 0,05.
(a) Spanish language
(b) English language
Figura 5.3: Sin derivación. Comparación de los criterios de detención en el caso de no utilizar el preprocesamiento de derivación.
Los resultados expuestos en las Tablas 5.4 y 5.5 muestran empíricamente que para los problemas de identificación de género de texto, las técnicas de GSVM heredan las mismas propiedades de las de SVM, proporcionando resultados de precisión similares.
La tabla 5.5 muestra una comparación de SVM y GSVM para biografías en español, con y sin derivación. Nuevamente, para cada método y métrica, esta tabla muestra el promedio (avg.), la desviación estándar (s.d.) y los valores p correspondientes de la prueba de Wilcoxon. De manera similar a las biografías en inglés, los resultados de la prueba de Wilcoxon indican que no hay diferencias estadísticamente significativas para ninguna de las métricas (los valores p son mayores que 0.05). Como consecuen-
(a) Spanish language
(b) English language
Figura 5.4: Comparación de los criterios de detención cuando se aplica el preprocesamiento de derivación.
Tabla 5.4: Inglés. Métricas de rendimiento de SVM y GSVM para biografías en clasificación en inglés, con y sin derivación.
Stem. Gender Method Precision Recall F1 score
avg. (s.d.) p-value avg. (s.d.) p-value avg. (s.d.) p-value
No Female SVM 0,919 (0,038) 0,812 0,873 (0,011) 0,188 0,895 (0,021) 0,438 GSVM 0,908 (0,039) 0,859 (0,093) 0,879 (0,049)
Male SVM 0,865 (0,018) 0,63 0,917 (0,031) 1 0,889 (0,014) 1 GSVM 0,823 (0,205) 0,909 (0,036) 0,843 (0,159)
Yes Female SVM 0,911 (0,044) 0,812 0,879 (0,018) 0,0625 0,894 (0,027) 0,312 GSVM 0,880 (0,049) 0,898 (0,036) 0,888 (0,031)
Male SVM 0,873 (0,018) 0,125 0,910 (0,036) 1 0,891 (0,017) 0,438 GSVM 0,899 (0,036) 0,884 (0,035) 0,891 (0,020)
cia, la caída en el número de iteraciones logradas por GSVM no afecta la precisión de
la clasificación.
Tabla 5.5: Español. Métricas de rendimiento de SVM y GSVM para biografías en clasificación en español, con y sin derivación.
Stem. Gender Method Precision Recall F1 score
avg. (s.d.) p-value avg. (s.d.) p-value avg. (s.d.) p-value
No Female SVM 0,929 (0,028) 1 0,918 (0,019) 0,0625 0,923 (0,014) 0,625 GSVM 0,909 (0,065) 0,907 (0,093) 0,903 (0,042)
Male SVM 0,913 (0,034) 0,188 0,929 (0,020) 1 0,920 (0,018) 0,188 GSVM 0,889 (0,140) 0,913 (0,057) 0,891 (0,079)
Yes Female SVM 0,751 (0,092) 0,0625 0,810 (0,072) 0,0625 0,773 (0,040) 0,625 GSVM 0,770 (0,177) 0,781 (0,139) 0,747 (0,079)
Male SVM 0,809 (0,115) 0,0625 0,768 (0,054) 0,125 0,780 (0,054) 0,0625 GSVM 0,724 (0,251) 0,790 (0,105) 0,713 (0,155)
La tabla 5.6 muestra para GSVM una comparación entre la derivación y la no derivación, junto con los valores p correspondientes. Para las biografías en español, los resultados muestran una degradación significativa cuando se incluye la derivación, con valores p de 0, 0097, 0, 00586 y 0, 00195, para precisión, recall y puntuación F1, respectivamente, en el género femenino; y valores p de 0, 0137, 0, 00195 y 0, 00195, para precisión, recall y puntuación F1, respectivamente, en el género masculino. En cambio, para las biografías en inglés, los valores p para todas las métricas superan el nivel de significación de 0,05, lo que indica la ausencia de un efecto significativo.
Tabla 5.6: Comparación de métricas de rendimiento de la derivación versus la no derivación cuando se aplica el método GSVM.
Language Gender Stem Precision Recall F1 score
avg. p-value avg. p-value avg. p-value
Spanish Female No 0,909 0,0097 0,907 0,00586 0,903 0,00195 Yes 0,770 0,781 0,747
Male No 0,889 0,0137 0,913 0,00195 0,891 0,00195 Yes 0,724 0,790 0,713
English Female No 0,908 0,343 0,859 0,124 0,879 1 Yes 0,880 0,898 0,888
Male No 0,823 0,108 0,909 0,286 0,843 0,636 Yes 0,899 0,884 0,891
GSVM vs. otros algoritmos
En esta subsección se compara el rendimiento y el tiempo de entrenamiento del método GSVM con otros métodos de aprendizaje automático, como, Random Forests (RF) Breiman (2001) y Boosting Schapire (1990), procedentes de librerías de software de uso común. En estas pruebas, los hiperparámetros de los algoritmos se fijan en sus valores predeterminados. Para cada algoritmo e idioma, comparamos dos flujos de trabajo de minería de texto alternativos para cada métrica: i) incluyen un paso de derivación, como en la mayor parte de las aplicaciones de minería de texto convencionales; y ii) evitan la derivación, conservando los afijos que proporcionan información de género adicional en algunos idiomas. Usamos el tiempo como métrica
de comparación, dado que no hay posibilidad de comparar de manera justa los recuentos de iteraciones, ya que la implementación de cada método sigue un enfoque de iteración diferente.
Comparación del tiempo de entrenamiento: GSVM versus otros algoritmos
La tabla 5.7 resume el tiempo de ejecución (en segundos) para todas las versiones de los algoritmos utilizados en esta investigación. Utilizando derivación para el idioma español, GSVM es, en promedio, hasta 10,05 veces más rápido que el método Boosting y 42,87 veces más rápido que RF, mientras que, para el idioma inglés, GSVM es, en promedio, hasta 15,79 veces más rápido que Boosting y 59,15 veces más rápido que RF. Cuando no se aplica derivación, para el idioma español, GSVM es, en promedio, hasta 49,63 veces más rápido que Boosting y 81,00 veces más rápido que RF. En cuanto al inglés, GSVM es, en promedio, hasta 22,91 veces más rápido que Boosting y 77,70 veces más rápido que RF. En resumen, con base en la prueba de Wilcoxon realizada, la columna de valor p indica una diferencia estadísticamente significativa entre los métodos, lo que demuestra que el tiempo de entrenamiento de GSVM es consistentemente menor que en los otros métodos.
Tabla 5.7: Media (avg.) y desviación estándar (s.d.) del tiempo de entrenamiento.
Language Method Stemming No stemming
avg. (s.d.) p-value avg. (s.d.) p-value
Spanish GSVM 3,096 (0,460) 2,889 (0,150) Boosting 31,110 (1,001) 0,002 143,370 (289,894) 0,002 RF 132,718 (46,366) 0,002 234,024 (71,339) 0,002
English GSVM 3,799 (0,074) 3,883 (0,525) Boosting 59,978 (6,650) 0,002 88,976 (18,596) 0,002 RF 224,732 (17,882) 0,002 301,715 (6,568) 0,002
Comparación de precisión: GSVM versus otros algoritmos
Dado que la derivación no parece ser significativa al procesar biografías en inglés, por razones de espacio, centraremos el resto de nuestro análisis en las biografías en español. La tabla 5.8 muestra una comparación de derivación versus no derivación, y los valores p correspondientes, para GSVM, Boosting y Random Forest. GSVM obtiene resultados muy prometedores, especialmente cuando no se utiliza derivación, con precisión, recall y puntuación F1 por encima del 90 % en la mayor parte de los casos, aunque Boosting y Random Forest mejoran principalmente los resultados de GSVM. Hecho, que constata que ambas técnicas pertenecen a los conocidos como métodos de conjunto (Sagi y Rokach, 2018). Al entrenar múltiples modelos e integrar sus predicciones, estos métodos mejoran el rendimiento predictivo de un solo modelo. Cabe destacar que, dado que GSVM se comporta como un SVM estándar en términos de precisión, estos resultados demuestran la importancia de la derivación frente a la no derivación en idiomas como el español. Esta técnica de preprocesamiento también
afecta a los resultados que se obtendrían utilizando otros tipos de clasificadores.
Además, los valores p de la Tabla 5.8 muestran una degradación significativa en el rendimiento de todos los algoritmos cuando se aplica la derivación. Estos resultados muestran consistentemente que para el idioma español, sin derivación, la precisión, la recuperación y la puntuación F1 son superiores al 90 % en la mayor parte de los casos, mientras que al utilizar derivación se produce un redondeo de degradación del 15 %.
Tabla 5.8: Métricas de precisión para métodos sobre biografías en español.
Method Gender Stem Precision Recall F1 score
avg. (s.d.) p-value avg. (s.d.) p-value avg. (s.d.) p-value
GSVM Female No 0,909 (0,065) 0,00977 0,907 (0,093) 0,00586 0,903 (0,042) 0,00195 Yes 0,770 (0,177) 0,781 (0,139) 0,747 (0,079)
Male No 0,889 (0,140) 0,0137 0,913 (0,057) 0,00195 0,891 (0,079) 0,00195 Yes 0,724 (0,251) 0,790 (0,105) 0,713 (0,155)
Boosting Female No 0,944 (0,018) 0,00195 0,938 (0,017) 0,00195 0,941 (0,012) 0,00195 Yes 0,769 (0,044) 0,694 (0,037) 0,729 (0,022)
Male No 0,936 (0,020) 0,00195 0,943 (0,015) 0,00195 0,939 (0,011) 0,00195 Yes 0,655 (0,038) 0,736 (0,053) 0,691 (0,027)
RF Female No 0,957 (0,016) 0,00195 0,970 (0,022) 0,00195 0,963 (0,011) 0,00195 Yes 0,816 (0,046) 0,790 (0,065) 0,800 (0,037)
Male No 0,971 (0,021) 0,00195 0,956 (0,020) 0,00195 0,963 (0,012) 0,00195 Yes 0,779 (0,066) 0,806 (0,048) 0,789 (0,036)
5.4 Conclusiones
En esta sección, consideramos algunas explicaciones para las diferencias detectadas en el rendimiento de identificación de género y estas reflexionan sobre posibles limitaciones en nuestro trabajo.
5.4.1 Comparación de algoritmos de clasificación
Los resultados sugieren que el control de la aplicación de Stemming en la preparación de datos textuales, las métricas de rendimiento son bastante similares, independientemente del algoritmo de aprendizaje automático seleccionado para la clasificación. Sin embargo, existen diferencias dependiendo del lenguaje utilizado.
Como resultado, podemos concluir que los algoritmos de clasificación de aprendizaje automático para la identificación de género pueden verse directamente afectados por los sufijos presentes en los conjuntos de datos utilizados para entrenar los algoritmos. Nuestros resultados confirman que el preprocesamiento de Stemming, un método que aparentemente simplifica el problema de clasificación, puede inducir la confusión de género para resolver el problema en cuestión.
5.4.2 Impacto de la eliminación de stemming
Uno de los objetivos principales del marco propuesto es explorar si la retención de elementos morfológicos que contienen información de género en algunos idiomas, como el español, pueden proporcionar un rendimiento de clasificación superior para la identificación de género en el texto. De acuerdo con los resultados presentados en las tablas 5.6 y 5.8, hay un incremento bastante notable en el rendimiento de clasificación en español para los algoritmos considerados en nuestros experimentos cuando el paso de derivación se elimina del proceso de preparación de datos.
Por el contrario, los resultados para el idioma inglés indican una variación mínima en la métrica de puntaje de F1 entre la aplicación de Stemming o no en el proceso de preparación de datos para cualquier algoritmo de clasificación. Este lenguaje tiene resultados similares con respecto a la precisión y las métricas de rendimiento del recall.
De forma global, estos resultados respaldan nuestra consideración inicial que evitar la aplicación del Stemming puede afectar positivamente la identificación de género en los textos Cuando el contenido está disponible en idiomas que proporcionan detalles morfológicos adicionales que traen información de género, como el español. Confirmando el conocimiento obtenido en investigaciones previas sobre la importancia de la fase de preparación de los datos, sobre todo si se trabaja con idiomas distintos del inglés Uysal y Gunal (2014).
5.4.3 Limitaciones
El nuevo método GSVM que introduce un criterio de detención temprano para la fase de entrenamiento funciona bien para el problema específico de la identificación de género de texto. Por lo tanto, se deben realizar experimentos adicionales para evaluar el rendimiento de GSVM en otras tareas de clasificación antes de recomendar GSVM como una innovación metodológica general de SVM en el aprendizaje automático.
En cuanto al marco propuesto para la identificación de género de texto, Una limitación importante de nuestro entorno experimental es que circunscribimos la variable de género objetivo a una elección binaria. Problema planteado por otros autores Hamidi et al. (2018); Keyes (2018). De hecho, ? encontró que 55 de 58 estudios para la identificación automática de género con aprendizaje automático asumieron una salida de género binaria. En este sentido, una posible ruta para futuras investigaciones podría ser reemplazar nuestros algoritmos de clasificación binaria con una alternativa como podrías ser modelos de aprendizaje automático que admitan objetivos continuos y/o multivariantes. En tales contextos, sería interesante evaluar si los sufijos de género aún proporcionan algunas ventajas para la identificación de género.
Otra limitación de nuestro enfoque es que el texto de entrada puede no estar disponible en un idioma fuertemente inflexionado, diferente del inglés. Sin embargo, en ese caso, el texto podría traducirse automáticamente de Inglés a español u otros idiomas con propiedades similares a través de Servicios automatizados. Esta versión traducida del texto de entrada puede proporcionar información de género adicional que permite optimizar el rendimiento de la clasificación. De la misma manera, se necesita más investigación para confirmar que estos resultados iniciales que comparan inglés y español son replicables con la entrada de datos en idiomas alternativos.
5.4.4 Innovación
En esta investigación, presentamos un nuevo criterio de detención para los algoritmos de optimización de vectores de soporte basados en las propiedades geométricas de la representación vectorial del contenido de texto con el objetivo de resolver el problema de la identificación de género automatizado. Para este problema en particular, mostramos que el algoritmo propuesto requiere menos tiempo para el entrenamiento si lo comparamos con la aplicación de algoritmos SVM estándar. Con respecto al marco, en lugar de seguir los procedimientos de normalización convencionales en la minería de texto que eliminan los afijos de género, como la derivación, conservamos esos elementos morfológicos encontrados en lenguajes fuertemente infligidos con el fin de optimiza el rendimiento de los métodos de identificación de género. Evaluamos la efectividad de este nuevo enfoque en términos de tiempos de capacitación comparando diferentes algoritmos de aprendizaje automático para la clasificación, utilizando un conjunto de datos de entradas biográficas de DATASET-TH-001 en inglés y español.
Nuestros resultados sugieren que evitar la derivación (stemming) en el preprocesado del texto para idiomas que incluyen elementos adicionales que incorporan información de género, como el español, es positivo. Este cambio de procedimiento no afecta a otro idiomas neutrales como el Inglés.