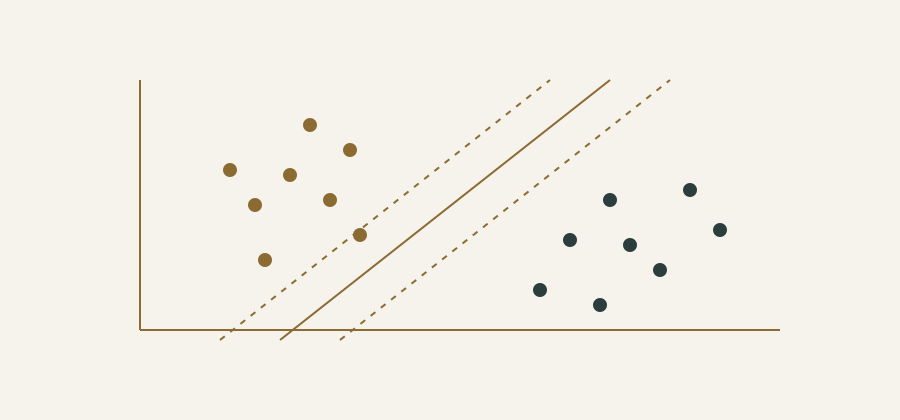
وقد شجعت توافر مجموعات كبيرة وغنية من البيانات النصية، التي تم إنشاؤها بشكل رئيسي من محتوى الويب، إلى تزويد تزويد البيانات والخوارزميات وأساليب التعلم الآلي بوتيرة غير مسبوقة. ما الذي خلق اهتمامًا كبيرًا بالبحث عن التعلم الآلي لتحليل النص Aggarwal ( 2018 ). اليوم، التعدين النصوص Srivastava و Sahami ( 2009 معالجة اللغة الطبيعية (PLN) 2019 ) تشكل الأساس للعديد من هذه الدراسات والتنفيذات.
5.1 مقدمة
DATASET-TH-001 وَقَالَ الْمُسْلِمُونَ ( 2014 ) هو مثال على مصدر بيانات مركّز ومحرّم الوصول، يتغذى على المعلومات المستخرجة من مقالات DATASET-TH-001 في العديد من اللغات. بيانات المستندات إلى مقالات DATASET-TH-001 يتم إجراء عملية ملاحظة علمية لتوسيع قاعدة المعرفة DATASET-TH-001, اتبع نموذج بيانات مركبة في الرسومات لدمج تطبيقات جديدة.
واحدة من تلك المجالات التطبيقية هو تحديد الجنس في النص. الهدف هو تخصيص علامة الجنس (على سبيل المثال، "المرأة" أو "الرجال") إلى كتلة نصية استنادا إلى الخصائص اللغوية وغيرها من الخصائص الوصفية. وبشكل عام، تركز الأبحاث السابقة على تحديد الجنس والملف الشخصي الذي يكتب النص. بعض الأمثلة تشمل تحديد الجنس من مؤلفي المدونات يان و يان ( 2006 من خلال microblogging
وَالْمُسْتَقِيمِ وَالْمُسْتَقِيمِ ( 2017 ) أو في مستخدمي أنظمة إدارة العلاقات مع العملاء (CRM) Amado et al. ( 2018 ).
إنشاء إدخالات جديدة من DATASET-TH-001 ويستند إلى النصوص والبيانات الموجودة في المواد DATASET-TH-001 لإنهاء كل موضوع. على سبيل المثال، إذا كنا نريد استرداد البيانات المنظمة حول “غابرييل غارسي ماركيز”، يمكننا البحث في DATASET-TH-001 الدخول المناسب 2. ثم يمكننا استكشاف العديد من الحقول التي تحتوي على خصائص وصفية لهذا الشخص، بما في ذلك "الجنس أو الجنس" 3. في هذا المثال ، فإن قيمة هذه الملكية هي "الرجال". في الوقت الذي كتبت فيه هذه المقالة، دقة هذه المعلومات تعتمد على 6 إشارات إلى مقالات مختلفة من DATASET-TH-001 ويدعمون تعيين القيمة "الرجال"
هذا المجال يعتمد على البيانات المنظمة. ولكن، كشروع مفتوح لإنشاء المعرفة التعاونية، DATASET-TH-001 وقد عانى من غالبية الحوادث والهجمات المحتوى Adler et al. ( 2011 ); وَالْمُسْتَقِيمِينَ وَالْمُسْتَقِيمِينَ ( 2010 ). في حالة تغيير العوامل الخبيثة البيانات الهيكلية الأصلية من المواد DATASET-TH-001, اكتشاف الأخطاء دون فحص يدوي سيكون من المهمة المعقدة ، وخاصة بالنظر إلى حجم قاعدة بيانات المواضيع الكبيرة DATASET-TH-001. وبالإضافة إلى ذلك، إذا لم يكن هناك معلومات متكاملة عن الجنس في مقالة DATASET-TH-001 لن يكون من الممكن تخصيص قيمة مباشرة لملكية "الجنس أو الجنس"لدخولها إلى DATASET-TH-001 و المطابقة. بدلا من ذلك، وضع علامة على معلومات الجنس على أساس تحليل تلقائي للبيانات النصية غير المنظمة في جسم العناصر DATASET-TH-001 يمكن أن تحسن مقاومة هذه المشاكل. يمكن إزالة هذا المثال بسهولة إلى أي نظام معلومات آخر يجب أن يلصق تلقائيًا بمحتوى أي كتلة نصية مع علامة جنسية.
نحن نركز على حالة محددة، مشكلة تحديد تلقائيًا جنس الشخص الموصوف في نص السيرة الذاتية. في بقية هذه العملية ، سوف نتحدث عن هذه المشكلة كمعرفة الجنس. إن نقص الدراسات التي تشمل لغات مختلفة عن اللغة الإنجليزية يمنع تطوير إجراءات جديدة في تزويد النصوص من أجل التعامل بشكل أفضل مع هذه المشكلة. بدلاً من التركيز حصرياً على اللغة الإنجليزية، التي توفر أقل من عناصر الجنس، ندرس استخدام النص باللغة الإسبانية لالتقاط المورفيمات التي تحمل معلومات الجنس وتكون أكثر شيوعاً في تلك اللغة. من أجل تحقيق ذلك، سوف نتجنب خطوات التعيين المعتادة في التعدين التقليدي النصوص، مثل الناتج المحلي والليماتيك Eisenstein ( 2019 ( ) لأنهم يرفضون معلومات الجنس من الناحية اللغوية. من خلال اتباع هذا النهج، نثبت أنه من الممكن تخصيص قيمة الجنس للمحتوى النصي بدقة أكبر.
عند معالجة النص باستخدام تقنيات التعلم الآلي ، فهي عادة مفيدة.
2 [LINK-REDACTED] 3 [LINK-REDACTED]
تشير التمثيلات الفكتورية، وتتميز بمتعدد الأبعاد والانفصال، حيث تحتوي على العديد من مكونات القيمة الصفرية. في بيئة التمثيلات المشتتة ذات الأبعاد العالية ، آلات الدعم (SVM) Moguerza et al. ( 2006 ) هي تصنيفات الكمبيوتر المناسبة Joachims ( 2002 ). ومع ذلك، فإن التكيف التقليدي لتقنيات حل المشاكل التحسينية لدرجة SVM Joachims ( 1999 لا يضمن التعرف على الجنس اتساقًا سريعًا عندما تقترب الإيترارات من الحل الأمثل لمشكلة التحسين الأساسية.
5.2 المقترح
في هذا القسم ، ضمن إطار SVM ، تستخدم الخصائص الجغرافية لمهمة تحديد الجنس النصي لتعديل معيار التوقف من خوارزميات التحسين الأساسية عن طريق استبدال معيار كلاسيكي Karush-Kuhn-Tucker Feng و Li ( 2018 ) من خلال اقتراح جديد ، الذي يضم المعلومات (معدل الخطأ) التي ليست مرتبطة بشكل مباشر رياضيا مع المعيار الذي يحاول خوارزمي SVM التحسين الكلاسيكي الوفاء به ، حيث يمكن أن تتكيف بشكل محتمل طبيعة الخوارزميات مع المشكلة الجيومترية التي يجب حلها. في ما يلي ، يشير إلى هذا SVM المعدل باسم SVM الجيومترية (GSVM). لتقييم أداء هذا النهج الجديد، مقارنة هذا الاقتراح الجديد مع أساليب التعلم الأخرى التي تراقب Witten et al. ( 2017 ( ) للتحديد التلقائي للجنس داخل النصوص السيرة الذاتية للمؤلفين الأدبيين المستخرجين من DATASET-TH-001. يتم تقييم ما إذا كان تجنب الخطوة المشتركة من التخفيف في صناعة النص، والتي تخلص من الصوفية الجنسية في الكلمات ذات الصلة لتحليل النص، وتحسين الأداء في تحديد الجنس. بالإضافة إلى ذلك ، يتم عرض فعالية نهج GSVM لتسريع مرحلة تدريب الخوارزميات ، ويظهر أن هذه الطريقة لا تؤثر بشكل كبير على أداء الإجراء.
5.2.1 معيار التوقف الهندسي
يمكن حساب هندسة وظيفة القرار SVM المرتبطة ببيانات التدريب داخل كل إيتراشن عن طريق قياس أو تقدير معدل الخطأ. وهذا هو، عندما يتم استقرار معدل الخطأ، وظيفة القرار تلبي متطلبات تصنيف البيانات بنجاح. صورة 5.1 يظهر مثالًا مع اثنين من سحابة غاسيا ثنائية الأبعاد. تنفيذ SVM حتى الإيترار 2 يخلق سطح الانفصال الذي تم تصويره في الشكل 5.1 أ، في حين أن الشكل 5.1 ب يظهر مساحة الانفصال التي تم حسابها حتى الإيترار 18. وظيفة القرار في الشكل 5.1 يقدم نفس الخطأ التجريبي الذي يرتكب وظيفة القرار في الشكل 5.1 ب، الذي كان يطلب المزيد من الإيترات، و
لذلك، المزيد من الوقت التدريب على بناء. بدلا من ذلك، بناء وظيفة القرار في الشكل 5.1 أ- كان من الضروري أن يكون هناك تدريبات أقل.
(أ) SVM run until iteration 2 (ب) SVM run until iteration 18
صورة 5.1: اثنين من مساحات الانفصال محسوبة باستخدام SVM: (أ) مساحة الانفصال التي تم الحصول عليها بعد 2 (ب) مساحة الانفصال التي تم حسابها بعد 18 إيتراكات.
استنادا إلى هذه الأساسيات، ونحن تعريف εk كسرعة الخطأ لمجموعة التدريب في إيترات k و τ > 0 إنها قيمة حقيقية تعمل كتحمل. وفقا لـ ( 2.3 ),
n x
إك = 1
n
I = 1 ( 1 −yi f(xi)) + ( 5.1 )
Sea δk = <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> 5 |. سيتم إيقاف الطريقة عند الانتهاء من ما يلي:
(δk ≤τ) ⁇ (δk− 5 ≤τ) ⁇ (δk− 15 ≤τ) ⁇ (♰M(βk) −m(βk)♰ ≤ 100 ε), ( 5.2 )
حيث يحدد الرمز " ⁇ " المشغل المنطقي "و" ، أي يجب أن يتم الوفاء بأربعة عدم المساواة داخل المعيار في وقت واحد. من خلال قياس عدم المساواة δk ≤τ كل خمسة إيتراations وتخفيف المعيار الكلاسيكي، يمكننا تجنب ذروة الخطأ غير المرغوب فيها الناجمة عن الحوادث. وتبين المفاهيم التالية أن هناك علاقة مباشرة بين معايير الاحتجاز ( 2.12 ) و ( 5.2 ).
النظرية 2. إلـى ⁇ 0 و إيه > 0, هناك عدد من الإيترار kτ,ε مثل δk ≤τ و m(βk) −M(βk) ≤ε, ∀k > kτ,ε.
إظهار. بواسطة كورولا 1.1 ويقولون أن:
⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇
m(βk) −M(βk) = 0
لذلك ، هناك عدد من الإيترار kε بحيث ∀k > kε يلتزم بأن:
m(βk) −M(βk) ≤ε
(الإيجابية هي الحل في المشكلة) 2.5 ) ، حيث xi مثل β ⁇ i > 0 هذه هي ما يسمى بـ "المترو" ومن المعروف أن وظيفة f ∗، التي تحدد مساحة القرار f ∗(x) = 0 يأخذ الشكل:
n x
الف ⁇ (x) =
I = 1 وَقَالَ الْمُؤْمِنُونَ: (وَاللَّهُ عَزِيزٌ عَلَيْهِ وَسَلَّمَ) 5.3 )
مع
ب ⁇ = − Pn i= 1 بـ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ
2 + Pn i = 1 بـ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ ــ
2,
حيث x+ و x− هي اثنين من الفئات الدعم في الفصول + 1 و - 1 ، على التوالي ، مثل مضاعفات لاغرانج المرتبطة بها β+ و β−تدعي أن 0 < β + < C و 0 < ب ـ < ج.
(يُنظر في المهمة التي يحددها القرار) 2.5 ) ، في الإيتران k:
n x
f k(x) =
I = 1 βk i yiK(xi، x) + bk.
من السهل أن نثبت أن ∀γ > 0 ، هناك عدد من الإيترار kγ مثل ∀k > kγ:
فـ (أ) 5.4 )
هذا بسبب النظرية 1 التي تضمن أن:
⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇ ⁇
وَلَمْ يَكُنْ لَهُ مِنَ الْمُؤْمِنِينَ ∀ν 0 ، هناك عدد من الإيترار kν بحيث ، ∀k > kν ، يلتزم بأن:
بـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ ـ
إذا كان صغيرًا جدًا ، ( 5.4 ) يتوافق مع kγ = kν. إلـى ⁇ 0 إذا كنت تريد أن تكون صغيرًا ( 5.4 ∀k > kγ ، مع الأخذ بعين الاعتبار التعريف ( 5.1 ) ، يوافق على أن:
δk = <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> <unk> < 5 | ≤τ,
وَالْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْتَقِيمُ الْمُسْت
□
وبما أن المعايير ( 5.2 ) يعتمد على معدل الخطأ ، فمن المستحيل تحديد قيمة ل τ. يمكننا أن نضعها على سبيل المثال في τ = 0,0005 لأن معدل الخطأ يصل إلى 0,05 % يمكن اعتبارها منخفضة بشكل كبير. هذا الفهم لا يوجد لمعيار ( 2.12 لأن مقياس g(β) لا يمكن تقديره مسبقاً. في القسم 5.3 ونحن نثبت أن، في حالة معينة من تحديد الجنس في النصوص، يمكننا العثور على مساحات القرار العامة المناسبة التي تلبي المعيار ( 5.2 (في أقل بكثير من المعايير المطلوبة لتلبية المعايير النظرية الشائعة المستخدمة) 2.12 ). النقطة الرئيسية هي البيئة ذات الأبعاد العالية التي يتم فيها تمثيل النص ، مما يسمح بالوصول إلى التعميم التجريبي الجيد بسرعة. وبالتالي ، من وجهة نظر تجريبية ، من المتوقع أن يرث GSVM خصائص توزيع SVM.
5.3 التجارب
في هذا القسم ، نصف بالتفصيل مشكلة تحديد الجنس وإعداد التجارب.
5.3.1 صياغة المشكلة
يتم طرح مشكلة التعرف على الجنس في البيانات النصية كمهام تصنيف التعلم المراقبة. وبما أن كتلة نصية يمكن وضع علامة على محتوياتها مع علامة جنسية مرتبطة بالشخص الموصوف في النص، يجب أن يلفت الخوارزميات هذه العلامة تلقائيا. في هذه الحالة، ونحن نعتبر اثنين من العلامات الخروج المحتملة، L = {"المرأة"، "الرجال"}، لأن مجموعنا من البيانات التجريبية يحتوي فقط على الحالات من هذين الطبقتين من الجنس، كما هو موضح في القسم الفرعي. 5.3.3. لذلك، نحن نحد من اختيارنا من الخوارزميات إلى تلك التي تركز على التصنيف الثنائي. يمكن أن يمتد هذا النهج إلى النظر في علامات الخروج الإضافية ، وإعادة تشكيل المشكلة كعمل تصنيف واحد ضد كل أو علامات متعددة.
وتختلف إطار عملنا عن النهج السابق في وجهتين:
الشرائح:
على الرغم من أن الأعمال السابقة تتبع إجراءات التعدين التقليدية، مثل الانحناء، ونحن تجنب عن قصد هذه الخطوة للحفاظ على صوفية الجنس في المصطلحات واستكشاف تأثيرها على تحديد الجنس للنصوص في اللغات مع تكرار قوي مثل الإسبانية.
بدلاً من وضع علامة على تسلسل من الكيانات ذات الاسم في نص، فإننا نتعامل مع مشكلة تخصيص علامة جنسية إلى كتلة نصية أو وثيقة كاملة تصف شخصاً ما. هذا مشكلة ذات صلة للعديد من التطبيقات، بما في ذلك تسجيل الدخول التلقائي في قواعد البيانات السيمانية.
هناك العديد من اللغات التي هي مرنة، مما يعني أن الكلمات يمكن أن تغير شكلها لتعكس المعلومات النحوية مثل العدد والوقت أو الجنس Hedlund et al. ( 2001 ). في اللغة الإسبانية ، فإن الكلمات التي تنتهي في أو أو في موازنة تعني الجنس الذكور ، بينما الكلمات التي تنتهي في "أ" هي في المقام الأول نسائية. يحاول اللاماتيز إزالة الاختلافات بين الأشكال المرنة للكلمة لتقليل كل كلمة إلى شكلها الجذر. وقد كان هذا المعالجة المسبقة النهج القياسي في تزويد النص واسترداد المعلومات لتحسين الدقة في تحديد المصطلحات الرئيسية في نص معين.
ومع ذلك ، كما ذكرنا سابقًا ، في اللغة الإسبانية ، يمكن أن يكون التفكير في العديد من الكلمات مؤشرًا عمليًا ومباشرًا للجنس. لهذا السبب ، يبدو من المنطقي أن نفترض أنه إذا لم نطبق التخفيف من الجنس ونحافظ بدلاً من ذلك على الخصائص الجنسية ، يمكننا تحسين دقة التعرف على الجنس. وتقدم الاستراتيجية التالية لتحديد الجنس من النصوص:
1. تطبيق إجراءات قياسية في تزويد النصوص لإعداد النص الإدخال لا يزال غير معالج، بما في ذلك توكين وإزالة الكلمات الفارغة (يتم توفير تفاصيل تنفيذ إضافية في القسم 5.3 ).
2. قبل إنشاء التمثيل البتور لكل وثيقة، وتشير الأساليب التقليدية لتعدين النصوص إلى إجراء بعض عملية تطبيع النص Sproat et al. ( 2001 ) ، مثل اللاماتيك ، لإزالة اللاماتيك المرنة ، وتوفير تمثيل نموذجي من الكلمات المماثلة والحد من حجم القاموس. على العكس من ذلك، فإننا نقترح إلغاء هذه الخطوة من المعيار النصي، مع الحفاظ على بدلا من ذلك الستائر المرنة التي تحتوي على معلومات إضافية عن الجنس في لغات محددة.
3. ثم نعود إلى العملية القياسية لإعداد الوثائق، وتوليد التمثيل المتعصب لكل وثيقة وبناء مادة المصطلح-الوثيقة (مرة أخرى، يتم تقديم المزيد من التفاصيل في القسم 5.3 ).
وتطبق هذه الاستراتيجية على إعداد البيانات النصية التي ستدرب خوارزميات التعلم الآلي لتحديد الجنس. لإثبات قابلية تطبيق هذه الإجراءات في بيئة حقيقية، لقد صممت سلسلة من التجارب التحقق، والتي يتم وصفها في القسم التالي.
5.3.2 إعداد التجارب
الهدف الرئيسي هو تقييم قدرة إطار عملنا المقترح لتحديد الجنس المرتبط بالوثائق النصية في العالم الحقيقي تلقائيًا. لهذا الغرض، نستعيد مقالات سيرة ذاتية تصف المؤلفين الأدبيين من الإصدارات الإنجليزية والإسبانية من DATASET-TH-001 وتشمل هذه البيانات أنظمة أخرى تعتمد على المعرفة السيمانية مثل: DATASET-TH-001. لذلك ، تم إنشاء مجموعتين مختلفتين من البيانات ، واحدة لكل لغة. لقد صممنا بناء مجموعات البيانات لدينا لضمان التمثيل المساوي للعلامات في الإدخالات السيرة الذاتية المختارة لمجرد تجاربنا باللغة الإنجليزية والإسبانية.
من خلال تنفيذ إجراءاتنا في النص الإدخال باللغة الإنجليزية والإسبانية، هدفنا هو تأكيد ما إذا كان تجنب الانحراف له تأثير إيجابي على أداء تصنيف التعرف على الجنس لدينا. تم تجميع مجموعات البيانات المختارة لدينا من السيرة الذاتية للرجال والنساء. هذا الاختيار يسمح لنا لتحديد التجربة كمشكلة تصنيف ثنائي حيث توجد عدة خوارزميات التعلم الآلي القياسي. الشكل 5.2 يظهر وصفًا عامًا للإجراء التجريبي لتقييم كل طريقة تعليمية تراقب.
يتم تقسيم كل مجموعة من البيانات السيرة الذاتية باللغة الإنجليزية والإسبانية إلى مجموعات تدريبية واختبارية. وبشكل خاص، فإن 70 % في كل لغة يتم استخدام السيرة الذاتية للتدريب، في حين أن 30 % يتم الحفاظ على الباقي كجمع من الاختبارات لتقييم أداء الخوارزميات التعلم المراقبة. يقدم القسم التالي تفاصيل إضافية حول استرداد وإعداد مجموعتين من البيانات.
5.3.3 مجموعات البيانات المستخدمة
بدأنا، استعادة السيرة الذاتية من المؤلفين الأدبيين DATASET-TH-001, تتبع موقع الويب الخاص بك مباشرة من خلال استخدام الحزمة DATASET-TH-001 كايس و تيل-
صورة 5.2: وصف الإطار المقترح لاختبار الأساليب البديلة للتعلم المراقبة.
SOFTWARE-TH-003 ( 2017 ) ، متوفرة للبيئة الإحصائية R ، ORG-TH-112 ( 2022 ). هذا الحزمة يمكن أن تحصل على قائمة من الصفحات، والفئات الفرعية، ومحتوى الصفحات وغيرها من المعلومات حول فئة معينة.
مجموعة البيانات المتاحة للجمهور باللغة الإنجليزية Gomez et al. ( 2021 أ ) 4 ويحتوي على 1000 السيرة الذاتية للكاتب المستخرج من DATASET-TH-001 في اللغة الإنجليزية. وتقسم هذه المقالات بشكل عادل إلى مجموعة من النساء ومجموعة من الرجال. وقد تم استخراج السيرة الذاتية للمرأة من فئة "النساء_النساء_من القرن التاسع عشر" ، بينما كانت أولى 500 صفحة من فئة “الرجال_الرجال_القرن التاسع عشر” تم الحصول عليها لبيغرافيا الرجال.
مجموعة البيانات المتاحة علنا في الإسبانية Gomez et al. ( 2021 ب )
5 ويحتوي على 832 السيرة الذاتية المستخرجة من DATASET-TH-001 في اللغة الإسبانية. وقد تم استخراج السيرة الذاتية للنساء من فئة "الكاتب في إسبانيا". على العكس من ذلك، فإن أول 416 صفحة في فئة “الكتب في إسبانيا في القرن العشرين” تم استردادها للكتاب السيرة الذاتية للرجال. وبالتالي، فإن هذه السيرة الذاتية تقسم أيضا إلى اثنين من المجموعات الفرعية، واحدة من النساء والآخر من الرجال.
الجدول 5.1 يلخص بعض الإحصاءات العامة من تحليل استكشاري مسبق لمجموعات البيانات باللغة الإنجليزية والإسبانية الموصوفة أعلاه.
نحن معالجة مسبقا كل سيرة باستخدام حزمة R من التعدين النص tm Feinerer et al. ( 2008 ). إزالة الكلمات الفارغة من السيرة الذاتية (الكلمات الشائعة التي عادة لا توفر معلومات مفيدة للتحليل)
4 [LINK-REDACTED] 5 [LINK-REDACTED]
جدول 5.1: العدد الإجمالي والمتوسط الذي يصف مجموعات البيانات باللغة الإنجليزية والإسبانية.
Dataset Descriptive Statistics قيمة
Total number of biographies of نساء المؤلفين 500 Avg. number of distinct terms per female writer biography 50,86
Avg. number of distinct terms per female writer biography (stemming) 38,11
الإنجليزية
Total number of biographies of male المؤلفين 500 Avg. number of distinct terms per biography of male writer (عدد المصطلحات المميزة لكل كتاب) 46,2
Avg. number of distinct terms per male writer biography (صوت) 35,62
Total number of biographies of نساء المؤلفين 416 Avg. number of distinct terms per female writer biography 50,03
Avg. number of distinct terms per female writer biography (stemming) 31,44
الإسبانية
Total number of biographies of male المؤلفين 416 Avg. number of distinct terms per male writer biography 51,39
Avg. number of distinct terms per male writer biography (صوت) 32,68
تين ( 2019 ) ، الأرقام ، علامات النتيجة والمساحات البيضاء. في وقت لاحق ، يتحول نص كل سيرة إلى صغيرة ويخلق المصفوفة المناسبة ، كما هو موضح في الجدول 5.2. وبالتالي، يمكن تمثيل كل مجموعة سيرة الذات كمسلسل m × n، حيث m هو عدد المصطلحات الفريدة في القاموس و n هو عدد السيرة الذاتية في مجموعة التدريب. كل عنصر في المصفوفة المقصود بالمعنى الحي يمثل أهمية أو وزن المعنى الحي في المصفوفة المقصود بالمعنى الحي. (لإستخدام قيمة الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من الـ (W) من 2003 ) ، محسوبة على أنها ( 5.5 ):
!, ( 5.5 )
وَلَا تَعْلَمُوا أَنَّ اللَّهَ يَعْلَمُ مَا تَعْمَلُونَ
د ف
حيث t fi j يحدد عدد الأحداث في المصطلح i في السيرة الذاتية j؛ n هو العدد الإجمالي للكتابة في مجموعة التدريب؛ وأخيرا، d fi هو العدد من الكتابة التي يظهر فيها المصطلح i.
ويجب الإشارة إلى أن مجرد السيرة الذاتية التدريبية تساهم في بناء قاموس المصطلحات التي تمثل جميع السيرة الذاتية. أي عندما يختبر التصنيف السيرة الذاتية الجديدة على المجموعة الفرعية ، فإن
جدول 5.2: نموذج من المصفوفة المصطلح السيرة الذاتية، حيث wi j يمثل أهمية المصطلح i في الإدخال السيرة الذاتية j.
قاموس السيرة الذاتية 1 Biography 2... Biography ن
University w11 w12... w1n Marriage w21 w22... w2n Novel w31 w32... w3n...................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................................... Writer wm1 wm2... wmn
ترغب في مصطلح غير موجود في السيرة الذاتية من مجموعة التدريب لا يعرف لحساب المسافة. كما أن دراستنا لم تعتبر أي من المفردات أو الاختصارات أو الأشكال البديلة للمصطلح المحدد.
5.3.4 النتائج
في هذا القسم يتم تقديم نتائج التجارب التي تقارن استراتيجيات مختلفة لتحديد الجنس في النصوص. وتشمل التجارب لكل خوارزمية تصنيف عشرة تجارب من أقسام اختبار التدريب المختارة عشوائيا.من أجل دعم النتائج، تم إجراء اختبارات الافتراضات الإحصائية لـ Wilcoxon Hollander et al. ( 2013 ( ) ، مع الأخذ في الاعتبار الأهمية الإحصائية لقيم p أقل من 0, 05.
GSVM مقابل SVM القياسية
وتلخص القسمات التالية نتائج التجارب التي تقارن GSVM مع SVM القياسية في مشكلة تحديد الجنس في النص.
مقارنة عدد الإيترات: GSVM مقابل SVM القياسية
لوحة 5.3 مقارنة حساب الإيترات لـ GSVM و SVM النموذجي باستخدام معيار التوقف الكلاسيكي. من الواضح أن متوسط مجموعة البيانات الإسبانية، GSVM يقترب من 18 % (مع المشتقات) و 25 % (بدون مشتقات) أقل إيترات من النهج SVM القياسي. بدوره ، بالنسبة لمجموعة البيانات المتاحة باللغة الإنجليزية ، يسمح GSVM بتقليل عدد الإيترات إلى حوالي 42 % (مع المشتقات) و 44 % (بالتأكيد لا يوجد أي مشتقات) وتشير القيم الكبيرة في الانحراف القياسي لـ GSVM إلى أن كلا النهجين يصل إلى الحد الأقصى المحدد لعدد الإيترات لبعض التجارب، ويعرف باسم عدد الإيترات من النهج القياسي SVM.
ويظهر اختبار ويلكوسون على مجموعة البيانات المتاحة باللغة الإنجليزية أن تحسين GSVM على SVM مهم إحصائيًا ، سواء عند تطبيقها على...
قيمة (قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة P = قيمة 0,00195 كما هو الحال عندما لا يتم تطبيقها (قيمة p = 0,00589 ). إذا نظرنا إلى حالة السيرة الذاتية باللغة الإسبانية ، فإن التحسينات ذات أهمية إحصائية عندما لا يتم تضمين استيقاظ (قيمة p = 0,00195 ولكنها ليست ذات أهمية عند الاستخدام (قيمة p = 0,1 ).
جدول 5.3: متوسط (prom.) و انحراف قياسي (أي) من حساب الإيترات في مراحل التدريب.
اللغة الطريقة التصويت لا التصويت
ألفاً: p-value avg. s.d. p-value
إسبانيا SVM 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
اللغة الإنجليزية SVM 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
الشخصيات 5.3 أ ـ 5.3 ب ـ 5.4 أ و 5.4 (ب) يظهرون رسميا، لكل تجربة، في أي عدد من إيتراations GSVM و SVM القياسية توقف تنفيذ التدريب، على التوالي. يحدد معيار إيقاف GSVM اللحظة التي يتأكد فيها مؤشر معدل الخطأ (خط النقاط) دائمًا. على العكس من ذلك ، يتطلب معيار التوقف SVM الكلاسيكي عددًا أكبر من الإيترارات للتوقف دون توفير أي تحسين في معدل الخطأ.
يجب أن يلاحظ أن أداء معيار توقف GSVM للكتاب السيرة الذاتية باللغة الإنجليزية هو مماثل، بغض النظر عما إذا كان يتم تطبيق أو لا معالجة المسبقة للاميت (انظر الأرقام) 5.3 ب و 5.4 ب ) اكتشاف آخر ملحوظ هو أن معدل الخطأ للكتاب السيرة الذاتية في اللغة الإسبانية (انظر الأرقام) 5.3 أ و 5.4 (أ) يظهر نموذج متقلب عند تطبيق معالجة الدليل المسبق (الشكل) 5.4 أ ) قد يكون هذا السلوك بسبب فقدان كبير للمعلومات التي أدخلتها عملية التحويل في هذا اللغة.
وأخيرًا، يجب أن نذكر أن قياسات التقييم متشابهة جدًا، في جميع الحالات، بالنسبة لعلامات الخروج "المرأة" و "الرجال" في كلا اللغتين.
مقارنة دقة GSVM مقابل. SVM القياسية
مع الهدف من تقييم أداء تقنية SVM القياسية مع GSVM نلاحظ قياسات الدقة والرصد والنتيجة F1 بايزا-ياتيس و ريبيرو-نيتو ( 2011 ); سليمان و لاباليم ( 2009 ); ألان و ديلين ( 2008 ). لوحة 5.4 يظهر مقارنة بين SVM و GSVM للكتاب السيرة الذاتية باللغة الإنجليزية، مع أو بدون تأثير. لكل طريقة ومتري ، يظهر هذا الجدول المتوسط (avg.) والانحراف القياسي (s.d.). بالإضافة إلى ذلك ، يتم عرض قيمة p من اختبار Wilcoxon لكل مقارنة. وتشير نتائج اختبار ويلكوسون إلى أنه لا توجد اختلافات إحصائية ذات أهمية بالنسبة لأي من المعلمات التي تم النظر فيها، كما هو موضح في عمود القيمة p، حيث كل القيم أعلى من 0,05.
(أ) اللغة الإسبانية
ب) اللغة الإنجليزية
صورة 5.3 لا يوجد دافعة. مقارنة معايير الاحتجاز في حالة عدم استخدام المعالجة المسبقة للانحناء.
النتائج التي يتم عرضها في الجدول 5.4 و و 5.5 يظهرون إمبريكياً أن مشاكل التعرف على الجنس في النص، توروث تقنيات GSVM نفس الخصائص التي توروثها SVM، مما يوفر نتائج دقيقة مماثلة.
لوحة 5.5 يظهر مقارنة بين SVM و GSVM للكتاب السيرة الذاتية باللغة الإسبانية، مع و بدون تأثير. مرة أخرى ، لكل طريقة ومتريك ، يظهر هذا الجدول المتوسط (avg) ، والانحراف القياسي (s.d.) ، والقيم p المقابلة في اختبار Wilcoxon. وبشكل مماثل للكتاب السيرة الذاتية باللغة الإنجليزية، تشير نتائج اختبار ويلكوسون إلى أنه لا توجد اختلافات إحصائية ذات أهمية بالنسبة لأي من المقاييس (القيم p هي أعلى من 0.05 ). كما نتيجة-
(أ) اللغة الإسبانية
ب) اللغة الإنجليزية
صورة 5.4: مقارنة معايير الاحتجاز عند تطبيق المعالجة المسبقة للتحويل.
جدول 5.4: الإنجليزية. معدل الأداء SVM و GSVM للكتابة السيرة الذاتية في التصنيف الإنجليزي، مع و بدون التعديل.
صوت. طريقة الجنس Precision Recall F1 Score
ألفا (س) p-value avg. (س) p-value avg. (س) p-value
لا إم إم 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
صم SVM 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Yes Female SVM 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
صم SVM 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
(ج) انخفاض عدد الإيترات التي تحققها GSVM لا يؤثر على دقة
وتصنيفها.
جدول 5.5 • الإسبانية. معدل الأداء SVM و GSVM للبيغرافيا في التصنيف الإسباني، مع و بدون تأثير.
صوت. طريقة الجنس Precision Recall F1 Score
ألفا (س) p-value avg. (س) p-value avg. (س) p-value
لا إم إم 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
صم SVM 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Yes Female SVM 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
صم SVM 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
لوحة 5.6 يظهر لـ GSVM مقارنة بين التحويل وعدم التحويل، جنبا إلى جنب مع قيم p المقابلة. بالنسبة للكتاب السيرة الذاتية في اللغة الإسبانية ، تظهر النتائج انخفاضًا كبيرًا عند تضمين الانحراف ، مع قيم p 0, 0097, 0, 00586 و و 0, 00195, للتوضيح والتركيز والنتيجة F1 ، على التوالي ، في الجنس الإناث ؛ و قيم p 0, 0137, 0, 00195 و و 0, 00195 ، للتوضيح والتركيز والنتيجة F1 ، على التوالي ، في الجنس الذكور. في المقابل، بالنسبة للكتاب السيرة الذاتية باللغة الإنجليزية، تتجاوز قيم p لكل مقياس مستوى معنى 0,05 ، مما يشير إلى عدم وجود تأثير كبير.
جدول 5.6: مقارنة معدل الأداء من الانحراف مقابل عدم الانحراف عند تطبيق طريقة GSVM.
اللغة الجنس Stem Precision Recall F1 score
p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p-value p
الإسبانية المرأة لا 0,909 0,0097 0,907 0,00586 0,903 0,00195 نعم 0,770 0,781 0,747
ماري لا 0,889 0,0137 0,913 0,00195 0,891 0,00195 نعم 0,724 0,790 0,713
الإنجليزية لا 0,908 0,343 0,859 0,124 0,879 1 نعم 0,880 0,898 0,888
ماري لا 0,823 0,108 0,909 0,286 0,843 0,636 نعم 0,899 0,884 0,891
GSVM مقابل الخوارزميات الأخرى
في هذا الفرع مقارنة الأداء والوقت التدريبية من طريقة GSVM مع أساليب التعلم الآلي الأخرى، مثل، Random Forests (RF) Breiman ( 2001 ) و Boosting Schapire ( 1990 ) ، من مكتبات البرمجيات المستخدمة بشكل عام. في هذه الاختبارات ، يتم تثبيت المعلمات العظمى للخوارزميات في قيمها المحددة مسبقا. بالنسبة لكل خوارزمية ولغة، نقوم بمقارنة اثنين من تدفقات عمل التعدين النصية البديلة لكل مقياس: (أ) تشمل خطوة الانحراف، كما هو الحال في معظم تطبيقات التعدين النصية التقليدية؛ و (ب) تجنب الانحراف، والحفاظ على الخصائص التي توفر معلومات جنسية إضافية في بعض اللغات. يستخدم الوقت كمتريك
مقارنة، حيث لا يوجد إمكانية للمقارنة بشكل عادل بين حسابات الإيتررات، حيث أن تنفيذ كل طريقة يتبع نهج إيتررات مختلف.
مقارنة وقت التدريب: GSVM مقابل الخوارزميات الأخرى
لوحة 5.7 يلخص وقت التشغيل (في ثوان) لجميع إصدارات الخوارزميات المستخدمة في هذا البحث. باستخدام التدوير للغة الإسبانية، GSVM هو، في المتوسط، حتى 10,05 أسرع من طريقة Boosting 42,87 في بعض الأحيان أسرع من RF ، بينما ، بالنسبة للغة الإنجليزية ، GSVM هو ، في المتوسط ، حتى 15,79 أسرع من بوتين 59,15 أسرع من RF. عندما لا تنطبق الانحراف، بالنسبة للغة الإسبانية، GSVM هو، في المتوسط، حتى 49,63 أسرع من بوتين 81,00 أسرع من RF. أما بالنسبة للإنجليزية، فإن GSVM هو، في المتوسط، حتى 22,91 أسرع من بوتين 77,70 أسرع من RF. خلاصة القول ، استنادًا إلى اختبار Wilcoxon الذي أجري ، تشير عمود القيمة p إلى اختلاف كبير إحصائيًا بين الأساليب ، مما يدل على أن وقت تدريب GSVM أقل بشكل متسق من الأساليب الأخرى.
جدول 5.7: متوسط (avg.) و انحراف قياسي (s.d.) من وقت التدريب.
اللغة الطريقة التصويت لا التصويت
ألفا (س) p-value ألفا (س) p-value
إسبانيا GSVM 3,096 ( 0,460 ) 2,889 ( 0,150 • Boosting 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
اللغة الإنجليزية GSVM 3,799 ( 0,074 ) 3,883 ( 0,525 • Boosting 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
مقارنة دقيقة: GSVM مقابل الخوارزميات الأخرى
وبما أن التحويل لا يبدو له أهمية عند معالجة السيرة الذاتية باللغة الإنجليزية، فإننا سنركز بقية تحليلاتنا على السيرة الذاتية باللغة الإنجليزية. لوحة 5.8 يظهر مقارنة من الانحراف مقابل غير الانحراف، والقيم p المقابلة، لـ GSVM، Boosting و Random Forest. GSVM يحصل على نتائج واعدة للغاية، وخاصة عندما لا تستخدم الانحراف، مع دقة، والعودة، والنتيجة F1 فوق 90 % في معظم الحالات ، على الرغم من أن Boosting و Random Forest تحسن بشكل رئيسي نتائج GSVM. ووجدت أن كلا التقنيات تنتمي إلى المعروفة باسم أساليب المجموعة (ساجي و روكاش، 2018 ). من خلال تدريب العديد من النماذج وتكامل توقعاتهم ، تحسن هذه الأساليب الأداء التنبؤي لنموذج واحد. ومن الجدير بالذكر أنه نظرًا لأن GSVM يتصرف كمعيار SVM بدقة ، فإن هذه النتائج تظهر أهمية الانحراف مقابل عدم الانحراف في لغات مثل الإسبانية. هذه التقنية المسبقة أيضا
يؤثر على النتائج التي سيتم الحصول عليها باستخدام أنواع أخرى من التصنيفات.
بالإضافة إلى قيمة P في الجدول 5.8 يظهر انخفاض كبير في أداء جميع الخوارزميات عند تطبيق الانحراف. وتظهر هذه النتائج بشكل متسق أن اللغة الإسبانية، دون انحراف، دقة، واستعادة، ونتيجة F1 هي أعلى من 90 % في معظم الحالات ، بينما عند استخدام الانحراف يحدث تدفق من 15 %.
جدول 5.8: معدل دقة للطرق حول السيرة الذاتية باللغة الإسبانية.
طريقة الجنس Stem Precision Recall F1 Score
ألفا (س) p-value avg. (س) p-value avg. (س) p-value
GSVM المرأة لا 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 نعم 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
ماري لا 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 نعم 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
الخصم لا المرأة 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 نعم 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
ماري لا 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 نعم 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF المرأة لا 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 نعم 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
ماري لا 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 نعم 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 الاستنتاجات
في هذا القسم، ندرس بعض التوضيحات للاختلافات التي تم اكتشافها في أداء التعرف على الجنس، وهذه تفكر في القيود المحتملة في عملنا.
5.4.1 مقارنة خوارزميات التصنيف
وتشير النتائج إلى أن التحكم في تطبيق Stemming في إعداد البيانات النصية، ومقياسات الأداء هي مماثلة إلى حد ما، بغض النظر عن خوارزميات التعلم الآلي المختارة للتصنيف. ومع ذلك ، هناك اختلافات اعتمادًا على اللغة المستخدمة.
ونتيجة لذلك، يمكننا أن نستنتج أن خوارزميات تصنيف التعلم الآلي لتحديد الجنس يمكن أن تتأثر مباشرة من قبل الأقواس الموجودة في مجموعات البيانات المستخدمة لتدريب الخوارزميات. وتؤكد نتائجنا أن معالجة Stemming المسبقة، وهي طريقة تسهل على ما يبدو مشكلة التصنيف، يمكن أن تؤدي إلى الارتباك بين الجنسين لحل المشكلة.
5.4.2 أثر إزالة الاشتقاق الجذعي
أحد الأهداف الرئيسية للخطة المقترحة هو استكشاف ما إذا كان الاحتفاظ بالعنصر المورفولوجي الذي يحتوي على معلومات الجنس في بعض اللغات، مثل الإسبانية، يمكن أن توفر أداء تصنيف أعلى لتحديد الجنس في النص. وفقا للنتائج التي تم تقديمها في الجدول 5.6 و و 5.8 هناك زيادة ملحوظة إلى حد ما في أداء التصنيف الإسباني للخوارزميات التي تم النظر فيها في تجاربنا عندما يتم إزالة خطوة التحويل من عملية إعداد البيانات.
على العكس من ذلك ، فإن النتائج للغة الإنجليزية تشير إلى انخفاض صغير في معدل النتيجة F1 بين تطبيق Stemming أو لا في عملية إعداد البيانات لأي خوارزمية تصنيف. هذه اللغة لديها نتائج مماثلة فيما يتعلق بالدقة ومتطلبات أداء الرد.
على نطاق واسع، هذه النتائج تدعم اعتبارنا الأولية أن تجنب تطبيق Stemming يمكن أن تؤثر بشكل إيجابي على تحديد الجنس في النصوص عندما يكون المحتوى متاحا في اللغات التي توفر تفاصيل مُفلسية إضافية التي تجلب معلومات الجنس، مثل الإسبانية. تأكيد المعرفة التي تم الحصول عليها في البحوث السابقة حول أهمية مرحلة إعداد البيانات، وخاصة إذا كان العمل مع لغات مختلفة عن اللغة الإنجليزية Uysal و Gunal ( 2014 ).
5.4.3 القيود
الطريقة الجديدة GSVM التي تدخل معيار التوقف المبكر لمرحلة التدريب يعمل بشكل جيد لمشكلة تحديد الجنس النصية المحددة. لذلك ، يجب إجراء تجارب إضافية لتقييم أداء GSVM في مهام التصنيف الأخرى قبل أن يوصي GSVM باعتبارها ابتكارًا منهجيًا عامًا لـ SVM في التعلم الآلي.
فيما يتعلق بالخطة المقترحة لتحديد الجنس النص، والحد الأهم من بيئتنا التجريبية هو أننا نقوم بتحويل المتغيرات الجنسية المستهدفة إلى خيار ثنائي. مشكلة طرحتها المؤلفون الآخرون Hamidi et al. ( 2018 ); كايس ( 2018 ). في الواقع، وجدت أن 55 من 58 دراسات التعرف على الجنس التلقائي مع التعلم التلقائي اتخذت خروج الجنس الثنائي. في هذا الصدد، يمكن أن يكون مسارًا محتملًا للبحث المستقبلي هو استبدال خوارزميات التصنيف الثنائي لدينا بديلاً مثل أنماط التعلم الآلي التي تسمح بأهداف مستمرة و/أو متعددة الاختلافات. في مثل هذه السياقات ، سيكون من المثير للاهتمام تقييم ما إذا كانت الخصائص الجنسية لا تزال توفر بعض المزايا لتحديد الجنس.
وهناك تقييد آخر لنهجنا هو أن النص الوارد قد لا يكون متاحًا في لغة متقلبة للغاية ، مختلفة عن اللغة الإنجليزية. ومع ذلك، في هذه الحالة، يمكن أن يتم ترجمة النص تلقائيا من الإنجليزية إلى الإسبانية أو لغات أخرى ذات خصائص مماثلة من خلال الخدمات الآلية. هذه النسخة المترجمة من نص الإدخال يمكن أن توفر معلومات جنس إضافية التي تسمح لتحسين أداء التصنيف. وبالمثل، فإن المزيد من الأبحاث مطلوبة لتأكيد أن هذه النتائج الأولية التي تقارن الإنجليزية والإسبانية قابلة للتكرار مع إدخال البيانات في اللغات البديلة.
5.4.4 الابتكار
في هذا البحث، قدمنا معيار جديد للالتزام لأحرف التحسينات الدعم الفكتيرية القائمة على الخصائص الجغرافية التمثيل الفكتوري للمحتوى النصي بهدف حل مشكلة تحديد الجنس الآلي. لهذا المشكلة على وجه التحديد، ونحن نظهر أن الخوارزميات المقترحة تتطلب أقل من الوقت للتدريب إذا قارنتها مع تطبيق الخوارزميات SVM القياسية. وفيما يتعلق بالخطة، بدلاً من اتباع إجراءات المعيار التقليدية في صناعة النص التي تخلص من الخصائص الجنسية، مثل التحويل، نحافظ على تلك العناصر المورفولوجية الموجودة في اللغات المضغوطة بشدة من أجل تحسين أداء أساليب التعرف على الجنس. ونحن نقيس فعالية هذا النهج الجديد فيما يتعلق بفترات التدريب من خلال مقارنة الخوارزميات المختلفة للتعلم الآلي للتصنيف، باستخدام مجموعة من البيانات من الإدخالات السيرة الذاتية DATASET-TH-001 باللغة الإنجليزية والإسبانية.
وتشير نتائجنا إلى أن تجنب الانحراف (stemming) في النص المسبق لللغات التي تشمل عناصر إضافية تضم معلومات الجنس، مثل الإسبانية، هو إيجابي. هذا التغيير في الإجراءات لا يؤثر على لغات محايدة أخرى مثل الإنجليزية.