La disponibilità di grandi e ricchi set di dati testuali, creati principalmente da contenuti web sono stati un fattore importante nell'estrazione dei dati con algoritmi o metodi di autolearning a prezzi senza precedenti. Questo ha generato un alto interesse per la ricerca di apprendimento automatico per l'analisi del testo Aggarwal ( 2018 ). Oggi, estrazione del testo Srivastava e Sahami ( 2009 ) e la lavorazione del linguaggio naturale (PLN) Eisenstein 2019 ) costituiscono la base per molti di questi studi e realizzazioni.
5.1 Introduzione
DATASET-TH-001 Vrandeňci e Krötzsch ( 2014 ) è un esempio di una fonte di dati strutturata e di accesso libero che si basa sulle informazioni estratte da DATASET-TH-001 in più lingue. Le informazioni ottenute dagli articoli DATASET-TH-001 sono stati sottoposti a un processo di notazione semantica per estendere la base di conoscenza di DATASET-TH-001 seguendo un modello di dati strutturato grafico per integrare nuove applicazioni.
Uno di questi settori è l'identificazione del genere nel testo. L'obiettivo è quello di assegnare un'etichetta di genere (ad esempio, "femminile e maschio) in un'area di testo utilizzando proprietà linguistiche o altre caratteristiche descrittive. In generale, la ricerca precedente si è concentrata sull'identificazione del genere e del profilo di una persona che scrive il suo testo. Alcuni esempi includono l'identificazione di genere degli autori di Yan e Y blogs ( 2006 ) e microblogging
Mukherjee e Bala ( 2017 ) o agli utenti dei sistemi di gestione delle relazioni con i clienti (CRM) Amado et al. 2018 ).
La creazione di nuovi input da DATASET-TH-001 e dati strutturati negli articoli di DATASET-TH-001 per completare ogni argomento. Per esempio, se dobbiamo recuperare i dati strutturati su "Gabriel García Márquez e sono stati DATASET-TH-001 la voce corrispondente 2. Poi possiamo esplorare diversi campi con caratteristiche descrittive di questa persona, tra cui "sex o genere. 3. In questo esempio, il valore di quella proprietà è "maschio. Al momento della scrittura di questo articolo, come le informazioni precise possono essere 6 riferimento a diversi articoli di DATASET-TH-001 che sostengono la devoluzione di "male.a
questo campo utilizzando i dati strutturati. Tuttavia, come progetto aperto per la creazione collaborativa di conoscenza DATASET-TH-001 hanno spesso sofferto vandalismo e attacchi con Adler et al. ( 2011 ); Geiger e Ribes ( 2010 ). Se gli agenti dannosi hanno alterato i dati strutturati originali da DATASET-TH-001, rilevare gli errori senza un controllo manuale sarebbe un compito complesso e più così data la grande dimensione del suo database DATASET-TH-001. Inoltre, se non ci sono informazioni strutturate sul genere in un articolo di DATASET-TH-001, sarebbe impossibile assegnare un valore direttamente alla "properità di sesso o di sesso per la sua entrata in DATASET-TH-001 Tali informazioni sono sottoposte alla Commissione nella sua prima riunione. Invece, per etichettare le informazioni di genere come un'analisi automatica dei dati testuali che sono stati non strutturati nel corpo da DATASET-TH-001 Potrebbe migliorare la resilienza a queste sfide. Questo esempio può essere facilmente estrapolato a qualsiasi altro sistema informativo che dovrebbe etichettare automaticamente il contenuto di un blocco di testo con un tag di genere.
Ci siamo concentrati su un caso specifico, il problema di determinare automaticamente il suo genere come descritto nel testo biografico. Per il resto di questo lavoro, discuteremo quel problema come identificazione di genere. La mancanza di studi che includono lingue diverse dall'inglese rende difficile sviluppare nuove procedure di estrazione del testo in modo migliore per affrontare questo problema. Invece di puntare esclusivamente sull'inglese, con meno elementi di genere abbiamo cercato di usare il testo spagnolo per catturare morfemi che trasportano informazioni sul genere e sono più comuni in questa lingua. Per raggiungere questo obiettivo, eviteremo misure di normalizzazione nel settore minerario dei testi tradizionali come i derivati e la lematizzazione di Eisenstein ( 2019 ), come escludono le informazioni di genere in termini linguistici. A seguito di questo approccio, abbiamo dimostrato che un valore di genere può essere assegnato a contenuti testuali con maggiore precisione.
Quando si elabora il testo utilizzando tecnologie di apprendimento automatico, di solito è utile.
2 [LINK-REDACTED] 3 [LINK-REDACTED]
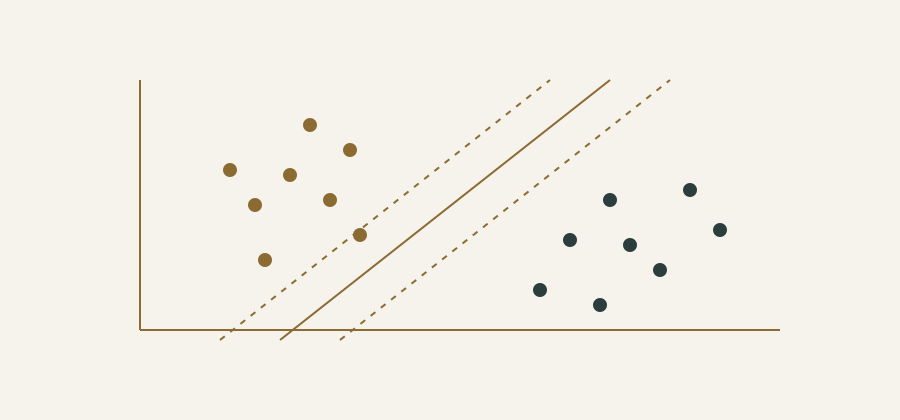
Per condurre prestazioni vettoriali con alta dimensione e dispersione in quanto contengono numerosi componenti di valore zero. In un ambiente di dispersione di rappresentazioni ad alta dimensione, MOguerza et al. (SVM) 2006 ) sono computativamente adatti Jocachims ( 2002 ). Tuttavia, l'adattamento delle tecnologie tradizionali di risoluzione dei problemi di ottimizzazione per SVM Joachims ( 1999 ) applicato all'identificazione del genere non garantisce una rapida convergenza in quanto l'iterazione si avvicina ad una soluzione ottimale del suo problema di ottimizzazione sottostante.
5.2 Proposta della Commissione
In questa sezione, nell'ambito del framework SVM utilizziamo proprietà geometriche da un compito di identificazione del genere di testo per modificare il criterio di arresto dell'algoritmo di ottimizzazione sottostante sostituendo Karush- Kuhn-Tucker Feng e Li ( 2018 ) da una nuova proposta, che incorpora le informazioni (il tasso di errore] che non è direttamente collegato matematicamente con un criterio che l'algoritmo SVM di ottimizzazione classica cerca di soddisfare in quanto può potenzialmente adattare la sua natura e problema geometrico risolvere. Per valutare l'esecuzione di questo nuovo approccio, queste proposte sono confrontate con altri metodi di Wittan e al monitoraggio ( 2017 ) per l'identificazione automatizzata del genere all'interno di testi biografici di autori letterari estratti da DATASET-TH-001. Sarà valutato se evitare il passaggio comune di lematizzazione nell'estrazione del testo, che rimuove i sufissi di genere con parole importanti per l'analisi del testo e migliora le prestazioni sulla identificazione di genere. L'efficacia dell'approccio GSVM per accelerare la fase di formazione di un algoritmo è anche dimostrata e mostra che questo metodo non influisce significativamente sulle prestazioni della procedura.
5.2.1 Criterio di arresto geometrico
La geometria della funzione di decisione SVM collegata ai dati di formazione è quantificabile all'interno di ogni iterazione misurando o stimando il tasso di errore. Cioè, quando questo tasso di errore stabilizza la funzione decisionale soddisfa tali criteri per classificare efficacemente i dati. La figura 5.1 mostra un esempio con due nubi gaussia multidimensionali. L'esecuzione di un SVM fino all'iterazione 2 produzione della superficie di separazione rappresentata in figura 5.1 un po 'di figura 5.1 b mostra l'area di separazione calcolata fino all'iterazione 18. La funzione di decisione della figura 5.1 a fornisce lo stesso errore empirico della funzione di decisione della figura 5.1 b, che richiedeva più iterazioni e
Così, più tempo di formazione per la sua costruzione. Invece, la costruzione della funzione decisionale in figura 5.1 a Ha avuto bisogno di meno formazione iterazioni.
(a) SVM correre fino all'iterazione 2 (b) SVM correre fino all'iterazione 18
Figura 5.1 Due superfici di separazione con SVM: (a) superficie di sdoganamento ottenuta dopo 2 b) area di separazione calcolata dopo 18 iterazioni.
Sulla base di queste basi, definiamo εk come il tasso di errore per la formazione impostato su iteration K e ∞ > 0 come un vero valore che agisce con tolleranza. Secondo ( 2.3 ),
N. X
εk = 1
g
I = 1 ( 1 − yi f (xi) e 5.1 )
Mare δk = ∞ 124 εks − httg ~ 5 |. Il metodo deve essere interrotto dopo aver rispettato quanto segue:
(δk ≤ ∞) 5 - Si'. 15 (g)} 100 ε), ( 5.2 )
dove il simbolo ") "denota un operatore logico e, vale a dire con tutte e quattro le disuguaglianze all'interno del suo criterio deve essere soddisfatto simultaneamente. Misurando la differenza δk ≤ ∞ ogni cinque iterazioni e rilassando un criterio classico, possiamo evitare picchi indesiderati di errore causati da casualità. Il seguente teorema mostra che esiste un collegamento diretto tra i criteri di detenzione ( 2.12 ) e 5.2 ).
Teorema 2. Dada ∞ 0 e ∞ > 0 ), c'è un certo numero di iterazione ků e β come δk ≤ ∞ y m (βg.
Prova. A Corollarus 1.1, si sostiene che:
L ′′ ım k →
m (βk) − M [β ks] = 0
Così, c'è un certo numero di iterazione kΩ tale che vale a dire k > KOR sono incontrati:
m (β k) − M e g.
Si tratta di una soluzione problematica vettoriale ( β) 2.5 ), dove xi quali β χ > 0 sono così chiamati vettori di supporto. È ben noto che la funzione f χ, che determina la superficie di decisione g {(x) = 0 Prendere il modulo:
N. X
(x) =
I = 1 β χ i yiK (xi, x) + b * 5.3 )
con
b χ = − pn i) 1 β χ IK (xi, x +)
2 + pn = 1 β χ IK (xi, x −)
2,
dove x + e x− sono due vettori di supporto in classi più 1 e 1 come il loro associato β + e ′ − moltiplicatore di Ligrange sono stati 0 < β + {C} e 0 < β > C
Consideriamo la funzione decisionale determinata da questo problema ( 2.5 ), a iterazione k:
N. X
f k (x) =
I = 1 β k i yiK (xi, x) + bg.
E 'facile dimostrare che, ′′ γ > 0, c'è un numero di iterazione kloe come.k > qy:
g k (x) − f χ 5.4 )
E' a causa del teorema. 1 Ciò significa che:
L ′′ ım k → ∞ β g = ß χ
e così 0 C'è un certo numero di iterazione kν tale che, vale a dire k > q.n. si è convenuto che:
β k − α ′ ≤ /.
Se prendiamo e quanto piccolo, ( 5.4 ) si incontra per kγ = k. Dada ∞ 0, se abbiamo e sono abbastanza piccoli da ( 5.4 ), e k > kγ con la definizione ( 5.1 ), è soddisfatto che:
(Sottovoce) 192,240 )} 5 | ≤τ,
e il teorema è valido per kΩ, β = m ′′ ax {g-q.a.).
□
Dal criterio ( 5.2 ) si basa sulla velocità di errore, è intuitivo impostare un valore per ∞. Possiamo metterlo, per esempio con a) = 0,0005 come una velocità di errore fino a 0,05 % può essere considerato come significativamente basso. Questa intuizione non esiste per il criterio ( 2.12 ) perché la grandezza di g (β) non può essere stimata in anticipo. Sezione 5.3 Abbiamo dimostrato che per il particolare caso di identificazione di genere nei testi, si può trovare e soddisfare un'area di decisione generale appropriata ( 5.2 ) in termini significativamente inferiori a quelli richiesti per soddisfare il criterio teorico ampiamente utilizzato ( 2.12 ). Il punto chiave è l'ambiente ad alta dimensione in cui è stato rappresentato il testo, consentendo una buona generalizzazione empirica da raggiungere rapidamente. Così, da un punto di vista empirico GSVM si prevede di ereditare le proprietà di generalizzazione per LVM..
5.3 Esperimenti
In questa sezione, descriviamo in dettaglio il problema dell'identificazione di genere e come vengono istituiti gli esperimenti.
5.3.1 Il problema
Il problema dell'identificazione del genere nei dati testuali come sfide di monitoraggio della classificazione della formazione. A causa di un blocco di testo che può essere etichettato con l'etichetta di genere di un individuo, l'algoritmo dovrebbe inferire automaticamente questo tag. In questo caso, consideriamo due potenziali etichette di output: L = {"femminile e maschio) come il nostro dataset sperimentale contiene solo istanze di queste due classi di genere. 5.3.3. Pertanto, limitiamo la nostra scelta di algoritmi a coloro che sono orientati alla classificazione binaria. Lo stesso approccio potrebbe essere esteso per prendere in considerazione etichette di output aggiuntive, riformulando il problema come un compito di classificazione uno contro tutti o più tag.
Il nostro quadro di lavoro differisce da approcci precedenti con due sfide.
3 ).
Anche se i lavori precedenti sono stati seguiti da procedure di estrazione di testi convenzionali, come la derivazione, evitiamo deliberatamente questo passo per preservare il sufisso di genere in termini ed esplorare il suo impatto sull'identificazione di genere per testi con una forte mappatura di parole come lo spagnolo.
Invece di taggare una sequenza di entità con un nome nel testo, affrontiamo il problema circa assegnare A Gender Label a un blocco di testo o documento completo che descrive un'altra persona. Questo è un problema importante per molte applicazioni, tra cui notazione automatica di entrata in database semantici.
Ci sono molte lingue che sono state flettenti, il che significa che le parole possono cambiare la loro forma per riflettere le informazioni grammaticali come numero e tempo o genere Hedlund et al. ( 2001 ). In spagnolo, le parole che finiscono a.o in un consonante denotano i generi maschili mentre quelle con un "sono principalmente femminili. La lemizzazione cerca di rimuovere le differenze tra le forme flettenti di una parola e di ridurre ogni parola nella sua forma radice. Tale pre-elaborazione è stata l'approccio standard all'estrazione del testo e al recupero delle informazioni per una migliore accuratezza nell'identificazione dei termini chiave con un dato messaggio.
Tuttavia, come accennato in precedenza in spagnolo l'iperspsi di molte parole può essere un indicatore utile e diretto per il sesso. Ecco perché sembra ragionevole presumere che se non applichiamo la lematizzazione e conserviamo invece i sufissi di genere, essi possono migliorare l'accuratezza della loro identificazione di genere. La seguente strategia per l'identificazione dei testi di genere è la proposta:
1. Implementare procedure standard di estrazione del testo per preparare un input non elaborato, tra cui tokenizzazione e smaltimento delle parole vuote (i dettagli di implementazione aggiuntivi sono forniti nella sezione 5.3 ).
2. Prima della creazione di una rappresentanza vettoriale per ogni documento, i metodi convenzionali di estrazione del testo suggeriscono che alcuni Sproat et al. ( 2001 ), come la lematizzazione per rimuovere le sfide di flessione e fornire una rappresentazione tipica di parole simili, riducendo al tempo stesso le dimensioni del vocabolario. Invece, proponiamo di sopprimere questa fase di normalizzazione del testo e di preservare invece i sufissi flessotivi che contengono ulteriori informazioni sul genere in lingue specifiche.
3. Poi ri-selezioniamo il processo di produzione del documento standard, generando una rappresentazione vettoriale di ogni carta e costruendo un termine - matrice lettera (ancora più dettagli sono dati nella sezione). 5.3 ).
Tale strategia si applica alla produzione di dati testuali che formano un algoritmo di autolearning per l'identificazione del genere. Per dimostrare l'applicabilità di questa procedura in un ambiente reale, abbiamo progettato un numero per condurre esperimenti di validazione e questi sono descritti come segue.
5.3.2 Configurazione degli esperimenti
L'obiettivo principale è quello di valutare la capacità del nostro quadro proposto per l'identificazione automatica di genere associata a documenti di testo nel mondo reale. A tal fine, abbiamo riguadagnato articoli biografici che descrivono autori letterari delle versioni spagnole e inglesi di DATASET-TH-001 e i suoi dati alimentano altri sistemi basati sulla conoscenza semantica come DATASET-TH-001. Così, sono stati creati due diversi set di dati e uno per ogni lingua. Abbiamo progettato il nostro dataset per garantire una uguale rappresentazione di entrambe le etichette a ingressi biografici scelti per i suoi ei suoi esperimenti spagnoli.
Quando applichiamo la nostra procedura come testo di ingresso sia in spagnolo che in inglese, ci proponiamo di confermare se evitare il rinvio ha un impatto positivo sulle prestazioni del vostro identificatore di genere. Il nostro set di dati selezionato è stato biografie di autori maschili e femminili. Questa scelta ci permette di inquadrare l'esperimento come un problema di classificazione binaria per il quale ci sono diversi algoritmi di autolearning standard. La figura 5.2 mostra una descrizione generale della procedura sperimentale per la valutazione di ogni metodo di apprendimento supervisionato.
Ogni dataset di biografie in inglese e spagnolo è diviso in sottoinsiemi di formazione o test. In particolare, 70 % di biografie in ogni lingua sono utilizzate per la formazione mentre 30 % rimane come set di test per valutare le prestazioni degli algoritmi di apprendimento monitorati. La sezione seguente fornisce ulteriori dettagli sul recupero e la produzione di entrambi i dataset.
5.3.3 Set di dati utilizzati
Abbiamo iniziato, recuperando biografie da autori letterari di DATASET-TH-001 monitorando il loro web direttamente utilizzando il pacchetto DATASET-TH-001 Tastiere e Til-
Figura 5.2: Una descrizione del quadro proposto per la sperimentazione di metodi di monitoraggio alternativi.
SOFTWARE-TH-003 ( 2017 ) disponibili per l'ambiente statistico R, ORG-TH-112 ( 2022 ). Il pacchetto può ottenere un elenco di pagine, sottocategorie e contenuti della pagina, nonché altre informazioni su una categoria individuale.
Il set di dati pubblico disponibile in Gomez e al. ( 2021 (a) 4 contiene 1000 biografie di scrittori estratti da DATASET-TH-001 in lingua inglese. Questi articoli sono ugualmente divisi in un gruppo di donne e una schiera con gli uomini. Le biografie delle donne sono state estratte dalla categoria "autori women.and their first 500 pagine della categoria "autori uomini] di The 19 th Century sono stati ottenuti per le biografie dell'uomo.
Il set di dati pubblico disponibile in spagnolo Gomez e al. ( 2021 (b)
5 contiene 832 biografie da DATASET-TH-001 in spagnolo. Le biografie delle donne sono state estratte dalla categoria "Spagnori. Al contrario, prima 416 pagine della categoria "Spanish Writers of The 20 th Century e' stato recuperato per le biografie degli uomini. Così, queste biografie sono anche divise in due sotto-set: una delle donne e l'altra circa gli uomini.
Il tavolo 5.1 riassume alcune statistiche generali da un'analisi esplorativa preliminare dei set di dati in inglese e spagnolo come descritto sopra.
In precedenza trattiamo ogni biografia utilizzando un pacchetto R di text mining tm Feinereer et al. ( 2008 ). Per rimuovere dalle biografie parole vuote (con termini comuni che normalmente non forniscono informazioni utili per l'analisi)
4 [LINK-REDACTED] 5 [LINK-REDACTED]
Tabella 5.1: Il numero totale e medio che descrive i dataset sia in spagnolo che in inglese.
Dataset Descrizione statistiche Valore
Numero totale di biografie e genomica 500 Ag. numero di termini distinti per biografia di scrittura femminile 50,86
Ag. numero di termini distinti per biografia di scrittura femminile (staging) 38,11
Inglese
Numero totale di biografie sugli autori maschili 500 Ag. numero di termini distinti per biografia 46,2
Ag. numero di termini distinti per biografia di scrittura maschile (staging) 35,62
Numero totale di biografie e genomica 416 Ag. numero di termini distinti per biografia di scrittura femminile 50,03
Ag. numero di termini distinti per biografia di scrittura femminile (staging) 31,44
Spagnolo
Numero totale di biografie sugli autori maschili 416 Ag. numero di termini distinti per biografia di scrittura maschile 51,39
Ag. numero di termini distinti per biografia di scrittura maschile (staging) 32,68
Tein (Sentiero) 2019 ), numero e segno di punteggio con spazi vuoti. Il testo di ogni biografia verrà successivamente convertito in minore e la relativa matrice term-biografia come mostrato in questa tabella. 5.2. Così, ogni set biografico può essere rappresentato come una matrice m × n e con un numero N di biografie nel pacchetto di formazione. Ogni elemento wij della matrice del termine-biografia rappresenta un nome importante o di peso per i in g biografia. Per ottenere il valore di wi j usiamo il TF-IDA Aizawa ( 2003 ), calcolato come ( 5.5 ):
!, ( 5.5 )
wi = t fi j × log N
#
dove t fi j denota il numero di eventi dal termine i in biografia J; g è una cifra totale per le biografie e, infine, d F3 indica quanti biografi sono stati trovati in quel momento.
Va notato che solo le biografie di formazione contribuiscono alla costruzione di termini dizionario che rappresentano tutti i biografi. Cioè, quando il classificatore controlla nuove biografie su un sottoinsieme di test che
Tabella 5.2: Esempio di una matrice term-biografia, dove wi j rappresenta l'importanza e i termini i all'ingresso biografico J.
Dizionario Biografia 1 Biografia 2... Biografia
Università W11 w12... aw1n Matrimonio e M21, F9) Scrittore wm1 Wm2...
il termine quier trovato non nelle biografie del set di formazione è ignorato per il calcolo da distanza. Inoltre, il nostro studio non ha considerato sinonimi e abbreviazioni o forme alternative per un determinato termine.
5.3.4 Risultati
Qui vengono presentati i risultati di esperimenti che confrontano diverse strategie per l'identificazione del genere nei testi. Gli esperimenti per ogni algoritmo di classificazione comportano dieci prove delle divisioni di test di formazione selezionate all'azar.Per essere in grado di eseguire il backup dei risultati, abbiamo eseguito test da Wilcoxon Hollander et al. ( 2013 ), avendo considerato il significato statistico per i valori p meno di 0, 05.
GSVM contro AVS standard
Le seguenti sezioni riassumono i risultati della valutazione di esperimenti che confrontano GSVM con VMS standard nel problema dell'identificazione del genere di testo.
Confronto del numero di itherations: GSVM rispetto a AVS standard
Il tavolo 5.3 Confronto di Iterations conta per GSVM e un tipico VMS utilizzando il classico criterio di arresto. È chiaro che con una media di circa GSVM per il set di dati spagnolo 18 % (con derivati) e 25 % (senza derivati) meno iterazioni rispetto all'approccio standard SVM. Allo stesso tempo, GSVM può ridurre il suo numero di iterazioni di circa 42 % (con derivati) e 44 % (senza derivati). I grandi valori nella deviazione standard per GSVM sono il risultato di entrambi gli approcci che raggiungono un alto numero di iterazioni definito ad alcuni esperimenti, capire quanti iterazione sono stati stabiliti con questo modello.
Il test di Wilcoxon del dataset disponibile in inglese mostra che GSVM migliorato rispetto a LVMN è stato statisticamente significativo, sia come applicato che con un alto
ca lo stemming (p = valore 0,00195 ) come se non applicato (p = 0,00589 ). Se guardiamo al caso delle biografie spagnole, questo miglioramento è statisticamente significativo se non è incluso lo stemming (p = valore 0,00195 ) ma non è significativo quando si utilizza lo stemming (p value = 0,1 ).
Tabella 5.3: Media (prom.) e deviazione standard del conteggio di iterazione nelle fasi di formazione
Metodo di lingua Stemming Nessun stadiamento
avg. s.d. p-value vg.a. p-valori
Spagnolo 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
SVM inglese 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
Le cifre 5.3 a. 5.3 b... 5.4 a e 5.4 b sono stati mostrati graficamente per ogni esperimento a quale conteggio di GSVM e le istanze AVS standard fermano rispettivamente le loro prestazioni di formazione. Il criterio di arresto GSVM rileva quanto presto l'indicatore della velocità di errore sarà stabilizzato (tipline). Invece, il criterio di detenzione SVM classico richiede un maggior numero di iterazioni da interrompere senza fornire alcun tasso di errore migliorato.
Va sottolineato che l'esecuzione del criterio di arresto di GSVM per le biografie in inglese è simile, indipendentemente dal fatto che sia stata applicata o meno la preelaborazione della lematizzazione (vedi figure). 5.3 b) 5.4 b). Un altro risultato notevole è che il tasso di errore per le biografie in spagnolo (vedi figure) 5.3 a e 5.4 a) Espandi un modello oscillante durante l'applicazione della preelaborazione di derivazione (Figura 5.4 (a). Tale comportamento può essere dovuto ad una significativa perdita di informazioni introdotte dall'operazione di rinvio in questa lingua.
Infine, va ricordato che le metriche di valutazione sono molto simili in tutti i casi per etichette di produzione "femminile" e (maschio) con entrambe le lingue.
Confronto di GSVM vs. accuratezza Standard SVM
Per valutare le prestazioni della tecnica SVM standard con GOVM, abbiamo monitorato la precisione, il richiamo e le metriche di punteggio F1 Baeza-Yates & Ribeiro ( 2011 ); Sokolova e Lapalme ( 2009 ); Olson e Delen ( 2008 ). Il tavolo 5.4 mostra un confronto di SVM e GLVM. per biografie in inglese con o senza derivazione. Per ogni metodo e metrica, questa tabella mostra la media (avg.) con deviazione standard [s.d.] Inoltre, viene mostrato il valore p del test di Wilcoxon per ogni confronto. I risultati del test di Wilcoxon indicano che non ci sono differenze statisticamente significative per nessuna delle metriche considerate, come e come è indicato in una colonna p-valore dove tutti i valori sono stati superiori a 0,05.
(a) Spagnolo
(b) Lingua inglese
Figura 5.3: Nessuna derivazione. Confronto dei criteri di detenzione se non si utilizza il pretrattamento di riferimento.
I risultati riportati nelle tabelle 5.4 e 5.5 hanno dimostrato empiricamente che per i problemi di identificazione del genere di testo, le tecniche di GSVM ereditano le stesse proprietà di quelle di LVM e forniscono risultati di precisione simili.
Il tavolo 5.5 mostra un confronto di SVM e GSSM. per biografie spagnole con o senza derivazione. Ancora una volta, per ogni metodo e metrica questa tabella mostra la media (avg.) con deviazione standard [s.d.] così come ai corrispondenti valori p del test di Wilcoxon Analogamente alle biografie in inglese, i risultati dei test di Wilcoxon indicano che non ci sono differenze statisticamente significative per entrambi i valori metrici (p-valori sono stati superiori a quelli di 0.05 ). E' così che...
(a) Spagnolo
(b) Lingua inglese
Figura 5.4 Confronto dei criteri per la sua detenzione con riferimento ad una pretrattazione di rinvio.
Tabella 5.4: Inglese. SVM e GLVM. tecnologie di performance per le biografie in inglese, con o senza derivazione.
Stem. Metodo di genere Precisione Richiamo F1 punteggio
(s.d.) p-value avg.
No femmina SVM 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
SVM maschio 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Sì SVM femminile 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
SVM maschio 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
Il numero di iterazione raggiunto da GSVM non ha un impatto sulla precisione e
la classificazione.
Tabella 5.5 Spagnolo. SVM e GLVM. tecnologie di performance per le biografie in spagnolo, con o senza derivazione.
Stem. Metodo di genere Precisione Richiamo F1 punteggio
(s.d.) p-value avg.
No femmina SVM 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
SVM maschio 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Sì SVM femminile 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
SVM maschio 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Il tavolo 5.6 campione per GSVM un confronto tra derivazione e non derivati, con i valori p corrispondenti. Per le biografie spagnole, i risultati mostrano un significativo degrado quando si include la derivazione con valori p-valori di 0, 0097, 0, 00586 e 0, 00195 per precisione, richiamo e punteggio F1 rispettivamente nei generi femminili. 0, 0137, 0, 00195 e 0, 00195 per precisione, richiamo e punteggio F1 rispettivamente nei generi maschili. Invece, per le biografie in inglese i valori p di tutte le metriche superano il loro livello e 0,05 Ciò indica l'assenza di un effetto significativo.
Tabella 5.6: Confronto delle metriche di performance di derivazione rispetto al non-derivativo quando si applica GSVM.
Lingua Gender Stem Precision Recall Punteggio F1
avg. p-value aw.p-valutazione ali.ct
Femmina spagnola No 0,909 0,0097 0,907 0,00586 0,903 0,00195 Sì. 0,770 0,781 0,747
Uomo No 0,889 0,0137 0,913 0,00195 0,891 0,00195 Sì. 0,724 0,790 0,713
Inglese Femmina No 0,908 0,343 0,859 0,124 0,879 1 Sì. 0,880 0,898 0,888
Uomo No 0,823 0,108 0,909 0,286 0,843 0,636 Sì. 0,899 0,884 0,891
GSVM vs. altri algoritmi
Questa sottosezione confronta le prestazioni e i tempi di formazione di GSVM con altri metodi di autolearning, come le foreste casuali (RF) Breiman. 2001 ) e Boosting Schapire ( 1990 ), da librerie di software comuni. In questi test, gli iperparametri dell'algoritmo vengono impostati sui valori predefiniti. Per ogni algoritmo e lingua, confrontiamo due flussi di lavoro alternativi di estrazione del testo per ogni metrica: (i) essi includono un passo di deviazione come con la maggior parte delle applicazioni di texting convenzionali. Usiamo il tempo come metrica
Confronto come non c'è un confronto equo dei conteggi di iterazione, con l'implementazione di ogni metodo a seguito di un approccio di iterazione diverso.
Confronto dei tempi di allenamento: GSVM rispetto ad altri algoritmi
Il tavolo 5.7 sommare il tempo di esecuzione (in secondi) per tutte le versioni di algoritmi utilizzati con questa ricerca. Utilizzando la derivazione per lo spagnolo, GSVM è in media in aumento 10,05 tempi più veloci di Boosting e 42,87 a volte più veloce di RF, mentre per la lingua inglese GSVM è una media in su 15,79 tempi più veloci di Boosting e 59,15 tempi più veloci di RF. Quando la derivazione non si applica, GSVM è come un aumento medio 49,63 tempi più veloci di Boosting e 81,00 tempi più veloci di RF. GSVM è una media 22,91 tempi più veloci di Boosting e 77,70 tempi più veloci di RF. Per riassumere, con il test di Wilcoxon eseguito e una differenza statisticamente significativa tra i metodi indica che il tempo di formazione GSVM è costantemente più breve rispetto ad altre tecnologie.
Tabella 5.7: media (avg.) e deviazione standard [s.d.] del tempo di formazione
Metodo di lingua Stemming Nessun stadiamento
avg. (s.d.) p-value apr.tit
Spagnolo GSVM 3,096 ( 0,460 ) 2,889 ( 0,150 ) Miglioramento 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
Spagnolo GSVM 3,799 ( 0,074 ) 3,883 ( 0,525 ) Miglioramento 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
Confronto di precisione: GSVM rispetto ad altri algoritmi
Dal momento che la derivazione non sembra essere significativa con l'elaborazione di biografie in inglese, per motivi spaziali concentreremo la nostra analisi sul suo e il suo spagnolo. Il tavolo 5.8 mostra un confronto di derivazione rispetto ai valori p non derivati e corrispondenti per GSVM, Boosting o Random Forest. GSVM ottiene risultati molto promettenti, soprattutto quando la derivazione non viene utilizzata con precisione e richiamo. Punteggio F1 sopra 90 % Nella maggior parte dei casi, anche se Boosting e Random Forest migliorano principalmente le prestazioni GSVM. Il fatto che entrambe le tecnologie appartengano a quelle conosciute come metodi interi (Sagi e Rokach, 2018 ). Attraverso la formazione di modelli multipli e l'integrazione delle loro previsioni, questi metodi migliorano le prestazioni predittive di un singolo modello. Va notato che, come GSVM si comporta con un MVS standard in termini di precisione questi risultati dimostrano l'importanza e la rilevanza per la derivazione da non referral in lingue come a livello spagnolo. Quella tecnica di preelaborazione pure
colpisce i risultati da ottenere utilizzando altri tipi di classificatori.
Inoltre, i valori p di questa tabella 5.8 mostrare un significativo degrado nelle prestazioni di tutti gli algoritmi quando si applica la derivazione. I risultati mostrano costantemente che per lo spagnolo, senza derivazione e precisione del punteggio F1 sono stati più alti di 90 % nella maggior parte dei casi, durante l'utilizzo di derivazione si verifica una arrotondazione del degrado. 15 %.
Tabella 5.8: Tecnologie di precisione per i metodi di biografie in spagnolo.
Metodo Gender Stem Precision Recall Punteggio F1
(s.d.) p-value avg.
GSVM femmina No 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 Sì. 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Uomo No 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 Sì. 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Boosting Femmina No 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 Sì. 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
Uomo No 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 Sì. 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF Femmina No 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 Sì. 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
Uomo No 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 Sì. 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 Conclusioni
In questa sezione, consideriamo alcune spiegazioni per le differenze riscontrate nelle prestazioni di identificazione di genere e queste riflettono sui potenziali limiti del nostro lavoro.
5.4.1 Confronto degli algoritmi di classificazione
I risultati suggeriscono che il monitoraggio dell'applicazione di Stemming nella produzione di dati testuali, le metriche delle prestazioni sono abbastanza simili indipendentemente dall'algoritmo di autolearning selezionato per la classificazione. Tuttavia, ci sono differenze a seconda della lingua utilizzata.
Di conseguenza, possiamo concludere che gli algoritmi di classificazione autolearning per l'identificazione del genere possono essere direttamente influenzati da sufi presenti nei dataset utilizzati per formare l'algoritmo. I nostri risultati confermano che il preprocessing di Stemming, un metodo che apparentemente semplifica il problema della classificazione può indurre la confusione di genere a risolvere questo problema.
5.4.2 Impatto di rimozione di Stemming
Un obiettivo principale del quadro proposto è quello di spiegare se la ritenzione e il monitoraggio con informazioni sul genere in alcune lingue, come lo spagnolo può fornire una migliore prestazione di classificazione per l'identificazione di genere. Secondo i risultati presentati in queste tabelle 5.6 e 5.8, c'è un notevole aumento delle prestazioni di rating in spagnolo per gli algoritmi che abbiamo considerato con i nostri esperimenti quando il passaggio di derivazione viene rimosso dalla produzione di dati.
Invece, i risultati per la lingua inglese indicano una variazione minima nella metrica di punteggio F1 tra Stemming e non-Scentering che applicano o preparano i dati a qualsiasi algoritmo di classificazione. Quella lingua ha risultati simili rispetto a metriche di precisione e prestazioni del richiamo.
Nel complesso, questi risultati sostengono la nostra considerazione iniziale che evitare l'implementazione di Stemming può influenzare positivamente l'identificazione di genere nei testi Quando il contenuto è disponibile con lingue che forniscono ulteriori dettagli morfologici che portano informazioni di genere come lo spagnolo. Confermare le conoscenze ottenute dalla precedente ricerca sull'importanza della fase di produzione dei dati, soprattutto se lavorare con lingue diverse da Uysal e Gunto ( 2014 ).
5.4.3 Limiti
Il nuovo metodo GSVM che introduce un criterio di arresto precoce per la fase di formazione funziona bene con un problema specifico di identificazione del genere di testo. Ulteriori esperimenti dovrebbero quindi essere eseguiti per valutare le prestazioni GSVM in altri compiti di classificazione prima di raccomandare MSSG come un'innovazione metodologica generale di VMS con apprendimento automatico.
Per quanto riguarda il quadro proposto per l'identificazione del testo di genere, una limitazione importante del nostro ambiente sperimentale è che abbiamo confinato un obiettivo gendervariable con la scelta binaria. Problema sollevato da altri Hamidi et al. ( 2018 ); Tastiere ( 2018 ). Infatti, hai scoperto che 55 di 58 studi per l'identificazione automatica del genere con l'autolearning hanno assunto un'uscita di gener binario. In questo senso, un potenziale percorso per la ricerca futura potrebbe essere quello di sostituire i nostri algoritmi di classificazione binaria con un'alternativa in quanto potrebbero essere stati modelli di apprendimento automatico che ammettono obiettivi continui e / o multitilarici. In tali contesti, sarebbe interessante valutare se i sufissi di genere hanno ancora alcuni vantaggi per l'identificazione dei generi.
Un'ulteriore limitazione del nostro approccio è che il testo non può essere disponibile in una lingua fortemente infiammata, diversa dall'inglese. Tuttavia, in questo caso il testo potrebbe essere tradotto automaticamente da Spagnolo a Russo o altre lingue con proprietà simili attraverso Servizi automatizzati. La versione tradotta del testo può fornire ulteriori informazioni di genere che permettono di ottimizzare le prestazioni di classificazione. Allo stesso modo, è necessaria una maggiore ricerca per confermare che questi risultati iniziali che confrontano lo spagnolo e l'inglese sono replicabili con l'ingresso di dati in lingue alternative.
5.4.4 Innovazione
In questa ricerca, abbiamo un nuovo criterio di arresto per gli algoritmi di ottimizzazione vettoriale di supporto basati sulle proprietà geometriche della rappresentazione vettoriale del contenuto di testo con l'obiettivo di risolvere il problema automatizzato di identificazione di genere. Per questo particolare problema, mostriamo che l'algoritmo proposto richiede meno tempo per la formazione se confrontato con l'applicazione di algoritmi SVM standard. Per quanto riguarda il quadro, invece di seguire le procedure convenzionali di normalizzazione nell'estrazione del testo che eliminano le sfide di genere come il riferimento, conserviamo questi elementi morfologici trovati con lingue fortemente inflitte e li abbiamo ottimizzati per le loro prestazioni. Valutiamo in che modo questo nuovo approccio può essere messo in termini di tempi di formazione confrontando diversi algoritmi di autolearning per la classificazione, utilizzando un dataset di input biografico. DATASET-TH-001 e lo spagnolo.
I nostri risultati suggeriscono di evitare un rinvio (stemming) alla preelaborazione del testo per le lingue, inclusi elementi aggiuntivi con informazioni di genere, come lo spagnolo e così via. Questa procedura non ha influenzato altre lingue neutre come l'inglese.