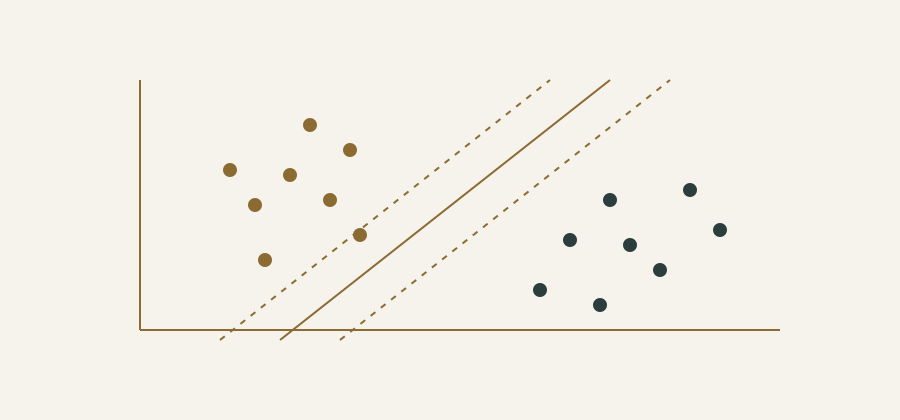
Suurien ja runsaiden tekstiaineistojen saatavuus, jotka on luotu pääasiassa verkkosisällöstä, on ollut tärkeä tekijä tiedon louhinnassa, jossa on käytetty algoritmeja tai autooppimismenetelmiä ennennäkemättömällä hinnalla. Tämä on herättänyt suurta kiinnostusta tutkimuksen automaattisen oppimisen tekstianalyysi Aggarwal ( 2018 ). Tänään teksti kaivostoiminta Srivastava ja Sahami ( 2009 ) ja luonnollisen kielen (PLN) käsittely Eisenstein 2019 ) muodostavat perustan useille näistä tutkimuksista ja täytäntöönpanoista.
5.1 Johdanto
DATASET-TH-001 Vrandeňci c ja Krötzsch ( 2014 ) on esimerkki jäsennellystä ja vapaasti käytettävissä olevasta tietolähteestä, joka perustuu tiedoista saatuihin tietoihin DATASET-TH-001 useilla kielillä. EY:n perustamissopimuksen DATASET-TH-001 on ollut semanttisessa notaatioprosessissa laajentamassa tietopohjaa DATASET-TH-001 graafisen jäsennellyn datamallin noudattaminen uusien sovellusten integroimiseksi.
Yksi näistä aloista on sukupuolten tunnistaminen tekstissä. Tavoitteena on antaa sukupuolimerkki (esim. "feminiini ja mies) tekstialueelle, jossa käytetään kielellisiä ominaisuuksia tai muita kuvailevia ominaisuuksia. Yleisesti ottaen aikaisemmassa tutkimuksessa on keskitytty tunnistamaan tekstinsä kirjoittavan henkilön sukupuoli ja profiili. Joitakin esimerkkejä ovat Yanin ja Y-blogien tekijöiden sukupuolitunnisteet ( 2006 ) ja mikrobloggaaminen
Mukherjee ja Bala ( 2017 ) tai asiakassuhteiden hallintajärjestelmien (CRM) käyttäjille Amado et al. 2018 ).
Uusien panosten luominen DATASET-TH-001 ja jäsenneltyjä tietoja artikkeleissa DATASET-TH-001 Täydentää jokainen aihe. Esimerkiksi, jos haluamme saada takaisin jäsenneltyjä tietoja "Gabriel García Márquez ja ovat DATASET-TH-001 vastaava merkintä 2. Sitten voimme tutkia useita aloja, joilla on kuvailevia ominaisuuksia tämän henkilön, kuten "sukupuoli tai sukupuoli. 3. Tässä esimerkissä tämän kiinteistön arvo on "mies. Kun kirjoittaa tämän artikkelin, kuinka tarkkoja tietoja voidaan 6 viittaus eri artikloihin: DATASET-TH-001 jotka tukevat "male.a:n" hajauttamista
Tämä kenttä käyttää strukturoituja tietoja. Tästä huolimatta avoimena hankkeena osaamisen luomiseksi yhteistyössä DATASET-TH-001 ovat usein kärsineet vandalismia ja hyökkäyksiä Adler et al. ( 2011 ); Geiger ja Ribes ( 2010 ). Jos pahansuovat tekijät ovat muuttaneet alkuperäistä strukturoitua dataa DATASET-TH-001, havaita virheet ilman manuaalinen tarkastus olisi monimutkainen tehtävä ja enemmän ottaen huomioon suuri koko sen tietokanta DATASET-TH-001. Lisäksi, jos ei ole jäsenneltyä tietoa sukupuolesta artikkeli DATASET-TH-001, olisi mahdotonta antaa arvoa suoraan "sukupuoli tai sukupuoli" omaisuutta sen maahantulon DATASET-TH-001 Nämä tiedot on toimitettava komissiolle sen ensimmäisessä kokouksessa. Sukupuolitiedot on sen sijaan merkittävä automaattiseksi analyysiksi, jossa analysoidaan kehossa strukturoituja tekstitietoja. DATASET-TH-001 Se voisi parantaa näiden haasteiden sietokykyä. Tämä esimerkki voidaan helposti ekstrapoloida mihin tahansa muuhun tietojärjestelmään, jonka pitäisi automaattisesti merkitä jonkin tekstilohkon sisältö sukupuolitunnisteella.
Keskityimme tiettyyn tapaukseen, ongelmaan, joka liittyy hänen sukupuolensa automaattiseen määrittämiseen, kuten on kuvattu elämäkerrallisessa tekstissä. Muuta työtä varten keskustelemme tästä ongelmasta sukupuolten tunnistamisena. Muita kieliä kuin englantia sisältävien tutkimusten puute vaikeuttaa uusien tekstien louhintamenettelyjen kehittämistä, jotta ongelma voitaisiin ratkaista paremmin. Sen sijaan, että keskityttäisiin yksinomaan englantiin, jossa on vähemmän sukupuolten tasa-arvoon liittyviä tekijöitä, olemme tutkineet espanjankielistä tekstiä, jossa vangitaansukupuolta koskevia tietoja ja joka on yleisempi tällä kielellä. Tämän saavuttamiseksi vältymme säännöllisiltä normalisoitumisvaiheilta perinteisten tekstien, kuten johdannaisten ja Eisensteinin vetomatisaation, louhimisessa ( 2019 ), koska ne sulkevat pois sukupuolitiedotuksen kielelliseltä kannalta. Tämän lähestymistavan mukaisesti olemme osoittaneet, että tekstisisällölle voidaan antaa enemmän sukupuoliarvoa.
Kun tekstiä käsitellään automaattisella oppimistekniikalla, siitä on yleensä hyötyä.
2 [LINK-REDACTED] 3 [LINK-REDACTED]
Suorittaa vektori suorituskykyä korkea dimensio ja dispersio, koska ne sisältävät lukuisia osia nolla-arvo. Ympäristössä, jossa sirotellaan korkea-ulotteisia esityksiä, MOguerza et al. (SVM) 2006 ) ovat computatiivisesti sopivia Jocachims ( 2002 ). Perinteisen optimoinnin ongelmanratkaisutekniikoiden mukauttaminen SVM Joachimsiin ( 1999 ) sovelletaan sukupuolien tunnistamiseen ei takaa nopeaa lähentymistä, kun iterointi lähestyy optimaalista ratkaisua sen taustalla olevaan optimointiongelmaan.
5.2 Ehdotus
Tässä jaksossa, osana SVM-kehystä käytämme geometrisiä ominaisuuksia tekstin sukupuoli tunnistustehtävään muuttaa taustalla optimointi algoritmin stop kriteeri korvaamalla Karush- Kuhn-Tucker Feng ja Li ( 2018 ) uudella ehdotuksella, joka sisältää tiedot (virhetaso) Tämä ei liity suoraan matemaattisesti kriteeri, joka klassinen optimointi SVM algoritmi yrittää täyttää, koska se voi mahdollisesti mukauttaa sen luonne ja geometrinen ongelma ratkaista. jäljempänä tämä muutettu SVM Geometrics (GLVM). Tämän uuden lähestymistavan toimivuuden arvioimiseksi näitä ehdotuksia verrataan muihin Wittanin ja muiden seurantamenetelmien kanssa ( 2017 ) automaattisen sukupuolitunnistuksen osalta kirjailijoiden elämäkerrallisissa teksteissä, jotka on saatu DATASET-TH-001. Arvioidaan, olisiko vältettävä lesbouttamisen yleistä kulkua tekstien louhinnassa, jossa poistetaan sukupuoliselonteot sanoilla, jotka ovat tärkeitä tekstiviestianalyysin kannalta ja parantavat sukupuolten tunnistamisen suorituskykyä. Myös GSVM-lähestymisen tehokkuus algoritmin koulutusvaiheen nopeuttamisessa on osoitettu ja osoittaa, että tämä menetelmä ei vaikuta merkittävästi menettelyn suorituskykyyn.
5.2.1 Geometrinen pysäytysperuste
Koulutustietoihin liittyvä SVM-päätöstoiminnon geometria on mitattavissa kussakin iteraatiossa mittaamalla tai arvioimalla virhetaso. Toisin sanoen silloin, kun tämä virhetaso vakauttaa päätöksentekotoiminnon, se täyttää nämä tietojen tehokasta luokittelua koskevat kriteerit. Luku 5.1 osoittaa esimerkin kaksi moniulotteinen Gaussian pilviä. SVM:n suoritus iterointiin asti 2 kuvassa esitetty erotuspinnan tuotanto 5.1 a jono Kuva 5.1 b osoittaa iterointiin asti lasketun erotusalueen 18. Luvun päätöstehtävä 5.1 a sisältää saman empiirisen virheen kuin lukupäätöstoiminto 5.1 b, että tarvitaan enemmän iteraatioita ja
Näin ollen enemmän koulutusaikaa sen rakentamiseen. Sen sijaan päätöksentekotehtävän rakentaminen kuvassa 5.1 Hän tarvitsi vähemmän koulutusta iteraatioita.
(a) SVM-käyttö iterointiin asti 2 b) SVM-käyttö iterointiin asti 18
Kuva 5.1 Kaksi erotuspintaa SVM:lla: (a) puhdistumapinta, joka on saatu sen jälkeen 2 b) erottelualue laskettuna sen jälkeen, kun 18 iteraatiot.
Näiden säätiöiden perusteella määrittelemme εk:n iterointiin K ja ∞ > asetetun koulutuksen virhetasoksi 0 todellisena arvona, joka toimii suvaitsevasti. Mukaan ( 2.3 ),
N X
εk = 1
g
i = 1 ( 1 − yi f (xi) ja 5.1 )
Sea δk = ∞ 124; εks - httg ~ 5 |. Menetelmä on lopetettava seuraavien vaatimusten noudattamisen jälkeen:
(δk ≤ ∞) 5 {pos ()} 15 {pos (g)} 100 ε), ( 5.2 )
jossa symbolilla ") tarkoitetaan loogista toimijaa, ja toisin sanoen kaikki neljä eriarvoisuutta sen kriteerissä olisi täytettävä samanaikaisesti. Mittaamalla ero δk ≤ ∞ viiden iteraation välein ja rentouttamalla klassista kriteeriä voimme välttää satunnaisuuden aiheuttamat ei-toivotut virhehuiput. Seuraava teoria osoittaa, että säilöönottoperusteiden välillä on suora yhteys ( 2.12 ) ja 5.2 ).
Teoreema 2. Dada ∞ > 0 ja ∞ > 0 ), on olemassa useita iterointi k. ja β, kuten δk ≤ ∞ y m (βg.
Todisteita. Corollarukselle 1.1, on väitetty, että:
L '′′′ K →
m (βk) − M [β ks] = 0
Näin ollen on olemassa useita iterointi kΩ sellainen, että eli k > K.
m (β k) − M ja g.
Ole vektori β... ongelmaratkaisu ( 2.5 ), jossa xi, kuten β I > 0 ovat niin kutsuttuja tukivektoreja. On hyvin tunnettua, että f-funktio, joka määrittää päätöksen pinnan g {(x) = 0 Ottakaa lomake:
N X
f (x) =
i = 1 β i yyk (xi, x) + b * 5.3 )
kun
b = - pn i) 1 iK (xi, x +)
2 + pn i = 1 β iK (xi, x −)
2,
jossa x + ja x - ovat kaksi tukivektoria luokissa enemmän 1 sekä 1 Koska niihin liittyy β + ja ′′ - Ligrange kerroin on 0 < β + {C} ja 0 < β - > C
Tarkastelkaamme tämän ongelman määrittämää päätöksentekotehtävää ( 2.5 ), iterointi k:
N X
f k (x) =
i = 1 β k i yyk (xi, x) + bg.
On helppo todistaa, että, "" γ > 0, on kloe iteration numero, kuten.k > qy:
g k (x) - f 5.4 )
Se johtuu teoreemasta. 1 Tämä tarkoittaa, että:
L '′′...m k → ∞ β g = ß...
ja siten, että 0 On olemassa useita iterointi kν sellainen, että, eli k > q.n. se on täytetty, että:
β k - α′′ ≤ v.
Jos otamme ja kuinka pieni, ( 5.4 ) täytetään, kun kγ = k. Dada ∞ > 0, jos meillä on ja ovat tarpeeksi pieniä ( 5.4 ) ja k > kγ määritelmällä ( 5.1 ), katsoo seuraavaa:
{Pos ( 192,240 )} 5 | ≤τ,
ja teoreema on voimassa kΩ, β = m '′′ ax {g-q.a.).
□
Perusteesta alkaen ( 5.2 ) luottaa virhetaso, se on intuitiivinen asettaa arvo ∞. Voimme sanoa sen, esimerkiksi a) = 0,0005 virhetasona enintään 0,05 % voidaan pitää huomattavan alhaisena. Että intuitio ei ole olemassa kriteerin ( 2.12 ) koska g (β]:n suuruutta ei voida arvioida etukäteen. Pääluokka 5.3 Olemme osoittaneet, että sukupuolten tasa-arvoa koskevassa erityistapauksessa teksteissä voidaan löytää ja täyttää asianmukainen laaja-alainen päätöksentekoalue ( 5.2 ) huomattavasti vähemmän iteraatioita kuin yleisesti käytetyn teoreettisen kriteerin ( 2.12 ). Keskeistä on korkea-ulotteinen ympäristö, jossa teksti oli edustettuna, mikä mahdollistaa hyvän empiirisen yleistymisen nopeasti. Näin ollen empiirisestä näkökulmasta GSVM:n odotetaan perivän LVM:n yleiset ominaisuudet.
5.3 Kokeet
Tässä jaksossa kuvataan yksityiskohtaisesti sukupuolten tunnistamiseen liittyvää ongelmaa ja sitä, miten kokeilut toteutetaan.
5.3.1 Ongelma
Sukupuolten tunnistamisen ongelma tekstitietoina koulutuksen luokittelutehtävän seurantahaasteina. Koska teksti lohko, joka voidaan merkitä henkilön sukupuoli etiketti, algoritmin pitäisi automaattisesti päätellä tämän tagin. Tässä tapauksessa pidämme kahta mahdollista tulostusmerkintää: L = {"feminiininen ja miespuolinen), koska kokeelliseen aineistoomme sisältyy vain tapauksia näistä kahdesta sukupuoliluokasta. 5.3.3. Näin ollen rajoitumme valinta algoritmeja niihin suuntautunut binary luokittelu. Samaa lähestymistapaa voitaisiin laajentaa siten, että siinä otettaisiin huomioon lisätulostusmerkinnät ja muotoiltaisiin ongelma uudelleen niin, että se luokiteltaisiin kaikkiin tai useisiin tunnisteisiin.
Työkehikkomme eroavat aiemmista lähestymistavoista, ja niihin liittyy kaksi haastetta.
3 ).
Vaikka aiempia työpaikkoja on seurattu tavanomaisilla tekstien louhintamenettelyillä, kuten johdannolla, vältämme tarkoituksellisesti tätä askelta säilyttää sukupuolisidonnaisuus ja tutkia sen vaikutusta sukupuolten tasa-arvoon teksteissä, joissa on vahva sanahelinä, kuten espanja.
Sen sijaan, että kirjaisimme entiteettisekvenssin, jossa on nimi tekstissä, käsittelemme ongelmaa, joka liittyy A-sukupuolietiketin myöntämiseen yhdelle tekstilohkolle tai toiseen henkilöön kuvaavalle täydelliselle asiakirjalle. Se on tärkeä ongelma monille sovelluksille, mukaan lukien automaattinen merkintä semanttisiin tietokantoihin.
On olemassa monia kieliä, jotka ovat taipuvaisia, eli sanat voivat muuttaa muotoaan heijastaa kieliopin tiedot numero ja aika tai sukupuoli Hedlund et al. ( 2001 ). Espanjaksi, sanat, jotka päättyvät at.tai consonant merkitsevät mies genrejä, kun taas ne, joilla "ovat pääasiassa naisellinen. Lemisation yrittää poistaa eroja taivuttavat muodot sanan ja vähentää jokainen sana sen juurimuotoon. Kyseinen esikäsittely on ollut standardimenetelmä tekstinlouhintaa ja tiedon hyödyntämistä varten, jotta voitaisiin paremmin määrittää keskeiset termit tietyllä viestillä.
Kuitenkin, kuten aiemmin mainittiin espanjassa hyperspsis monet sanat voivat olla hyödyllinen ja suora indikaattori sukupuoli. Siksi tuntuu järkevältä olettaa, että jos emme käytä lematisaatiota ja säilytä sukupuolten kiinnityksiä sen sijaan, ne voivat parantaa sukupuolitunnisteidensa tarkkuutta. Sukupuolitekstien yksilöimiseksi ehdotetaan seuraavaa strategiaa:
1. Sen on pantava täytäntöön vakiomuotoiset kaivosmenettelyt jalostamattoman syötteen valmistamiseksi, mukaan lukien merkitseminen ja tyhjien sanojen hävittäminen (lisätiedot täytäntöönpanosta esitetään jaksossa). 5.3 ).
2. Ennen kuin luodaan vektori edustus kunkin asiakirjan, perinteiset tekstin kaivosmenetelmät viittaavat siihen, että jotkut Sproat et al. ( 2001 ), kuten lematisaatio, jolla voidaan poistaa taipuvaisia haasteita ja tarjota tyypillinen edustus samanlaisia sanoja samalla vähentää sanaston kokoa. Sen sijaan ehdotamme, että tämä tekstin normalisoinnin vaihe vaimennetaan ja säilytetään sen sijaan joustavat oikosulut, jotka sisältävät lisätietoja sukupuolesta tietyillä kielillä.
3. Sen jälkeen valitsemme uudelleen standardidokumentin tuotantoprosessin, luoden vektori-esittelyn jokaisesta paperista ja rakennamme termin - kirjainmatriisin (taas lisää yksityiskohtia annetaan jaksossa). 5.3 ).
Tätä strategiaa sovelletaan sellaisten tekstitietojen tuottamiseen, jotka kouluttavat automaattioppimisalgoritmin sukupuolen tunnistamista varten. Todistaaksemme tämän menettelyn sovellettavuuden todellisessa ympäristössä, olemme suunnitelleet useita validointikokeita varten, ja niitä kuvataan seuraavasti.
5.3.2 Kokeiden asetukset
Päätavoitteena on arvioida, miten tehokkaasti ehdotetut puitteet, jotka koskevat sukupuolten automaattista tunnistamista, liittyvät tosielämän teksteihin. Tätä varten olemme saaneet takaisin elämäkerrallisia artikkeleita, joissa kuvataan kirjailijoita espanjan ja englannin versioita DATASET-TH-001 ja sen data syöttää muita järjestelmiä, jotka perustuvat semanttiseen tietoon DATASET-TH-001. Näin on luotu kaksi eri tietokokonaisuutta ja yksi kullekin kielelle. Olemme suunnitelleet aineistomme varmistamaan molempien merkkien tasa-arvoisen edustuksen hänen ja hänen espanjalaisiin kokeisiinsa valituissa elämäkerrallisissa syöteissä.
Kun käytämme menettelyämme sekä espanjan- että englanninkielisenä merkintätekstinä, pyrimme vahvistamaan, onko lausuntopyynnön välttämisellä myönteinen vaikutus sukupuolitunnisteen suorituskykyyn. Valikoimamme oli mies- ja naiskirjailijoiden elämäkertoja. Tämä valinta mahdollistaa meidän kehys kokeen binary luokittelun ongelma, johon on olemassa useita standardi autolearning algoritmeja. Luku 5.2 esitetään yleinen kuvaus kunkin valvotun oppimismenetelmän arviointimenetelmästä.
Jokainen aineisto elämäkerrat englanniksi ja espanjaksi on jaettu koulutukseen tai testaus subsets. Erityisesti: 70 % Elämäkerrat kullakin kielellä käytetään koulutukseen 30 % jää testiksi, jolla arvioidaan seurattujen oppimisalgoritmien suorituskykyä. Seuraavassa jaksossa esitetään lisätietoja molempien tietokokonaisuuksien talteenotosta ja tuotannosta.
5.3.3 Käytetyt tietokokonaisuudet
Olemme aloittaneet, palauttaa elämäkertoja kirjallisuuden kirjoittajia DATASET-TH-001 seuraamalla verkkoaan suoraan paketin avulla DATASET-TH-001 Keyes ja Til-
Kuva 5.2: Kuvaus vaihtoehtoisten valvontamenetelmien testausta koskevista ehdotetuista puitteista.
SOFTWARE-TH-003 ( 2017 ) saatavilla tilastollista ympäristöä varten R ORG-TH-112 ( 2022 ). Pakkauksessa on luettelo sivuista, alaluokista ja sivun sisällöstä sekä muita tietoja yksittäisestä kategoriasta.
Julkisia tietoja on saatavilla Gomez ja al. ( 2021 a) 4 sisältää 1000 kirjailijoiden elämäkerrat DATASET-TH-001 englannin kielellä. Nämä artikkelit on jaettu samaan ryhmään naisia ja ryhmä miesten kanssa. Elämäkerrat naisten on poimittu kategoriasta "kirjailijat naiset. ja heidän ensimmäinen 500 sivuja kategoriasta "kirjailijat miehet] 19 nt Century on hankittu ihmisen elämäkertoja.
Espanjan Gomezissa ja al. ( 2021 b)
5 sisältää 832 Elämäkerrat DATASET-TH-001 - Espanjaksi. Naisten elämäkerrat on poimittu luokasta "Espanjan kirjailijat. Päinvastoin, ensiksi 416 sivuja kategoriasta "Espanjan kirjailijat 20 Century on noudettu miesten elämäkertoihin. Näin ollen nämä elämäkerrat on jaettu myös kahteen alasarjaan: toiseen naisista ja toiseen miehistä.
Taulukko 5.1 Tiivistelmässä esitetään joitakin yleisiä tilastoja edellä kuvatuista alustavista aineistoista englanniksi ja espanjaksi.
Käsittelemme aiemmin jokaista elämäkertaa R-paketilla tekstinlouhintaa tm Feinereer et al. ( 2008 ). Poistaa elämäkerrat tyhjiä sanoja (yleiset termit, jotka eivät yleensä anna hyödyllistä tietoa analyysi) Eisens-
4 [LINK-REDACTED] 5 [LINK-REDACTED]
Taulukko 5.1: Tietoaineistojen kokonaismäärä ja keskiarvo sekä espanjaksi että englanniksi.
Dataset Kuvaustilastot Arvo
Elämäkertojen ja genomiikan kokonaismäärä 500 Ag. määrä erillisiä termejä per nainen kirjoittaa elämäkerta 50,86
Ag. määrä erillisiä termejä per nainen kirjoittaa elämäkerta (staging) 38,11
englanti
Mieskirjailijoita koskevien elämäkertojen kokonaismäärä 500 Ag. määrä erillisiä termejä elämäkertaa kohti 46,2
Ag. määrä erillisiä termejä per mies kirjoittaa elämäkerta (staging) 35,62
Elämäkertojen ja genomiikan kokonaismäärä 416 Ag. määrä erillisiä termejä per nainen kirjoittaa elämäkerta 50,03
Ag. määrä erillisiä termejä per nainen kirjoittaa elämäkerta (staging) 31,44
espanja
Mieskirjailijoita koskevien elämäkertojen kokonaismäärä 416 Ag. määrä erillisiä termejä per mies kirjoittaa elämäkerta 51,39
Ag. määrä erillisiä termejä per mies kirjoittaa elämäkerta (staging) 32,68
Tein ( 2019 ), pistemäärän numero ja merkki tyhjillä välilyönneillä. Kunkin elämäkerran teksti muutetaan myöhemmin pieneksi ja suhteellisen termin biography matriisi kuten tässä taulukossa esitetään. 5.2. Näin ollen jokainen elämäkerrallinen sarja voidaan esittää m × n -matriisina ja N-määrä elämäkertoja koulutuspaketissa. Jokainen wij-elementti termi-biography matriisi edustaa tärkeä tai paino nimi i in g elämäkerta. Saadaksemme Wi j: n arvon käytämme TF-IDA Aizawa ( 2003 ), laskettuna seuraavasti ( 5.5 ):
!, ( 5.5 )
wi = t fi j × log N
fi
Jossa t fi j tarkoittaa useita tapahtumia, jotka ovat peräisin termin i elämäkerta J; g on yhteensä luku elämäkerrat ja lopuksi d F3 osoittaa, kuinka monta biographis on löytynyt tuolloin.
On huomattava, että vain koulutus elämäkerrat edistää rakentamista termien sanakirjaa edustavat kaikki elämäkerrat. Eli kun luokittelija tarkistaa uusia elämäkertoja testiosajoukko,
Taulukko 5.2: Esimerkki termi elämäkerta matriisi, jossa wi j edustaa merkitystä ja termejä i elämäkerrallinen sisäänkäynti J.
Sanakirja elämäkerta 1 Elämäkerta 2... Elämäkerta
Yliopisto W11 w12. Avioliitto ja M21, F9) Kirjailija Wm1 Wm2.
quier termiä, joka ei löydy elämäkerrat koulutus asettaa ei oteta huomioon laskettaessa etäisyydeltä. Tutkimuksessamme ei myöskään tarkasteltu synonyymejä ja lyhenteitä tai vaihtoehtoisia muotoja tietylle termille.
5.3.4 Tulokset
Tässä esitetään tulokset kokeista, joissa vertaillaan eri strategioita sukupuolten tasa-arvon tunnistamiseksi teksteissä. Kunkin luokitusalgoritmin kokeiluihin kuuluu kymmenen koetta atsarassa valituista koeosastoista.Tutkimustulosten tueksi olemme tehneet testejä Wilcoxon Hollander et al. ( 2013 ), kun otetaan huomioon tilastollinen merkitys p-arvoille vähemmän kuin 0, 05.
GSVM vs. normaali AVS
Seuraavissa jaksoissa esitetään yhteenveto tuloksista, jotka on saatu GSVM:n ja vakiomuotoisen VMS:n vertailusta sukupuolten tasa-arvon tunnistamisessa.
Iteraatioiden lukumäärä: GSVM vs. standardi AVS
Taulukko 5.3 Iteraatioiden vertailu lasketaan GSVM:n ja tyypillisen VMS-järjestelmän osalta käyttäen klassista pysäytyskriteeriä. On selvää, että keskimäärin noin GSVM Espanjan aineisto 18 % (johdannaisilla) ja 25 % (ilman johdannaisia) vähemmän iteraatioita kuin standardissa SVM-lähestymisessä. Samaan aikaan GSVM voi vähentää sen määrä iteraatioita noin 42 % (johdannaisilla) ja 44 % (ilman johdannaisia). GSVM:n standardipoikkeaman suuret arvot ovat seurausta siitä, että molemmat lähestymistavat saavuttavat yhtä suuren iteraatiomäärän, joka on määritelty joillekin kokeille, ja ymmärtävät, kuinka monta iteraatiota on määritetty tällä mallilla.
Wilcoxonin testi englanniksi saatavilla olevasta aineistosta osoittaa, että GSVM parani suhteessa LVMN:ään oli tilastollisesti merkitsevä sekä sovellettuna että korkealla tasolla.
c-lähtö (p = arvo) 0,00195 ) ikään kuin sitä ei olisi sovellettu (p = 0,00589 ). Jos tarkastelemme tapausta Espanjan elämäkerrat, tämä parannus on tilastollisesti merkittävä, jos pois lukien (p = arvo 0,00195 ) mutta ei ole merkittävä, kun käytetään reduction (p-arvo = 0,1 ).
Taulukko 5.3: Iteraatiomäärän keskiarvo (tanssiaiset) ja keskihajonta koulutusvaiheissa
Language Method Semming Ei vaiheita
avg. s.d. p-arvo vg.a. p-arvot
espanja 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
English SVM 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
Luvut 5.3 a, 5.3 b. 5.4 a ja 5.4 b on osoitettu graafisesti kunkin kokeen osalta, missä määrin GSVM:n ja AVS:n vakioitujen iteraatioiden määrä lopettaa niiden harjoittelun. GSVM-pysäytyskriteeri havaitsee, kuinka pian virhetasoindikaattori vakautetaan (tippi). Klassinen SVM-säilöönottokriteeri edellyttää sen sijaan, että yhä useammat iteraatiot lopetetaan ilman, että virhetaso on parantunut.
On syytä korostaa, että GSVM:n pysäkkikriteerin käyttö englanninkielisille elämäkerroksille on samanlaista riippumatta siitä, sovellettiinko lematisoinnin esikäsittelyä (ks. kuvat). 5.3 b ja 5.4 b) Toinen merkittävä havainto on, että virheaste elämäkerrat espanjaksi (ks. kuvat) 5.3 a ja 5.4 a) Laajenna värähtelykuviota sovellettaessa esikäsittelyä (kuva). 5.4 a) Tämä menettely voi johtua siitä, että siirtotoimessa on tällä kielellä otettu käyttöön huomattavat tiedot.
Lopuksi on syytä mainita, että arviointimittarit ovat kaikissa tapauksissa hyvin samanlaiset "feminiinien" ja (urosten) tuotantomerkintöjen osalta, joilla on molemmat kielet.
GSVM:n ja standardi SVM:n tarkkuuden vertailu
Arvioidaksemme standardin SVM tekniikka GOVM. olemme seuranneet tarkkuus, takaisinkutsu ja pisteet metrit F1 Baeza-Yates & Ribeiro ( 2011 ); Sokolova ja Lapalme ( 2009 ); Olson ja Delen ( 2008 ). Taulukko 5.4 osoittaa vertailun SVM ja GLVM. elämäkerrat Englanti kanssa tai ilman johtaminen. Kunkin menetelmän ja metrisen taulukon keskiarvo (avg.) keskihajonta [s.d.] Myös p-arvo Wilcoxon testin kunkin vertailun osalta on esitetty. Wilcoxon-testin tulokset osoittavat, että yhdelläkään tarkastellulla metrillä ei ole tilastollisesti merkitseviä eroja, koska ja miten se on ilmoitettu p-arvo-sarakkeessa, jossa kaikki arvot ovat olleet korkeampia kuin 0,05.
a) espanja
b) Englannin kieli
Kuva 5.3: Ei johdantoja. Säilöönottokriteerien vertailu, jos et käytä esikäsittelyä.
Taulukoissa esitetyt tulokset 5.4 sekä 5.5 on osoitettu empiirisesti, että GSVM:n tekniikoilla on samat ominaisuudet kuin LVM-menetelmillä, ja ne tarjoavat samanlaiset tarkkuustulokset.
Taulukko 5.5 osoittaa vertailun SVM ja GSM. Espanjan elämäkerrat kanssa tai ilman johtuminen. Taas kerran kunkin menetelmän ja metrisen taulukon keskiarvo (avg.) keskihajonta [s.d.] sekä vastaavat p-arvot Wilcoxon's Test Samoin kuin elämäkerrat englanniksi, Wilcoxon testitulokset osoittavat, että tilastollisesti merkittäviä eroja ei ole kummallekaan metrille (p-arvot ovat olleet korkeampia kuin 0.05 ). Niin he...
a) espanja
b) Englannin kieli
Kuva 5.4 Säilöönoton perusteiden vertailu käsittelyn esikäsittelyn yhteydessä.
Taulukko 5.4: Englanti. SVM ja GLVM. performance technologies for biographies englanniksi, kanssa tai ilman johtaminen.
Varsi. Sukupuolimenetelmä Tarkkuus Palautus F1-pistemäärä
(s.d.) p-arvo avg
Ei naisen SVM 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
Mies SVM 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Kyllä Naisen SVM 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
Mies SVM 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
GSVM:n saavuttamalla iteraatiomäärällä ei ole vaikutusta tarkkuuteen ja
luokitus.
Taulukko 5.5 Espanjaa. SVM ja GLVM. suorituskyky teknologiat elämäkerrat espanjaksi, kanssa tai ilman johtuminen.
Varsi. Sukupuolimenetelmä Tarkkuus Palautus F1-pistemäärä
(s.d.) p-arvo avg
Ei naisen SVM 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
Mies SVM 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Kyllä Naisen SVM 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Mies SVM 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Taulukko 5.6 näyte GSVM:n osalta vertailu johdannaisen ja johdannaisen välillä ja vastaavat p-arvot. Espanjalaisten biografioiden osalta tulokset osoittavat merkittävää hajoamista, kun mukaan lasketaan p-arvot, joiden mukaan 0, 0097, 0, 00586 sekä 0, 00195 tarkkuuden, takaisinkutsun ja F1-pisteet vastaavasti naisten tyylilajit. 0, 0137, 0, 00195 sekä 0, 00195 tarkkuus, takaisinkutsu ja F1 pisteet vastaavasti miesten genreissä. Sen sijaan, elämäkerrat Englanti p-arvot kaikki mittarit ylittävät niiden taso ja 0,05 Se viittaa siihen, ettei sillä ole merkittävää vaikutusta.
Taulukko 5.6: Johtokykymittareiden vertailu verrattuna johdannaiseen GSVM:n soveltamisessa.
Kieli Sukupuoli Varsi Precision Remight F1 pisteet
avg. p-arvo aw.p-arvostin siivet.ct
Espanjan naisen numero 0,909 0,0097 0,907 0,00586 0,903 0,00195 Kyllä 0,770 0,781 0,747
Mies nro 0,889 0,0137 0,913 0,00195 0,891 0,00195 Kyllä 0,724 0,790 0,713
Finnish Nainen Ei 0,908 0,343 0,859 0,124 0,879 1 Kyllä 0,880 0,898 0,888
Mies nro 0,823 0,108 0,909 0,286 0,843 0,636 Kyllä 0,899 0,884 0,891
GSVM vs. muut algoritmit
Tässä alakohdassa verrataan GSVM:n suoritus- ja koulutusaikaa muihin autooppimismenetelmiin, kuten Random Forests (RF) Breimaniin. 2001 ) ja Boosting Schapire ( 1990 ), yhteisistä kirjakaupoista. Näissä testeissä algoritmi hyperparametrit asetetaan niiden oletusarvoihin. Kullekin algoritmille ja kielelle vertaamme kahta vaihtoehtoista tekstinlouhintatyönkulkua jokaisen mittarin osalta: (i) niissä on poikkeamavaihe, kuten useimmissa perinteisissä tekstisovelluksissa. Käytämme aikaa mittarina.
Vertailu, koska iterointilaskelmia ei ole vertailtu oikeudenmukaisesti kunkin menetelmän täytäntöönpanoon eri iterointia koskevan lähestymistavan mukaisesti.
Koulutusajan vertailu: GSVM vs. muut algoritmit
Taulukko 5.7 summaa ajoaika (sekunteina) kaikista tämän tutkimuksen yhteydessä käytetyistä algoritmeista. Espanjan GSVM:n käyttö on keskimäärin korkeampi 10,05 kertaa nopeammin kuin Boosting ja 42,87 joskus nopeampi kuin RF, kun taas Englanti kieli GSVM on keskimäärin korkeampi 15,79 kertaa nopeammin kuin Boosting ja 59,15 kertaa nopeammin kuin RF. Kun johdantoa ei sovelleta, GSVM on keskiarvoa korkeampi 49,63 kertaa nopeammin kuin Boosting ja 81,00 kertaa nopeammin kuin RF. GSVM on keskiarvo 22,91 kertaa nopeammin kuin Boosting ja 77,70 kertaa nopeammin kuin RF. Yhteenvetona voidaan todeta, että Wilcoxon-testin ja menetelmien tilastollisesti merkitsevän eron perusteella GSVM:n koulutusaika on johdonmukaisesti lyhyempi kuin muiden teknologioiden.
Taulukko 5.7: koulutusajan keskiarvo ja keskihajonta [s.d.]
Language Method Semming Ei vaiheita
avg. (s.d.) p-arvo apr.tit
Espanjalainen GSVM 3,096 ( 0,460 ) 2,889 ( 0,150 ) Tehostaminen 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
Espanjalainen GSVM 3,799 ( 0,074 ) 3,883 ( 0,525 ) Tehostaminen 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
Tarkkuuden vertailu: GSVM vs. muut algoritmit
Koska johtuminen ei näytä olevan merkittävää käsittely elämäkertoja Englanti, avaruus syistä keskitämme analyysimme hänen ja hänen espanja. Taulukko 5.8 osoittaa johdannaisvertailun johdannaiseen verrattuna ja vastaavat p-arvot GSVM:lle, Boostingille tai Satunnaismetsälle. GSVM saa erittäin lupaavia tuloksia, varsinkin kun johdatusta ei käytetä tarkasti ja takaisin. F1-pistemäärä edellä 90 % Useimmissa tapauksissa Boosting ja Random Forest parantavat pääasiassa GSVM-suorituskykyä. Se, että molemmat teknologiat kuuluvat kokonaisiin menetelmiin (Sagi ja Rokach, 2018 ). Kouluttamalla useita malleja ja integroimalla niiden ennustukset nämä menetelmät parantavat yhden mallin ennustavaa suorituskykyä. On huomattava, että koska GSVM käyttäytyy standardilla MVS:llä tarkasti, nämä tulokset osoittavat, että on tärkeää ja tärkeää, että ne johtavat muusta kuin Espanjan kielestä kielille. Tämä esikäsittelytekniikka myös
vaikuttaa tuloksiin, jotka on saatava käyttämällä muuntyyppisiä luokittimia.
Myös tämän taulukon p-arvot 5.8 osoittaa kaikkien algoritmien suorituskyvyn merkitsevän heikentymisen, kun käytetään johdantoa. Tulokset osoittavat johdonmukaisesti, että espanjan, ilman johdantoa ja tarkkuutta F1 pisteet ovat olleet korkeampia kuin 90 % Useimmissa tapauksissa, kun käytetään johdusta, tapahtuu hajoamisen pyöristys. 15 %.
Taulukko 5.8: Tarkkuus tekniikoita biografioiden menetelmiä espanjaksi.
Menetelmä Sukupuoli Kanta Tarkkuus Palautus F1 pisteet
(s.d.) p-arvo avg
GSVM Naisen numero 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 Kyllä 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Mies nro 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 Kyllä 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Nainen ei 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 Kyllä 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
Mies nro 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 Kyllä 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF Nainen 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 Kyllä 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
Mies nro 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 Kyllä 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 Päätelmät
Tässä jaksossa pohdimme joitakin selityksiä sukupuolten tunnistamisessa havaittuihin eroihin ja pohdimme työmme mahdollisia rajoituksia.
5.4.1 Luokitusalgoritmien vertailu
Tulokset viittaavat siihen, että Stemmingin sovelluksen seuraaminen tekstitietojen tuottamisessa, suorituskykymittarit ovat melko samanlaisia riippumatta luokitteluun valitusta autooppimisalgoritmista. Käytäntöjen välillä on kuitenkin eroja.
Tämän seurauksena voimme päätellä, että algoritmit sukupuolitunnisteiden automaattisessa oppimisessa voivat vaikuttaa suoraan algoritmin kouluttamisessa käytettäviin tietokantoihin sisältyviin sufikseihin. Tulokset vahvistavat, että Stemmingin esikäsittely, menetelmä, joka ilmeisesti yksinkertaistaa luokitteluongelmaa, voi aiheuttaa sukupuolisekaannusta tämän ongelman ratkaisemiseksi.
5.4.2 Stemmingin poiston vaikutus
Ehdotetun kehyksen keskeisenä tavoitteena on selvittää, voivatko sukupuolitietojen säilyttäminen ja seuranta joillakin kielillä, kuten espanjalla, parantaa sukupuolitunnisteiden luokittelua. Taulukoissa esitettyjen tulosten mukaan 5.6 sekä 5.8, on melko huomattava kasvu Espanjan luokitus suorituskykyä algoritmeja, että olemme harkinneet meidän kokeiluja, kun deduction kulkee pois datan tuotannosta.
Sen sijaan tulokset Englanti kieli osoittaa vähintään vaihtelu F1 pisteet metri välillä Semming ja ei-Scentering soveltamalla tai valmistelemalla tietoja tahansa luokittelun algoritmi. Tällä kielellä on samanlaiset tulokset, jotka koskevat palautuksen tarkkuutta ja suorituskykyä mittaavia mittareita.
Kaiken kaikkiaan nämä tulokset tukevat alustavaa näkemystämme siitä, että Stemmingin täytäntöönpanon välttäminen voi vaikuttaa myönteisesti sukupuolten tunnistamiseen teksteissä Kun sisältöä on saatavilla kielillä, jotka tarjoavat lisää morfologisia yksityiskohtia sukupuolitiedotuksesta, kuten espanjasta. Aiemmista tutkimuksista saadun tiedon vahvistaminen tietojen tuotantovaiheen merkityksestä, erityisesti jos käytetään muita kieliä kuin Uysal ja Gunto ( 2014 ).
5.4.3 Rajoitukset
Uusi GSVM-menetelmä, jossa otetaan käyttöön koulutusvaiheen keskeyttämiskriteeri, toimii hyvin, ja siihen liittyy erityinen ongelma, joka liittyy sukupuolten tasa-arvon tunnistamiseen teksteissä. Sen vuoksi olisi tehtävä lisäkokeita, joilla arvioidaan GSVM:n suorituskykyä muissa luokitustehtävissä, ennen kuin suositellaan MSSG:n käyttöä VMS:n yleisenä metodologisena innovaationa automaattisen oppimisen avulla.
Sukupuolitekstien tunnistamista koskevan ehdotetun kehyksen osalta kokeellisen toimintaympäristömme merkittävä rajoitus on se, että olemme rajoittaneet sukupuolten tasa-arvoa koskevaa tavoitetta, jota voidaan muuttaa binäärivalinnalla. Muiden Hamidi et al. ( 2018 ); Keyes ( 2018 ). Löysitkö sen? 55 / 58 Tutkimukset, jotka koskevat sukupuolien automaattista tunnistamista autooppimisella, oletettiin binääriseksi geneeriseksi tuotokseksi. Tässä mielessä, mahdollinen polku tulevaisuuden tutkimus voisi olla korvata binary luokittelun algoritmeja vaihtoehtoinen, koska ne ovat voineet olla automaattisia oppimismalleja, jotka myöntävät jatkuvia ja / tai multitilaarisia tavoitteita. Tällaisissa yhteyksissä olisi mielenkiintoista arvioida, onko sukupuolisidoksista vielä hyötyä lajityyppien tunnistamisessa.
Lähestymistapaamme rajoittaa myös se, että tekstiä ei välttämättä ole saatavilla voimakkaasti tulehtuneella kielellä, joka on erilainen kuin englanti. Tällöin teksti voitaisiin kuitenkin kääntää automaattisesti espanjasta venäjälle tai muille samankaltaisille kielille automatisoiduilla palveluilla. Tekstin käännetty versio voi tarjota sukupuolitietoja, joiden avulla voidaan optimoida luokituksen suorituskykyä. Samoin tarvitaan lisää tutkimusta sen varmistamiseksi, että espanjaa ja englantia vertailevat alustavat tulokset ovat toistettavissa vaihtoehtoisille kielille annettavien tietojen kanssa.
5.4.4 Innovaatiot
Tässä tutkimuksessa meillä on uusi stop kriteeri tukea vektori optimointi algoritmeja perustuu geometrisiin ominaisuuksiin tekstisisällön vektorillinen edustus tavoitteena ratkaista automatisoitu sukupuoli tunnistus ongelma. Tämän erityisen ongelman, osoitamme, että ehdotettu algoritmi vaatii vähemmän aikaa koulutukseen verrattuna soveltamalla standardi SVM algoritmit. Mitä tulee kehykseen, sen sijaan, että noudatamme perinteisiä normalisointimenettelyjä tekstien kaivostoiminnassa, jotka poistavat sukupuolihaasteita, kuten lähetteen, säilytämme nämä morfologiset tekijät, jotka on löydetty voimakkaasti aiheutetuilla kielillä ja ovat ne optimoineet suorituskykyään. Arvioimme, miten tehokkaasti tämä uusi lähestymistapa voidaan sisällyttää koulutusaikaan vertailemalla eri autooppimisalgoritmeja luokitteluun käyttäen elämänkertaa. DATASET-TH-001 Ja espanjaa.
Tulostemme perusteella voidaan päätellä, että tekstin esikäsittelyyn ei saa siirtyä, vaan siihen on sisällytettävä myös sukupuolitietoja, kuten espanjaa ja niin edelleen. Tämä menettelymuutos ei vaikuttanut muihin puolueettomiin kieliin kuin englantiin.