Tilgængeligheden af store og rige tekstmæssige datasæt, skabt hovedsagelig fra web-indhold har været en vigtig faktor i data minedrift med algoritmer eller autolearning metoder til hidtil uset priser. Det har skabt en høj interesse i forskning af automatisk læring til tekstanalyse Aggarwal ( 2018 ). I dag, tekst minedrift Srivastava og Sahami ( 2009 ) og behandling af naturligt sprog (PLN) Eisenstein 2019 ) danner grundlag for mange af disse undersøgelser og implementeringer.
5.1 Indledning
DATASET-TH-001 Vrandeňci România og Krötzsch ( 2014 ) er et eksempel på en struktureret og gratis adgang datakilde, der bygger på oplysninger fra DATASET-TH-001 på flere sprog. De oplysninger, der er indhentet i medfør af artiklerne i DATASET-TH-001 har gennemgået en semantisk notationsproces for at udvide videngrundlaget for DATASET-TH-001 efter en grafisk struktureret datamodel for at integrere nye applikationer.
Et af disse områder er kønsidentifikation i teksten. Formålet er at tildele et kønsmærke (f.eks. "feminin og han) til et tekstområde ved hjælp af sproglige egenskaber eller andre beskrivende egenskaber. Generelt har tidligere forskning fokuseret på at identificere køn og profil for en person, der skriver sin tekst. Nogle eksempler omfatter kønsidentifikation af Yan og Y blogs forfattere ( 2006 ) og mikroblogging
Mukherjee og Bala ( 2017 ) eller til brugere af klientrelationsstyringssystemer (CRM) Amado et al. 2018 ).
Skabelse af nye input fra DATASET-TH-001 og strukturerede data i artiklerne i DATASET-TH-001 at fuldføre alle emner. For eksempel, hvis vi skal komme tilbage strukturerede data om "Gabriel García Márquez og har været DATASET-TH-001 den tilsvarende angivelse 2. Derefter kan vi udforske flere områder med beskrivende karakteristika om denne person, herunder "køn eller køn. 3. I dette eksempel, værdien af denne egenskab er "mandlige. På tidspunktet for at skrive denne artikel, hvor præcis information kan være 6 henvisning til forskellige artikler i DATASET-TH-001 der støtter dekoncentreringen af "male.a
Dette felt anvender strukturerede data. Ikke desto mindre som et åbent projekt for samarbejde skabelse af viden DATASET-TH-001 ofte har lidt hærværk og angreb med Adler et al. ( 2011 ); Geiger og Ribes ( 2010 ). Hvis ondsindede agenter har ændret de oprindelige strukturerede data fra DATASET-TH-001, at opdage fejl uden en manuel inspektion ville være en kompleks opgave og mere så i betragtning af den store størrelse af sin database DATASET-TH-001. Også, hvis der ikke er struktureret information om køn i en artikel i DATASET-TH-001, ville det være umuligt at tildele en værdi direkte til "køn eller køn" ejendom for sin indrejse i DATASET-TH-001 Disse oplysninger forelægges Kommissionen på dens første møde. I stedet for at mærke kønsinformation som en automatisk analyse af tekstdata, der er blevet ustruktureret i kroppen fra DATASET-TH-001 Det kunne forbedre modstandsdygtigheden over for disse udfordringer. Dette eksempel kan nemt ekstrapoleres til ethvert andet informationssystem, der automatisk bør mærke indholdet af en tekstblok med et kønstegn.
Vi fokuserede på et specifikt tilfælde, problemet med automatisk at bestemme hans eller hendes køn som beskrevet i biografisk tekst. For resten af dette arbejde vil vi drøfte dette problem som en kønsidentifikation. Manglen på undersøgelser, der omfatter andre sprog end engelsk, gør det vanskeligt at udvikle nye tekstudvindingsprocedurer med henblik på bedre at løse dette problem. I stedet for udelukkende at fokusere på engelsk, med færre kønsaspekter har vi set på at bruge spansk tekst til at fange morfolodier, der bærer information om kønsdele og er mere almindelige på dette sprog. For at opnå dette vil vi undgå regelmæssige normaliseringstrin i udvindingen af traditionelle tekster såsom derivater og Eisensteins lematisering ( 2019 ), da de udelukker information om kønsaspektet i sproglig forstand. Efter denne tilgang har vi vist, at der kan tildeles en kønsbestemt værdi til tekstindhold med mere præcision.
Når du behandler tekst ved hjælp af automatisk læring teknologier, er det normalt nyttigt.
2 [LINK-REDACTED] 3 [LINK-REDACTED]
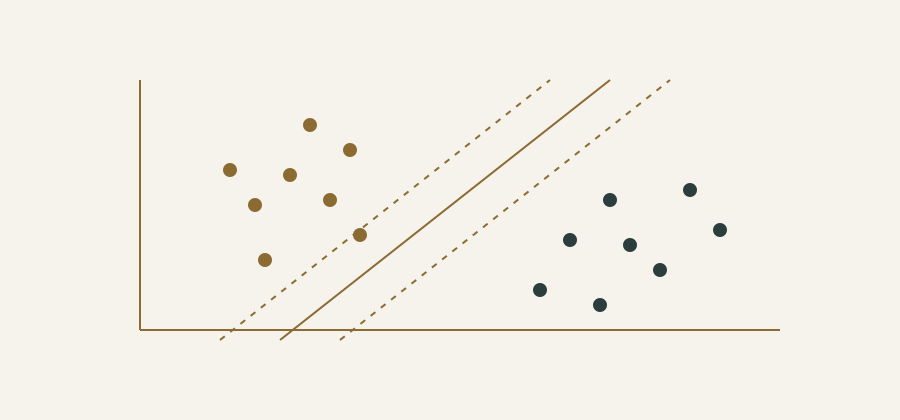
At udføre vektorpræstationer med høj dimensional og spredning, da de indeholder mange komponenter af nul værdi. I et miljø af spredning high- dimensional repræsentationer, Moguerza et al. (SVM) 2006 ) er computeregnet Jocachims ( 2002 ). Ikke desto mindre er tilpasningen af de traditionelle teknologier til optimering af problemløsning for SVM Joachims ( 1999 ), der anvendes til kønsidentifikation, garanterer ikke en hurtig konvergens, da iterationen nærmer sig en optimal løsning på sit underliggende optimeringsproblem.
5.2 Forslag
I dette afsnit, som en del af SVM-rammen, bruger vi geometriske egenskaber fra en tekst køn identifikation opgave til at ændre en underliggende optimering algoritme stop kriterium ved at erstatte Karush- Kuhn- Tucker Feng og Li ( 2018 ) ved et nyt forslag, der indeholder oplysninger (fejlprocent] Det er ikke direkte relateret matematisk med et kriterium, som klassisk optimering SVM algoritme forsøger at opfylde, da det potentielt kan tilpasse sin karakter og geometriske problem løsning. For at evaluere resultaterne af denne nye metode sammenlignes disse forslag med andre overvågningsmetoder ( 2017 ) til automatiseret kønsidentifikation inden for biografiske tekster af litterære forfattere uddraget fra DATASET-TH-001. Det vil blive vurderet, om at undgå den fælles passage af lematisering i tekst minedrift, som fjerner køn sufits med ord, der er vigtige for tekstanalyse og forbedrer ydeevne på kønsidentifikation. GSVM-metodens effektivitet til accelerering af træningsfasen for en algoritme er også vist og viser, at denne metode ikke i væsentlig grad påvirker procedurens ydeevne.
5.2.1 Geometrisk stopkriterium
Geometrien for SVM-beslutningsfunktionen i forbindelse med træningsdata kan kvantificeres inden for hver iteration ved at måle eller estimere fejlfrekvensen. Det vil sige, at når denne fejlprocent stabiliserer beslutningsfunktionen, opfylder disse kriterier for en effektiv klassificering af data. Tallet 5.1 viser et eksempel med to multidimensionelle Gaussiske skyer. Udførelse af en SVM op til iteration 2 produktion af den i figuren repræsenterede skilleflade 5.1 et stykke tid Figur 5.1 b viser separationsområdet beregnet op til iteration 18. Tallets beslutningsfunktion 5.1 a giver den samme empiriske fejl som figur beslutning funktion 5.1 b, der krævede flere iterationer og
Således mere uddannelse tid til sin konstruktion. I stedet for at opbygge beslutningsfunktionen i tal 5.1 a Han havde brug for mindre træning iterationer.
a) SVM køre indtil iteration 2 b) SVM køre indtil iteration 18
Figur 5.1 To adskillelsesoverflader med SVM: a) frihøjde opnået efter 2 b) udskillelsesområde beregnet efter 18 Det er det, der er sket.
Baseret på disse fundamenter, vi definerer εk som fejlfrekvensen for uddannelse sat på iteration K og ∞ > 0 som en sand værdi, der handler med tolerance. Ifølge ( 2.3 ),
N X
εk = 1
g
i = 1 ( 1 − yi f (xi) og 5.1 )
Sea δk = ∞ 124; εks − httg ~ 5 |. Metoden standses efter overholdelse af følgende:
(δk ≤ ∞) 5 {pos ()} 15 {pos (g)} 100 ε), ( 5.2 )
hvis symbolet ")" betegner en logisk operatør, og det vil sige med alle fire uligheder inden for sit kriterium bør være opfyldt samtidig. Ved at måle forskellen δk ≤ ∞ hver femte iteration og slappe af et klassisk kriterium, kan vi undgå uønskede toppe af fejl forårsaget af tilfældighed. Følgende sætning viser, at der er en direkte forbindelse mellem kriterierne for frihedsberøvelse ( 2.12 ) og 5.2 ).
TheoremaCity in Italy 2. Dada ∞ > 0 og ∞ > 0 ), er der en række af iteration kť og β såsom δk ≤ ∞ y m (βg.
Bevis. Til Corollarus 1.1, det hævdes, at:
L ″ ‡ m k →
m (βk) − M [β ks] = 0
Således er der en række iteration kΩ sådan, at dvs k > Kīer opfyldt:
m (β k) − M og g.
Være vektor β • problemløsning ( 2.5 ), når der er tale om fysiske personer som f. eks. 0 er såkaldte supportvektorer. Det er velkendt, at funktionen f * *, som bestemmer beslutningsprocessen overflade g {(x) = 0 Tag form af:
N X
f · (x) =
i = 1 β = (xi, x) + b * 5.3 )
med
b * * * * 1 β = (xi, x +)
2 + pn i = 1 β < β * i iK (xi, x −)
2,
hvor x + og x − er to supportvektorer i klasser mere 1 og 1 som deres associerede β + og ″ − Ligrange multiplikator har været 0 < β + {C} og 0 < β − > C
Lad os se på den beslutningstagende funktion, der er bestemt af dette problem ( 2.5 ), ved iteration k:
N X
f k (x) =
i = 1 β k i yik (xi, x) + bg.
Det er let at bevise, at, ″ γ > 0, der er en kloe iteration nummer såsom.k > qy:
g k (x) − f * 5.4 )
Det er på grund af teorema. 1 Det betyder, at:
L ″ ‡ m k → ∞ β g = ß ·,
og således at 0 Der er en række iteration kv sådan, at, nemlig k > q. det er opfyldt, at:
β k − α ″ ≤ v.
Hvis vi tager og hvor lille, ( 5.4 ) opfyldes for kγ = k. Dada ∞ > 0, hvis vi har og er små nok til ( 5.4 ), og k > kγ med definitionen ( 5.1 ), er den overbevist om, at:
(pos. 192,240 )} 5 | ≤τ,
og teorema er gyldig for kΩ, β = m ″ ax {g- q.a.).
□
Da kriteriet ( 5.2 ) er afhængig af fejlprocenten, er det intuitivt at sætte en værdi for ∞. Vi kan sige det, for eksempel med a) = 0,0005 som fejlprocent op til 0,05 % kan anses for at være betydeligt lav. Denne intuition eksisterer ikke for kriteriet ( 2.12 ), fordi størrelsen af g (β) ikke kan vurderes på forhånd. Afdeling 5.3 Vi har vist, at der i forbindelse med det særlige tilfælde af kønsbestemt identifikation i teksterne kan findes og opfyldes et passende generelt beslutningsområde ( 5.2 ) i betydeligt mindre iterationer end krævet for at opfylde det almindeligt anvendte teoretiske kriterium ( 2.12 ). Det centrale punkt er det højdimensionelle miljø, hvor teksten var repræsenteret, hvilket gør det muligt hurtigt at opnå en god empirisk generalisering. Fra et empirisk synspunkt forventes GSVM således at arve generaliseringsegenskaberne for LVM.
5.3 Eksperimenter
I dette afsnit beskriver vi i detaljer problemet med kønsidentifikation og hvordan eksperimenter iværksættes.
5.3.1 Problemet
Problemet med kønsidentifikation i tekstdata som en overvågning af uddannelse klassificering opgave udfordringer. På grund af en tekstblok, der kan mærkes med en persons kønsmærkning, bør algoritmen automatisk indskrive dette mærke. I dette tilfælde overvejer vi to potentielle outputetiketter: L = ("feminin og han), da vores eksperimentelle datasæt kun indeholder eksempler på disse to kønsklasser. 5.3.3. Således begrænser vi vores valg af algoritmer til dem, der er orienteret ved binær klassificering. Den samme fremgangsmåde kunne udvides til at omfatte yderligere outputetiketter og omformulere problemet som en opgave med at klassificere en mod alle eller flere tags.
Vores arbejdsramme adskiller sig fra tidligere tilgange med to udfordringer.
3 ).
Selv om tidligere job er blevet efterfulgt af traditionelle tekstudvindingsprocedurer, såsom afledning, undgår vi bevidst dette skridt til at bevare kønssufix i termer og undersøge dets indvirkning på kønsidentifikation for tekster med en stærk tipning af ord som spansk.
I stedet for at mærke en enhed sekvens med et navn i tekst, vi løse problemet med at tildele A Køn Label til en tekstblok eller komplet dokument beskriver en anden person. Det er et vigtigt problem for mange applikationer, herunder automatisk indtastning notation i semantiske databaser.
Der er mange sprog, der har været flexing, hvilket betyder ord kan ændre deres form til at afspejle grammatik information som antal og tid eller køn Hedlund et al. ( 2001 ). På spansk, ord, der slutter på. eller i en konsonant betegner mandlige genrer, mens dem med en "er hovedsagelig feminine. leminiseringen forsøger at fjerne forskelle mellem de flexing former af et ord og reducere hver ord i sin rodform. Denne forbehandling har været standardmetoden til tekstminedrift og informationsinddrivelse for bedre at kunne identificere nøglebegreber med en given meddelelse.
Ikke desto mindre, som nævnt tidligere på spansk hyperspsis af mange ord kan være en nyttig og direkte indikator for køn. Det er derfor, det synes rimeligt at antage, at hvis vi ikke anvender lematisering og bevare køn sufikser i stedet, de kan forbedre nøjagtigheden af deres kønsidentifikation. Følgende strategi for identifikation af kønstekster foreslås:
1. Implementere standard tekst mining procedurer til at forberede en ubehandlet input, herunder toxization og tom ord bortskaffelse (yderligere gennemførelsesdetaljer er angivet i afsnit 5.3 ).
2. Forud for oprettelsen af vektor repræsentation for hvert dokument, konventionelle tekst mining metoder tyder på, at nogle Sproat et al. ( 2001 ), såsom lematisering for at fjerne flexing udfordringer og give en typisk repræsentation af lignende ord samtidig reducere ordforråd størrelse. I stedet foreslår vi at undertrykke dette trin i normaliseringen af teksten og i stedet bevare flexative sufikser, der indeholder yderligere oplysninger om køn på specifikke sprog.
3. Derefter gen- vælge standard dokument produktionsproces, generere en vektor repræsentation af hvert papir og opbygge et udtryk - brev matrix (igen flere detaljer er givet i afsnittet). 5.3 ).
Denne strategi gælder for produktion af tekstdata, der skal uddanne en autolæringsalgoritme til kønsidentifikation. For at bevise denne procedures anvendelighed i et faktisk miljø har vi designet en række til at udføre valideringsforsøg, og disse er beskrevet som følger.
5.3.2 Indstil forsøg
Hovedmålet er at evaluere kapaciteten i vores foreslåede rammer for automatisk kønsidentifikation i forbindelse med realverdens tekstdokumenter. Til dette formål har vi genvundet biografiske artikler, der beskriver litterære forfattere fra den spanske og engelske udgave af DATASET-TH-001 og dens data fodre andre systemer baseret på semantisk viden som DATASET-TH-001. Der er således skabt to forskellige datasæt og et for hvert sprog. Vi har designet vores datasæt til at sikre en lige repræsentation af begge etiketter på biografiske input valgt til hans og hendes spanske eksperimenter.
Når vi anvender vores procedure som en indgangstekst på både spansk og engelsk, sigter vi mod at bekræfte, om det har en positiv indvirkning på din kønsidentifikation. Vores udvalgte datasæt var biografier af mandlige og kvindelige forfattere. Dette valg giver os mulighed for at ramme eksperimentet som en binær klassificering problem, som der er flere standard autolearning algoritmer. Tallet 5.2 viser en generel beskrivelse af forsøgsproceduren for vurdering af hver overvåget læringsmetode.
Hvert datasæt af biografier på engelsk og spansk er opdelt i trænings- eller testdelsæt. Nærmere bestemt, 70 % af biografier på hvert sprog bruges til uddannelse, mens 30 % forbliver som en test sæt til at evaluere ydeevnen af overvågede læringsalgoritmer. Følgende afsnit indeholder yderligere oplysninger om nyttiggørelse og produktion af begge datasæt.
5.3.3 Anvendte datasæt
Vi er begyndt, inddrive biografier fra litterære forfattere af DATASET-TH-001 ved at overvåge deres web direkte ved hjælp af pakken DATASET-TH-001 Keyes og Til-
Figur 5.2 En beskrivelse af de foreslåede rammer for afprøvning af alternative overvågningsmetoder.
SOFTWARE-TH-003 ( 2017 ) til rådighed for statistisk miljø R, ORG-TH-112 ( 2022 ). Pakken kan få en liste over sider, underkategorier og sideindhold samt andre oplysninger om en enkelt kategori.
Det offentlige datasæt, der findes i Gomez og al. ( 2021 a) 4 indeholder 1000 biografier af forfattere udtrukket fra DATASET-TH-001 på engelsk. Disse artikler er ligeligt opdelt i en gruppe af kvinder og et array med mænd. De biografier af kvinder er blevet udtrukket fra kategorien "forfattere _ kvinder. 500 sider fra kategorien "forfattere _ mænd] af The 19 Dette århundrede er blevet opnået for menneskets biografier.
Det offentlige datasæt findes på spansk Gomez og al. ( 2021 b)
5 indeholder 832 biografier fra DATASET-TH-001 på spansk. Kvindernes biografier er blevet udtrukket fra kategorien "Spanske forfattere. Tværtimod, først 416 sider fra kategorien "Spansk Forfattere af The 20 Dette århundrede 'er blevet hentet for mænds biografier. Således er disse biografier også opdelt i to undersæt: den ene af kvinder og den anden om mænd.
Tabellen 5.1 opsummerer nogle generelle statistikker fra en indledende sonderende analyse af datasættene på engelsk og spansk som beskrevet ovenfor.
Vi tidligere behandle hver biografi ved hjælp af en R pakke af tekst minedrift tm Feinereer et al. ( 2008 ). At fjerne fra biografier tomme ord (fælles udtryk, der normalt ikke giver nyttige oplysninger til analyse) Eisens-
4 [LINK-REDACTED] 5 [LINK-REDACTED]
Tabel 5.1: Det samlede og gennemsnitlige tal, der beskriver datasæt på både spansk og engelsk.
Datasæt Beskrivelse statistik Værdi
Samlet antal biografier og genomer 500 F.eks. antal forskellige udtryk pr. kvindelig skrive biografi 50,86
F.eks. antal forskellige udtryk pr. kvindelig skrive biografi (iscenesættelse) 38,11
Engelsk
Samlet antal biografier om mandlige forfattere 500 F.eks. antal forskellige udtryk pr. biografi 46,2
F.eks. antal forskellige udtryk pr. mandlig skrive biografi (iscenesættelse) 35,62
Samlet antal biografier og genomer 416 F.eks. antal forskellige udtryk pr. kvindelig skrive biografi 50,03
F.eks. antal forskellige udtryk pr. kvindelig skrive biografi (iscenesættelse) 31,44
Spansk
Samlet antal biografier om mandlige forfattere 416 F.eks. antal forskellige udtryk pr. mandlig skrive biografi 51,39
F.eks. antal forskellige udtryk pr. mandlig skrive biografi (iscenesættelse) 32,68
Tein ( 2019 ), antal og tegn på score med blanke mellemrum. Teksten til hver biografi vil senere blive konverteret til mindre og den relative termbiografi matrix som vist i denne tabel. 5.2. Således kan hvert biografisk sæt være repræsenteret som en m × n matrix og med et N antal biografier i træningspakken. Hvert wij element af term- biografi matrix repræsenterer et vigtigt eller vægt navn for i in g biografi. For at få WI 's værdi bruger vi TF- IDA Aizawa ( 2003 ), beregnet som ( 5.5 ):
!, ( 5.5 )
wi = t fi j × log N
d fi
hvor t fi j angiver antallet af forekomster fra term i i biografi J; g er et samlet tal for biografier og endelig, d F3 angiver, hvor mange biografier der er blevet fundet på det tidspunkt.
Det skal bemærkes, at kun uddannelse biografier bidrage til opbygningen af termer ordbog repræsenterer alle biografier. Det vil sige, når klassifikatoren kontrollerer nye biografier om en test delsæt, der
Tabel 5.2: Eksempel på en termbiografi matrix, hvor wi j repræsenterer betydningen og termer i ved biografisk indgang J.
Ordbogsbiografi 1 Biografi 2... Biografi
University W11 w12... aw1n Ægteskab og M21, F9) Writer wm1 Wm2...
"quier term found not in biographies of the training set" ignoreres for beregning fra afstand. Også, vores undersøgelse ikke overveje synonymer og forkortelser eller alternative former for en given betegnelse.
5.3.4 Resultater
Resultaterne af forsøg, der sammenligner forskellige strategier for kønsidentifikation i tekster, præsenteres her. Eksperimenterne for hver klassificeringsalgoritme omfatter ti forsøg af træningstestdivisioner udvalgt på azar.For at kunne understøtte resultater, har vi udført tests fra Wilcoxon Hollander et al. ( 2013 ), efter at have overvejet den statistiske betydning for p-værdier mindre end 0, 05.
GSVM versus standard AVS
De følgende afsnit opsummerer resultaterne af evaluering af eksperimenter, der sammenligner GSVM med standard FOS i tekst køn identifikation problem.
Sammenligning af iterationer nummer: GSVM versus standard AVS
Tabellen 5.3 Sammenligning af Iterationer tæller for GSVM og en typisk FOS ved hjælp af det klassiske stop-kriterium. Det er klart, at med et gennemsnit på omkring GSVM for det spanske datasæt 18 % (med derivater) og 25 % (uden derivater) mindre iterationer end standard SVM-metoden. Samtidig kan GSVM reducere antallet af iterationer med ca. 42 % (med derivater) og 44 % (uden derivater). De store værdier i standardafvigelsen for GSVM er et resultat af begge tilgange, der når op på så højt et iterationstal defineret til nogle eksperimenter, forstår hvor mange iteration der er blevet etableret med denne model.
Wilcoxon 's test af datasættet på engelsk viser, at GSVM forbedret i forhold til LVMN var statistisk signifikant, både som anvendt og med en høj
ca den oprindelige værdi (p = værdi 0,00195 ), som hvis den ikke blev anvendt (p = 0,00589 ). Hvis vi ser på tilfældet med spanske biografier, denne forbedring er statistisk signifikant, hvis stammende ikke er inkluderet (p = værdi 0,00195 ), men er ikke signifikant, når du bruger stammer (p værdi = 0,1 ).
Tabel 5.3: Gennemsnitlig (prom.) og standardafvigelse af iterationstællingen ved træningsstadier
Sprog Metode Stemping Ingen iscenesættelse
avg. s. d. p- værdi vg.a. p- værdier
Spansk 357,500 10,445 0,1 395,100 10,105 0,00195 GSVM 294,100 89,709 293,000 49,844
Engelsk SVM 612,000 16,855 0,00195 614,600 7,394 0,00589 GSVM 359,000 10,220 349,500 69,100
Tallene 5.3 a. 5.3 b, 5.4 a og 5.4 b er blevet vist grafisk for hvert forsøg på, hvad optælling af GSVM og standard AVS iterations stopper deres træningspræstation. GSVM stop kriteriet registrerer, hvor snart fejlfrekvensen indikator vil blive stabiliseret (tipline). I stedet kræver det klassiske SVM-tilbageholdelseskriterium, at et øget antal iterationer stopper uden at give nogen forbedret fejlprocent.
Det skal understreges, at udførelsen af GSVM 's stop kriterium for biografier på engelsk er ens, uanset om lematisering preprocessing blev anvendt eller ej (se Tal). 5.3 b og 5.4 b) Et andet bemærkelsesværdigt resultat er, at fejlfrekvensen for biografier på spansk (se Tal) 5.3 a og 5.4 a) Udvid et oscillerende mønster ved påføring af afledning forbehandling (figur 5.4 a). Denne adfærd kan skyldes et betydeligt tab af oplysninger som følge af indbringelsen på dette sprog.
Endelig skal det nævnes, at vurderingsmålingerne i alle tilfælde er meget ens for "feminine" og (mandlige) produktionsetiketter på begge sprog.
Sammenligning af GSVM vs. nøjagtighed Standard SVM
For at evaluere ydeevnen af standard SVM teknik med GAVM har vi overvåget præcision, tilbagekaldelse og score målinger F1 Baeza- Yates & Ribeiro ( 2011 ); Sokolova og Lapalme ( 2009 ); Olson og Delen ( 2008 ). Tabellen 5.4 viser en sammenligning af SVM og GLVM for biografier på engelsk med eller uden afledning. For hver metode og metrisk, denne tabel viser gennemsnittet (avg.) med standardafvigelse [s.d.] Også, p- værdien af Wilcoxons test for hver sammenligning er vist. Wilcoxon testresultaterne indikerer, at der ikke er statistisk signifikante forskelle for nogen af de målte værdier, som og hvordan det er angivet i en p- værdi kolonne, hvor alle værdier har været højere end 0,05.
a) Spansk
b) Engelsk
Figur 5.3 Ingen afledning. Sammenligning af detentionskriterier, hvis du ikke bruger henvisning forbehandling.
Resultaterne i tabellerne 5.4 og 5.5 de har vist empirisk, at GSVM 's teknikker med hensyn til kønsidentifikationsproblemer har samme egenskaber som LVMs og giver lignende præcisionsresultater.
Tabellen 5.5 viser en sammenligning af SVM og GSSM. for spanske biografier med eller uden afledning. Igen, for hver metode og metrisk denne tabel viser gennemsnittet (avg.) med standardafvigelse [s.d.] samt de tilsvarende p-værdier af Wilcoxon 's test Tilsvarende med biografier på engelsk, Wilcoxon' s testresultater indikerer, at der ikke er nogen statistisk signifikante forskelle for enten metriske (p- værdier har været højere end 0.05 ). Det er sådan de...
a) Spansk
b) Engelsk
Figur 5.4 Sammenligning af kriterierne for hans eller hendes tilbageholdelse med henvisning til en henvisning forud for behandlingen.
Tabel 5.4: Engelsk. SVM og GLVM. performance technologies for biografier på engelsk, med eller uden afledning.
Stem. Køn Metode Præcision Recall F1 score
(s.d.) p- værdi avg.
Ingen kvindelig SVM 0,919 ( 0,038 ) 0,812 0,873 ( 0,011 ) 0,188 0,895 ( 0,021 ) 0,438 GSVM 0,908 ( 0,039 ) 0,859 ( 0,093 ) 0,879 ( 0,049 )
Mandlig SVM 0,865 ( 0,018 ) 0,63 0,917 ( 0,031 ) 1 0,889 ( 0,014 ) 1 GSVM 0,823 ( 0,205 ) 0,909 ( 0,036 ) 0,843 ( 0,159 )
Ja Kvindelig SVM 0,911 ( 0,044 ) 0,812 0,879 ( 0,018 ) 0,0625 0,894 ( 0,027 ) 0,312 GSVM 0,880 ( 0,049 ) 0,898 ( 0,036 ) 0,888 ( 0,031 )
Mandlig SVM 0,873 ( 0,018 ) 0,125 0,910 ( 0,036 ) 1 0,891 ( 0,017 ) 0,438 GSVM 0,899 ( 0,036 ) 0,884 ( 0,035 ) 0,891 ( 0,020 )
Antallet af iteration opnået ved GSVM har ingen indvirkning på nøjagtigheden og
klassifikationen.
Tabel 5.5 Spansk. SVM og GLVM performance technologies for biografier på spansk, med eller uden afledning.
Stem. Køn Metode Præcision Recall F1 score
(s.d.) p- værdi avg.
Ingen kvindelig SVM 0,929 ( 0,028 ) 1 0,918 ( 0,019 ) 0,0625 0,923 ( 0,014 ) 0,625 GSVM 0,909 ( 0,065 ) 0,907 ( 0,093 ) 0,903 ( 0,042 )
Mandlig SVM 0,913 ( 0,034 ) 0,188 0,929 ( 0,020 ) 1 0,920 ( 0,018 ) 0,188 GSVM 0,889 ( 0,140 ) 0,913 ( 0,057 ) 0,891 ( 0,079 )
Ja Kvindelig SVM 0,751 ( 0,092 ) 0,0625 0,810 ( 0,072 ) 0,0625 0,773 ( 0,040 ) 0,625 GSVM 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Mandlig SVM 0,809 ( 0,115 ) 0,0625 0,768 ( 0,054 ) 0,125 0,780 ( 0,054 ) 0,0625 GSVM 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Tabellen 5.6 prøve for GSVM en sammenligning mellem afledning og ikke-derivat, med de tilsvarende p-værdier. For spanske biografier, resultaterne viser en betydelig nedbrydning, når herunder afledning med p- værdier af 0, 0097, 0, 00586 og 0, 00195 for henholdsvis præcision, tilbagekaldelse og F1 score i kvindelige genrer. 0, 0137, 0, 00195 og 0, 00195 for præcision, tilbagekaldelse og F1 score i mandlige genrer. I stedet for, for biografier på engelsk p værdier af alle målinger overstiger deres niveau og 0,05 Det tyder på, at der ikke er nogen væsentlig virkning.
Tabel 5.6: Sammenligning af resultatmålinger for afledning i forhold til ikke-afledte værdier ved anvendelse af GSVM.
Sprog Køn Stem Præcision Recall F1 score
avg. p- værdi aw.p- værdiansættelseswings.ct
Spansk Kvindenr. 0,909 0,0097 0,907 0,00586 0,903 0,00195 Ja 0,770 0,781 0,747
Mandlig nr. 0,889 0,0137 0,913 0,00195 0,891 0,00195 Ja 0,724 0,790 0,713
Engelsk Kvindenummer 0,908 0,343 0,859 0,124 0,879 1 Ja 0,880 0,898 0,888
Mandlig nr. 0,823 0,108 0,909 0,286 0,843 0,636 Ja 0,899 0,884 0,891
GSVM vs. andre algoritmer
Denne underafdeling sammenligner GSVM 's performance and training time med andre autolearning metoder, såsom Random Forests (RF) Breiman. 2001 ) og Boosting Schapire ( 1990 ), fra fælles software boghandlere. I disse test, algoritme hyperparametre er sat på deres standardværdier. For hver algoritme og sprog, sammenligner vi to alternative tekst minedrift workflows for hver metrisk: (i) de omfatter en afvigelse trin som med de fleste konventionelle sms-applikationer. Vi bruger tid som en metrisk
Sammenligning, da der ikke er nogen rimelig sammenligning af iteration tæller, med hver metode implementering efter en anden iteration tilgang.
Sammenligning af træningstid: GSVM versus andre algoritmer
Tabellen 5.7 opsummere driftstiden (i sekunder) for alle versioner af algoritmer, der anvendes med denne forskning. Brug afledning til spansk, GSVM er i gennemsnit op 10,05 gange hurtigere end Boosting og 42,87 Nogle gange hurtigere end RF, mens for den engelske sprog GSVM er et gennemsnit op 15,79 gange hurtigere end Boosting og 59,15 gange hurtigere end RF. Når afledning ikke gælder, GSVM er som et gennemsnit op 49,63 gange hurtigere end Boosting og 81,00 gange hurtigere end RF. GSVM 'er som et gennemsnit 22,91 gange hurtigere end Boosting og 77,70 gange hurtigere end RF. Sammenfattende viser Wilcoxon-testen og en statistisk signifikant forskel mellem metoderne, at GSVM-træningstiden er konsekvent kortere end i andre teknologier.
Tabel 5.7: gennemsnitlig (avg.) og standardafvigelse [s.d] af træningstiden
Sprog Metode Stemping Ingen iscenesættelse
avg. (s.d.) p- værdi apr.tit
Spansk GSVM 3,096 ( 0,460 ) 2,889 ( 0,150 ) At øge 31,110 ( 1,001 ) 0,002 143,370 ( 289,894 ) 0,002 RF 132,718 ( 46,366 ) 0,002 234,024 ( 71,339 ) 0,002
Spansk GSVM 3,799 ( 0,074 ) 3,883 ( 0,525 ) At øge 59,978 ( 6,650 ) 0,002 88,976 ( 18,596 ) 0,002 RF 224,732 ( 17,882 ) 0,002 301,715 ( 6,568 ) 0,002
Præcision Sammenligning: GSVM versus andre algoritmer
Da afledningen ikke synes at være signifikant med behandling af biografier på engelsk, vil vi af pladsårsager fokusere vores analyse på hans og hendes spanske. Tabellen 5.8 viser en derivation sammenligning versus non-derivat og de tilsvarende p-værdier for GSVM, Boosting eller Random Forest. GSVM får meget lovende resultater, især når afledning ikke bruges med præcision og tilbagekaldelse. F1 score over 90 % I de fleste tilfælde, selv om Boosting og Random Forest primært forbedre GSVM ydeevne. Det forhold, at begge teknologier tilhører dem, der kaldes hele metoder (Sagi og Rokach, 2018 ). Ved at uddanne flere modeller og integrere deres forudsigelser, disse metoder forbedre den prædiktive ydeevne af en enkelt model. Det skal bemærkes, at da GSVM opfører sig med en standard MVS i præcision, viser disse resultater betydningen og relevansen af afledning fra ikke-henvisning til sprog som på spansk niveau. Den forbehandling teknik samt
påvirker de resultater, der skal opnås ved hjælp af andre typer klassifikatorer.
Også p værdier i denne tabel 5.8 vise en betydelig forringelse i ydeevnen af alle algoritmer, når der anvendes afledning. Resultaterne viser konsekvent, at for spanske, uden afledning og nøjagtighed af F1 score har været højere end 90 % i de fleste tilfælde, mens der anvendes afledning en afrunding af nedbrydning. 15 %.
Tabel 5.8: Præcisionsteknologi til biografier metoder på spansk.
Metode Køn Stem Præcision Recall F1 score
(s.d.) p- værdi avg.
GSVM Kvindenr. 0,909 ( 0,065 ) 0,00977 0,907 ( 0,093 ) 0,00586 0,903 ( 0,042 ) 0,00195 Ja 0,770 ( 0,177 ) 0,781 ( 0,139 ) 0,747 ( 0,079 )
Mandlig nr. 0,889 ( 0,140 ) 0,0137 0,913 ( 0,057 ) 0,00195 0,891 ( 0,079 ) 0,00195 Ja 0,724 ( 0,251 ) 0,790 ( 0,105 ) 0,713 ( 0,155 )
Øget kvindenr. 0,944 ( 0,018 ) 0,00195 0,938 ( 0,017 ) 0,00195 0,941 ( 0,012 ) 0,00195 Ja 0,769 ( 0,044 ) 0,694 ( 0,037 ) 0,729 ( 0,022 )
Mandlig nr. 0,936 ( 0,020 ) 0,00195 0,943 ( 0,015 ) 0,00195 0,939 ( 0,011 ) 0,00195 Ja 0,655 ( 0,038 ) 0,736 ( 0,053 ) 0,691 ( 0,027 )
RF Kvindenr. 0,957 ( 0,016 ) 0,00195 0,970 ( 0,022 ) 0,00195 0,963 ( 0,011 ) 0,00195 Ja 0,816 ( 0,046 ) 0,790 ( 0,065 ) 0,800 ( 0,037 )
Mandlig nr. 0,971 ( 0,021 ) 0,00195 0,956 ( 0,020 ) 0,00195 0,963 ( 0,012 ) 0,00195 Ja 0,779 ( 0,066 ) 0,806 ( 0,048 ) 0,789 ( 0,036 )
5.4 Konklusioner
I dette afsnit overvejer vi nogle forklaringer på de forskelle, der er fundet i kønsidentifikationspræstationerne, og disse reflekterer over potentielle begrænsninger i vores arbejde.
5.4.1 Sammenligning af klassifikationsalgoritmer
Resultaterne tyder på, at overvågning Stemming ansøgning i tekstmæssig dataproduktion, performance målinger er helt ens uafhængigt af autolearning algoritme udvalgt til klassificering. Ikke desto mindre er der forskelle afhængigt af det anvendte sprog.
Som et resultat, kan vi konkludere, at autolearning klassificering algoritmer til kønsidentifikation kan være direkte påvirket af sufikser til stede i datasæt, der anvendes til at træne algoritmen. Vores resultater bekræfter, at Stemming 's forbehandling, en metode, der tilsyneladende forenkler klassificeringen problem kan fremkalde kønsforvirring til at løse dette problem.
5.4.2 Virkningen af Stamming Fjernelse
Et hovedmål med den foreslåede ramme er at forklare, om fastholdelse og overvågning med oplysninger om køn på nogle sprog, såsom spansk, kan give en bedre klassificering ydeevne for kønsidentifikation. I henhold til resultaterne i disse tabeller 5.6 og 5.8, Der er en ganske bemærkelsesværdig stigning i spansk rating ydeevne for de algoritmer, som vi har overvejet med vores eksperimenter, når afledning passerer er fjernet fra data produktion.
I stedet, resultater for det engelske sprog indikerer en minimal variation i F1 score metrisk mellem Stemming og non-Scentering anvender eller forbereder data til enhver klassificering algoritme. Dette sprog har lignende resultater med hensyn til tilbagekaldelse nøjagtighed og ydeevne målinger.
Alt i alt understøtter disse resultater vores oprindelige overvejelse af, at det kan påvirke kønsidentifikationen i tekster positivt, hvis indholdet er tilgængeligt med sprog, der giver yderligere morfologiske detaljer, der giver kønsinformation som spansk. Bekræftelse af viden fra tidligere forskning om vigtigheden af dataproduktionsfasen, især hvis arbejde med andre sprog end Uysal og Gunto ( 2014 ).
5.4.3 Restriktioner
Den nye GSVM-metode, der indfører et tidligt stop-kriterium for uddannelsesfasen, fungerer godt med et specifikt problem med identifikation af tekstkøn. Der bør derfor udføres yderligere forsøg for at evaluere GSVM 's ydeevne i andre klassificeringsopgaver, før man anbefaler MSSG som en overordnet metodisk innovation af FOS med automatisk læring.
Hvad angår den foreslåede ramme for identifikation af kønstekster, er en vigtig begrænsning af vores eksperimentelle miljø, at vi har begrænset en målkønsvariabel med binære valg. Problemet rejst af andre Hamidi et al. ( 2018 ); Keyes ( 2018 ). Faktisk, fandt du det 55 af 58 undersøgelser for automatisk kønsidentifikation med autolearning antaget en binær gener output. I denne forstand, en potentiel vej for fremtidig forskning kunne være at erstatte vores binære klassificering algoritmer med et alternativ, da de kan have været automatiske læringsmodeller, der indrømmer kontinuerlige og / eller multitilære mål. I sådanne sammenhænge ville det være interessant at vurdere, om kønssufikser stadig har nogle fordele for identifikationen af genrer.
En yderligere begrænsning af vores tilgang er, at teksten måske ikke er tilgængelig i et stærkt betændt sprog, anderledes end engelsk. Ikke desto mindre, i så fald teksten kunne oversættes automatisk fra spansk til russisk eller andre sprog med lignende egenskaber gennem Automated Services. Den oversatte version af teksten kan give yderligere kønsinformation, der gør det muligt at optimere klassifikationspræstation. På samme måde er der behov for mere forskning for at bekræfte, at disse indledende resultater, der sammenligner spansk og engelsk, kan kopieres med dataindtastning til alternative sprog.
5.4.4 Innovation
I denne forskning, har vi et nyt stop kriterium for støtte vektor optimering algoritmer baseret på de geometriske egenskaber af tekst indhold vektoriel repræsentation med henblik på at løse automatiseret køn identifikation problem. For dette særlige problem, viser vi, at den foreslåede algoritme kræver mindre tid til træning, hvis sammenlignet med anvendelse af standard SVM algoritmer. Med hensyn til rammerne, i stedet for at følge konventionelle normaliseringsprocedurer i tekst minedrift, der eliminerer kønsmæssige udfordringer såsom henvisning vi bevare disse morfologiske elementer fundet med stærkt udsatte sprog og få dem optimeret deres ydeevne. Vi vurderer, hvor effektivt denne nye tilgang kan sættes i form af uddannelse gange ved at sammenligne forskellige autolearning algoritmer til klassificering, ved hjælp af et biografisk input datasæt. DATASET-TH-001 og spansk.
Vores resultater tyder på, at undgå en henvisning (stammer) til forbehandling af tekst til sprog, herunder yderligere elementer med kønsinformation, såsom spansk og så videre. Denne procedure skift påvirkede ikke andre neutrale sprog som engelsk.